Un modèle peut suivre correctement l’historique et mal soutenir la prochaine décision. Il a parfois appris les particularités des observations disponibles, sans représenter le phénomène que l’équipe veut comprendre. Pour un jumeau numérique enrichi par l’IA, je propose de rendre explicites le contrat de données, les hypothèses de modélisation et les situations dans lesquelles le résultat doit être écarté.
Cet article s’adresse aux équipes data, aux architectes et aux responsables de projets industriels. Il complète ma méthode de validation du domaine d’une simulation physique IA en se concentrant sur la construction et la calibration d’un système relié au réel. Les exemples sont pédagogiques ; ils ne constituent pas des résultats obtenus sur une installation cliente.
Par quoi commencer la modélisation d’un jumeau numérique ?
Commencez par la décision, les entités nécessaires et les variables observables. Le modèle ne doit pas être plus détaillé que ce que l’équipe peut alimenter et vérifier. Il doit cependant inclure les dépendances qui peuvent changer la conclusion.
Supposons un exemple fictif de ligne de traitement. La décision consiste à comparer deux séquences de production. Il faut connaître les opérations, leurs dépendances, les ressources et les conditions de disponibilité. Un dessin détaillé des bâtiments ne résout pas le manque d’information sur les temps de changement de série.
La documentation des modèles DTDL d’Azure Digital Twins montre comment décrire des types d’entités et leurs éléments. Ce langage structure une représentation ; il ne constitue pas, à lui seul, un modèle de prédiction physique. Cette distinction empêche d’attribuer au graphe des capacités qui doivent être construites séparément.
Je recommande un dossier court de modélisation : question servie, entités, variables, relations, hypothèses et exclusions. Pour chaque variable, l’équipe indique si elle est mesurée, calculée ou estimée. Ce document sert ensuite à discuter une anomalie avec le métier sans devoir commencer par expliquer le code.
Comment définir un contrat de données exploitable ?
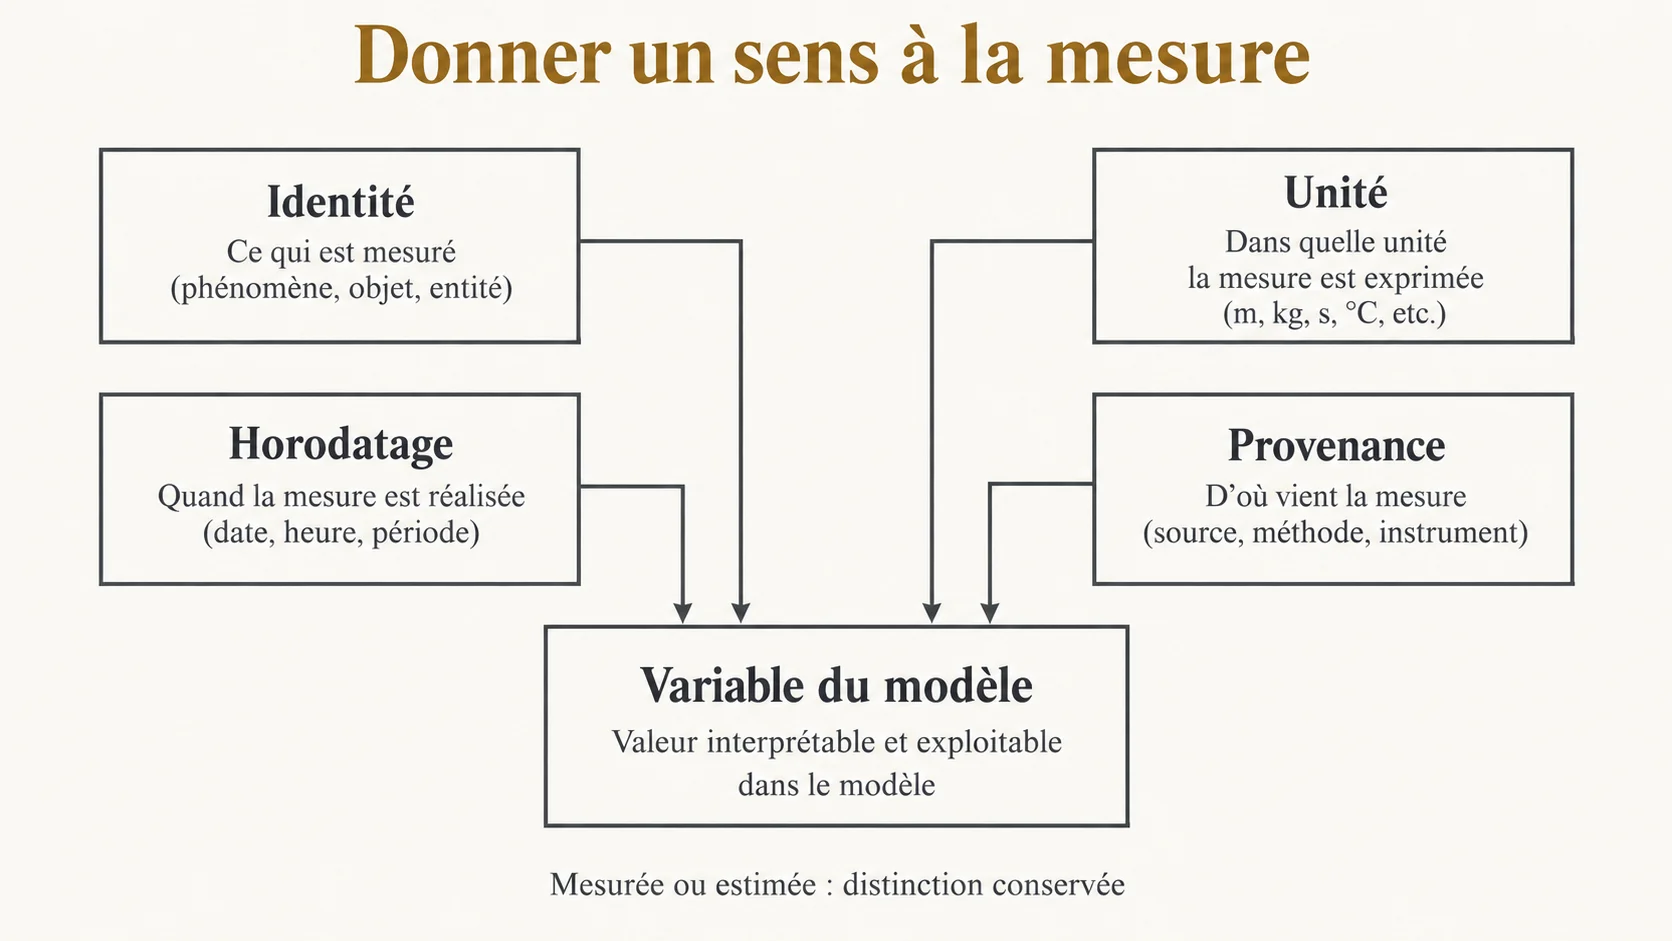
Le contrat précise le sens de la donnée, son unité, sa source et son état de validité. Une valeur numérique seule ne permet pas de distinguer une mesure récente, une dernière valeur connue et une estimation reconstruite. Le modèle doit pouvoir faire cette distinction.
Prenez une température. Son unité, son point de mesure et son horodatage sont nécessaires. Une valeur en degrés Celsius et une valeur en kelvins peuvent partager le même type informatique tout en décrivant des nombres très différents. Une conversion doit être définie à la frontière du système et testée avec des exemples explicites.
L’absence de mesure possède aussi un sens. Il faut choisir entre abstention, maintien d’un état ancien ou reconstruction, selon l’usage. Si la reconstruction est autorisée, elle reste signalée et sa méthode est versionnée. Une donnée corrigée silencieusement empêche de comprendre pourquoi le modèle a produit une recommandation inhabituelle.
L’identité de l’équipement doit survivre aux changements techniques : remplacement d’un capteur, nouvelle passerelle, renommage d’une application. Sans rapprochement contrôlé, l’historique de deux objets peut être mélangé. Les erreurs qui en résultent paraîtront parfois être des phénomènes physiques alors qu’elles proviennent du système d’information.
Quelle différence entre calibration et validation ?
La calibration règle les paramètres ; la validation examine le comportement sur des observations indépendantes pour l’usage prévu. Employer exactement les mêmes données pour les deux étapes ne permet pas d’évaluer correctement la capacité du modèle à fonctionner au-delà des exemples qui ont servi au réglage.
Le travail du NIST sur la crédibilité des jumeaux numériques relie vérification, validation et quantification de l’incertitude à l’évaluation de leur adéquation. Dans ma proposition de recette, le dossier indique ce qui a été ajusté, sur quelles observations et quelles données ont été gardées à l’écart.
Pour une série temporelle, je recommande de regarder les régimes de fonctionnement et les changements de conditions, plutôt que de répartir des lignes au hasard sans examiner leur dépendance. Des observations très proches peuvent porter presque la même information. Une séparation apparemment indépendante peut alors laisser fuiter les caractéristiques de la période testée.
Les critères doivent précéder l’ajustement. Choisir après coup la métrique qui favorise le résultat transforme une évaluation en justification. L’équipe définit plutôt les erreurs qui modifieraient la décision métier, les cas sensibles et la référence simple à battre. Cette référence peut être une règle existante ou un modèle déjà exploité.
Où placer un modèle IA dans l’architecture ?
Placez-le sur une fonction définie : estimation, détection, approximation de calcul ou assistance à l’analyse. Mélanger ces usages sous un intitulé unique rend la recette difficile. Un modèle qui estime une variable ne possède pas automatiquement le droit de modifier une consigne.
Un modèle de substitution peut approximer le résultat d’un calcul plus coûteux. Il faut comparer cette approximation au modèle de référence dans un domaine connu. Si l’équipe souhaite utiliser l’approximation en dehors de ce domaine, elle doit produire des preuves supplémentaires. Le fait qu’une sortie conserve une forme plausible ne suffit pas.
Un assistant en langage naturel peut expliquer les hypothèses du modèle et retrouver des documents. Pour rester utile, il doit citer les éléments réellement disponibles, distinguer observation et hypothèse et savoir signaler une information absente. Les problèmes de récupération documentaire et de droits subsistent même lorsque le sujet du document est industriel.
L’architecture conserve donc des frontières : données, représentation, calcul, explication et action. Chaque frontière possède un contrat. Il devient possible de corriger le composant fautif sans attribuer toutes les erreurs au modèle génératif qui apparaît à l’écran.
Comment tester les scénarios hors domaine ?
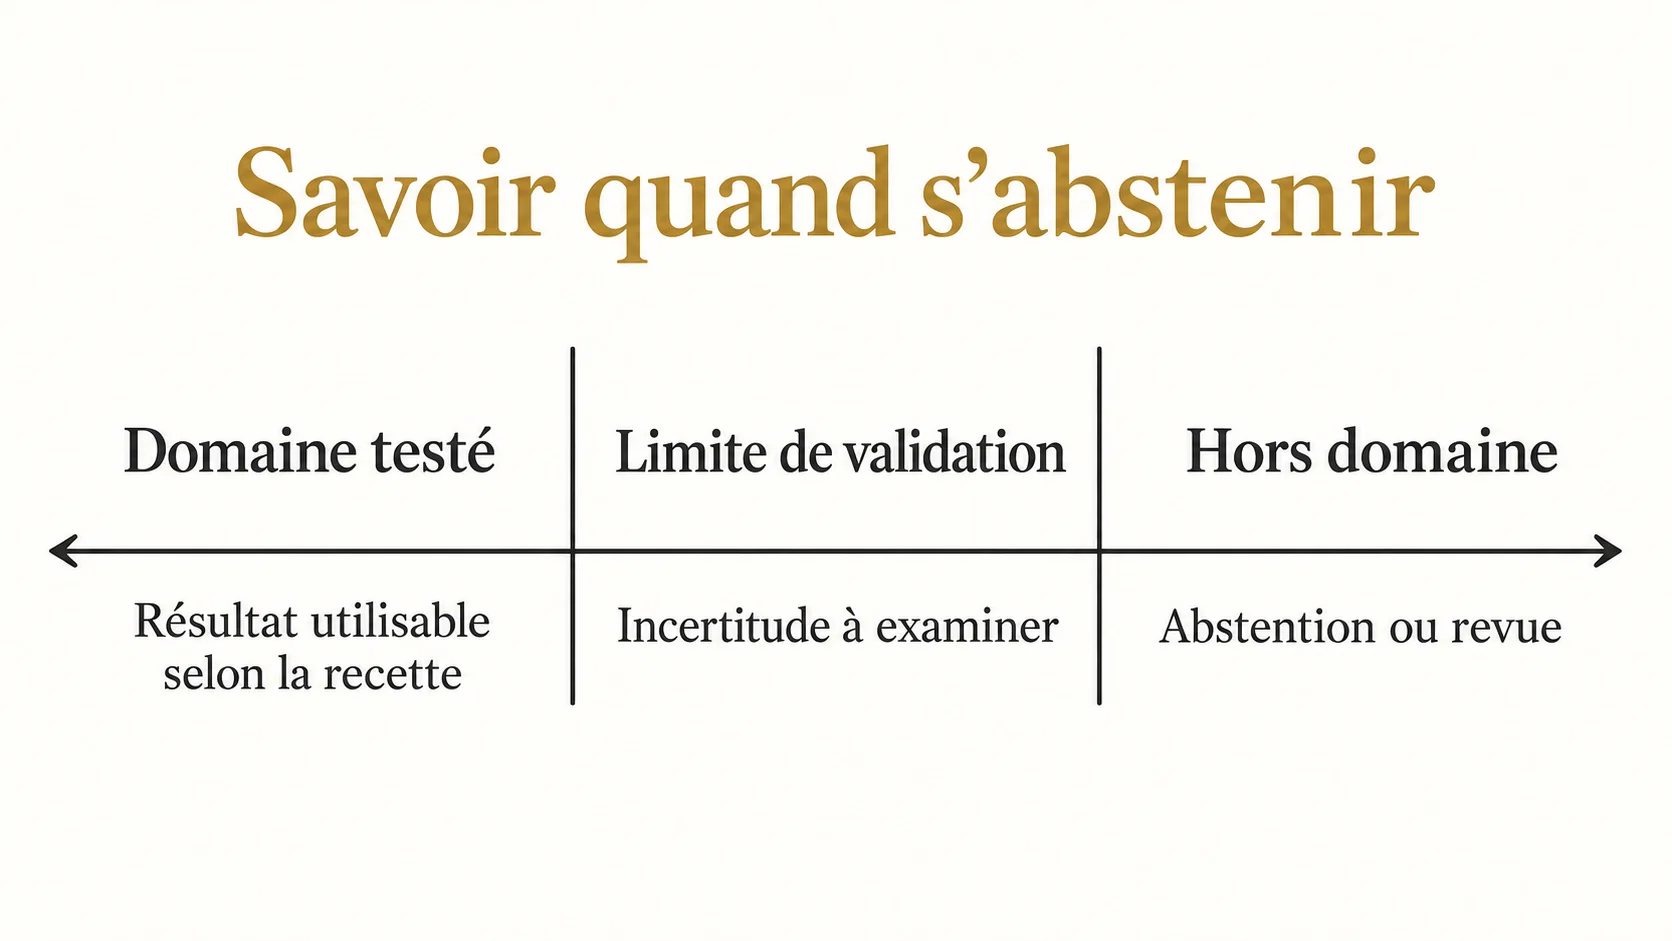
Le test doit vérifier que le système signale sa limite avant de soutenir une décision avec un résultat non validé. Un modèle peut rester exact dans un régime et se dégrader lorsque la matière, la charge ou les conditions environnementales changent.
Je propose de conserver un inventaire des dimensions importantes : plage des variables, configurations connues, disponibilité des capteurs et événements exceptionnels. Pour chaque dimension, le dossier précise le domaine testé. Cette description est plus informative qu’une affirmation générale de précision.
La recette introduit ensuite une valeur hors plage, une combinaison rare et une donnée manquante. Le résultat attendu n’est pas nécessairement un calcul. Il peut être une alerte de domaine, une demande de mesure complémentaire ou un retour au procédé de référence. Ce comportement doit être visible pour la personne qui prend la décision.
Il faut aussi tester les unités incorrectes et les mesures trop anciennes. Ces défauts appartiennent à la qualité des entrées, mais peuvent provoquer un résultat numérique parfaitement formé. Une vérification de type informatique ne les détecte pas toujours. Le contrôle doit porter sur le sens de la donnée et sur son usage.
Comment présenter l’incertitude sans tromper le lecteur ?
Présentez ce qui a été estimé, la méthode employée et les conditions de validité. Un intervalle graphique sans explication peut donner une impression de rigueur sans permettre d’en comprendre la portée. L’incertitude des mesures, celle des paramètres et l’erreur de représentation ne sont pas identiques.
Un indicateur de confiance produit par un modèle n’est pas automatiquement une probabilité calibrée d’exactitude. Si une valeur possède ce sens, il faut pouvoir décrire l’évaluation qui l’établit. Sinon, utilisez un libellé qui reflète ce qu’elle mesure réellement et évitez les pourcentages interprétés comme une garantie.
Pour une comparaison de scénarios, demandez si l’ordre des options reste stable lorsque les hypothèses raisonnables varient. Si une faible variation inverse le classement, la décision doit intégrer cette fragilité. Un résultat central seul masquerait précisément l’information importante.
Le rapport NIST sur la sécurité et la confiance dans les jumeaux numériques élargit l’analyse au système et à ses échanges. La confiance dans un calcul ne dispense pas de vérifier l’origine des données ou les accès permettant de modifier le modèle.
Comment maintenir le modèle après le pilote ?
Le modèle doit être réexaminé lorsque les données, l’installation ou la décision servie changent. Une calibration validée à un instant donné ne garantit pas une adéquation permanente. L’exploitation doit prévoir les événements qui déclenchent une nouvelle recette.
Je recommande un registre des versions et des interventions : modèle, paramètres, contrat de données, installation représentée et résultats de validation. Le registre ne doit pas devenir une archive indiscriminée de données sensibles. Il conserve les éléments nécessaires pour comprendre le changement et reproduire le test.
Le suivi compare régulièrement observations et estimations sur les cas disponibles. Une dérive déclenche une analyse : données erronées, nouvelle condition physique, modification de configuration ou approximation devenue insuffisante. Réentraîner immédiatement peut masquer une erreur d’unité ou un capteur défectueux au lieu de la corriger.
Un audit IA peut organiser ce diagnostic et ses preuves. Lorsque la recommandation alimente un workflow, mon approche de la recette UiPath complète le contrôle : une prédiction convenable peut encore être exécutée deux fois ou utilisée avec de mauvais droits. Le passage du modèle à l’action exige sa propre validation.
Questions fréquentes
Un graphe DTDL est-il un simulateur physique ?
Non. Il décrit des types, des propriétés et des relations utilisés dans une représentation. Les calculs physiques, les modèles appris et leur validation relèvent de composants et de travaux complémentaires.
Peut-on valider avec les données de calibration ?
Elles permettent d’examiner l’ajustement, mais ne suffisent pas à établir la capacité du modèle à fonctionner sur des observations indépendantes. Le protocole doit réserver des cas et des conditions pertinents pour l’usage visé.
Que faire lorsqu’une entrée sort du domaine testé ?
Le système doit signaler sa limite et appliquer le comportement prévu : abstention, méthode de référence ou revue. Une extrapolation non évaluée ne doit pas devenir une recommandation fiable par défaut.
Sources
Sources consultées le 8 octobre 2026. Les critères et exemples constituent une proposition de méthode d’Anand Candassamy. Ils doivent être adaptés au système, à la décision et aux contraintes d’exploitation.