Résumé
Objectif : sortir des essais et livrer un usage réutilisable, cadré et mesuré.
Ce que vous pouvez réutiliser
- Une liste de cas d’usage
- Une grille d’évaluation de la qualité
- Une liste de vérification pour la confidentialité
Accomplissements liés
Une méthode éprouvée sur le terrain. Plus de 2800 heures de formation dispensées.
Comment choisir deux usages sans multiplier les prototypes ?
Choisissez deux tâches récurrentes dont les résultats peuvent être vérifiés par les personnes qui les réalisent déjà. Une liste d’idées n’est pas encore un portefeuille de projets. Pour chaque tâche, décrivez la fréquence, les données mobilisées, le temps consacré et la manière de reconnaître un résultat acceptable.
Un exemple fictif permet de clarifier la sélection : préparer un compte rendu interne et rédiger un premier brouillon de réponse au support. Les deux tâches peuvent sembler similaires, mais le second usage engage davantage la relation client. Il exige une validation, des informations à jour et un circuit de correction. Les deux projets ne doivent donc pas recevoir le même niveau d’autonomie par défaut.
La formation IA en entreprise peut servir à observer ces tâches avec leurs utilisateurs. Le but est de choisir des cas que l’équipe pourra réellement maintenir. Écartez provisoirement les idées dont personne ne possède les données ou ne peut évaluer la sortie : leur difficulté ne se résoudra pas en changeant simplement de modèle.
Que faut-il cadrer pendant la première semaine ?
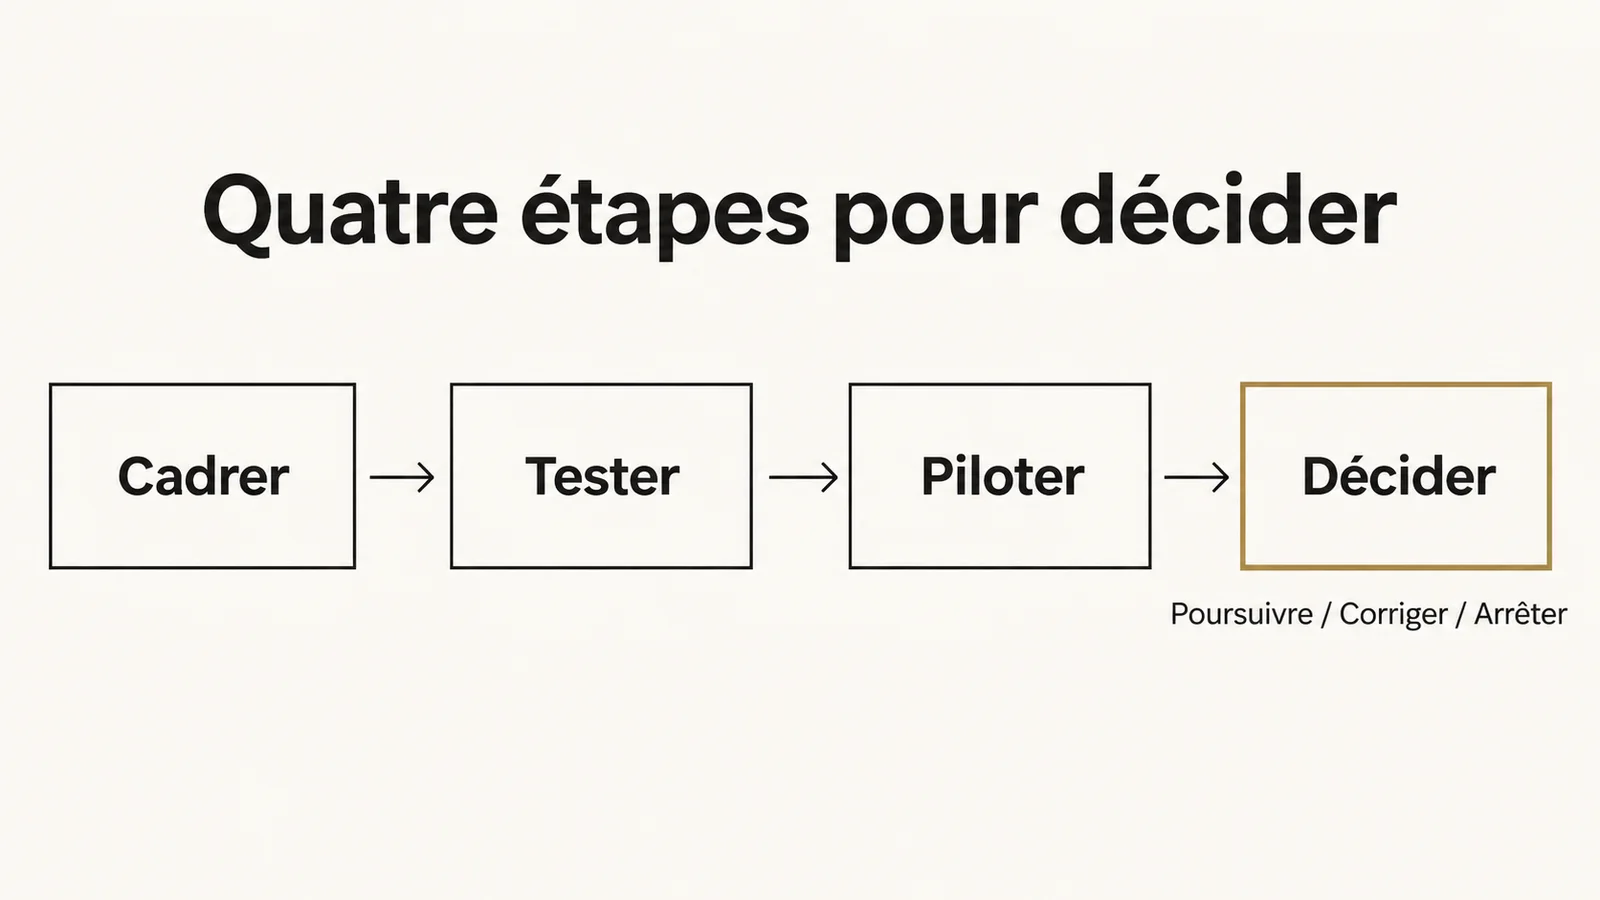
La première semaine sert à fixer le périmètre, les responsabilités et les critères de réussite. Le calendrier proposé ici organise le travail ; il ne garantit pas qu’un usage complexe sera industrialisé en quatre semaines. Certaines dépendances de sécurité, d’achat ou de qualité documentaire peuvent imposer un délai supplémentaire.
Rédigez une fiche par usage avec cinq éléments : entrée autorisée, résultat attendu, responsable de validation, données exclues et critère d’arrêt. Ajoutez quelques exemples réels anonymisés lorsque cela est possible, ou des cas fictifs représentatifs lorsque le traitement des données n’est pas encore encadré. Notez les situations où l’outil doit demander une précision au lieu de produire un résultat.
Le profil de risques du NIST pour l’IA générative rappelle l’intérêt d’adapter la gestion des risques au contexte. Dans la pratique, une équipe doit pouvoir expliquer qui décide d’ouvrir le test et qui peut le suspendre. Ce cadrage fait partie de l’audit IA, au même titre que les essais techniques.
Comment construire un premier essai qui apprend quelque chose ?
Un premier essai utile permet de comprendre pourquoi un résultat réussit ou échoue. Il faut conserver la consigne, les documents utilisés et la sortie obtenue. Si plusieurs paramètres changent entre deux essais, leur comparaison ne permet plus d’identifier ce qui a amélioré la réponse.
La deuxième semaine peut être consacrée à une version simple du parcours. Évitez de connecter immédiatement toutes les applications de l’entreprise. Commencez par une entrée contrôlée et une sortie relue, puis ajoutez les intégrations nécessaires une fois le comportement compris. Pour un assistant documentaire, le tutoriel Microsoft d’évaluation RAG montre notamment comment distinguer la recherche du bon document de la production d’une réponse fondée sur ce document.
Conservez une partie des cas de test pour une évaluation ultérieure. Si toutes les corrections sont faites sur les mêmes exemples, le prototype peut finir par les réussir sans mieux traiter de nouvelles demandes. L’objectif est de tester sa capacité à répondre à des situations comparables, pas de mémoriser une démonstration.
Quels indicateurs faut-il suivre pendant le pilote ?
Suivez la qualité finale, le temps total de traitement et les erreurs qui rendent l’usage inacceptable. Le nombre de textes générés est une mesure d’activité, pas une preuve de valeur. Une réponse produite en quelques secondes peut nécessiter plusieurs minutes de vérification ou introduire une erreur difficile à repérer.
La troisième semaine peut réunir un groupe restreint d’utilisateurs. Mesurez séparément le temps de préparation, de génération, de relecture et de correction. Demandez aux participants de signaler les cas qu’ils auraient traités autrement sans l’outil. Cette comparaison aide à identifier une charge déplacée plutôt qu’un gain réel.
La documentation Microsoft sur la transparence d’AI Search décrit une évaluation combinant notamment pertinence, sécurité, latence et coût pour ses configurations de recherche. Votre grille doit rester adaptée à votre tâche. Pour des documents internes, ajoutez les tests de droits d’accès du lecteur : la qualité d’une réponse ne justifie jamais l’accès à un document interdit.
Que doit contenir la décision de fin de quatrième semaine ?
La décision de fin de cycle doit dire si l’usage est poursuivi, corrigé ou arrêté, avec les raisons et les conditions associées. Une présentation réussie ne vaut pas une décision de mise en production. Les résultats doivent être lisibles par un responsable qui n’a pas participé aux essais.
Rassemblez le périmètre testé, les volumes observés, les erreurs, le coût de fonctionnement et le temps de supervision. Décrivez aussi les dépendances : fournisseur, données, comptes techniques, version de modèle et personne capable de maintenir la configuration. Si une dépendance reste inconnue, indiquez ce qu’elle empêche de conclure.
La suite peut être un pilote plus long plutôt qu’une généralisation immédiate. Un usage adopté par quelques personnes doit encore être éprouvé face à davantage de documents, à des profils différents et aux incidents ordinaires. Préparez une procédure de retour au processus précédent. La réussite du cycle se mesure aussi à la qualité d’une décision d’arrêt : elle évite de transformer un prototype fragile en obligation de fonctionnement permanent.
Questions fréquentes
Quatre semaines garantissent-elles une mise en production ?
Non. Ce calendrier propose un cycle de cadrage, d’essai et de décision. Il peut aboutir à un pilote prolongé ou à un arrêt justifié. Les intégrations, les données, les validations de sécurité et les contraintes métier peuvent demander plus de temps. La décision doit suivre les preuves disponibles, et non une promesse de généralisation à une date arbitraire.
Doit-on commencer avec un agent autonome ?
Pas nécessairement. Si une étape de rédaction ou de recherche apporte déjà une valeur mesurable, un assistant supervisé peut suffire. Une autonomie supplémentaire ajoute des effets à contrôler, notamment lorsque l’outil écrit dans une application. Commencez par la capacité utile la plus simple, puis augmentez le périmètre uniquement lorsque les droits, les tests et les procédures de reprise sont établis.
Comment comparer le travail avec et sans IA ?
Comparez des tâches équivalentes et mesurez le temps total, y compris la préparation et les corrections. Définissez une même grille de qualité pour les deux parcours. Documentez les différences de complexité entre les cas afin de ne pas attribuer à l’outil un gain lié à des tâches plus faciles. Signalez les limites de l’échantillon plutôt que de généraliser un résultat isolé.