Que change GPT-4, et que ne change-t-il pas, pour les documents d’entreprise ?
GPT-4 apporte la multimodalité et un raisonnement nettement supérieur, mais il arrive avec une fenêtre de 8 000 jetons : environ quinze pages. C’est la contrainte qui va structurer toutes les architectures d’entreprise des dix-huit mois qui viennent, et c’est celle dont on parle le moins.
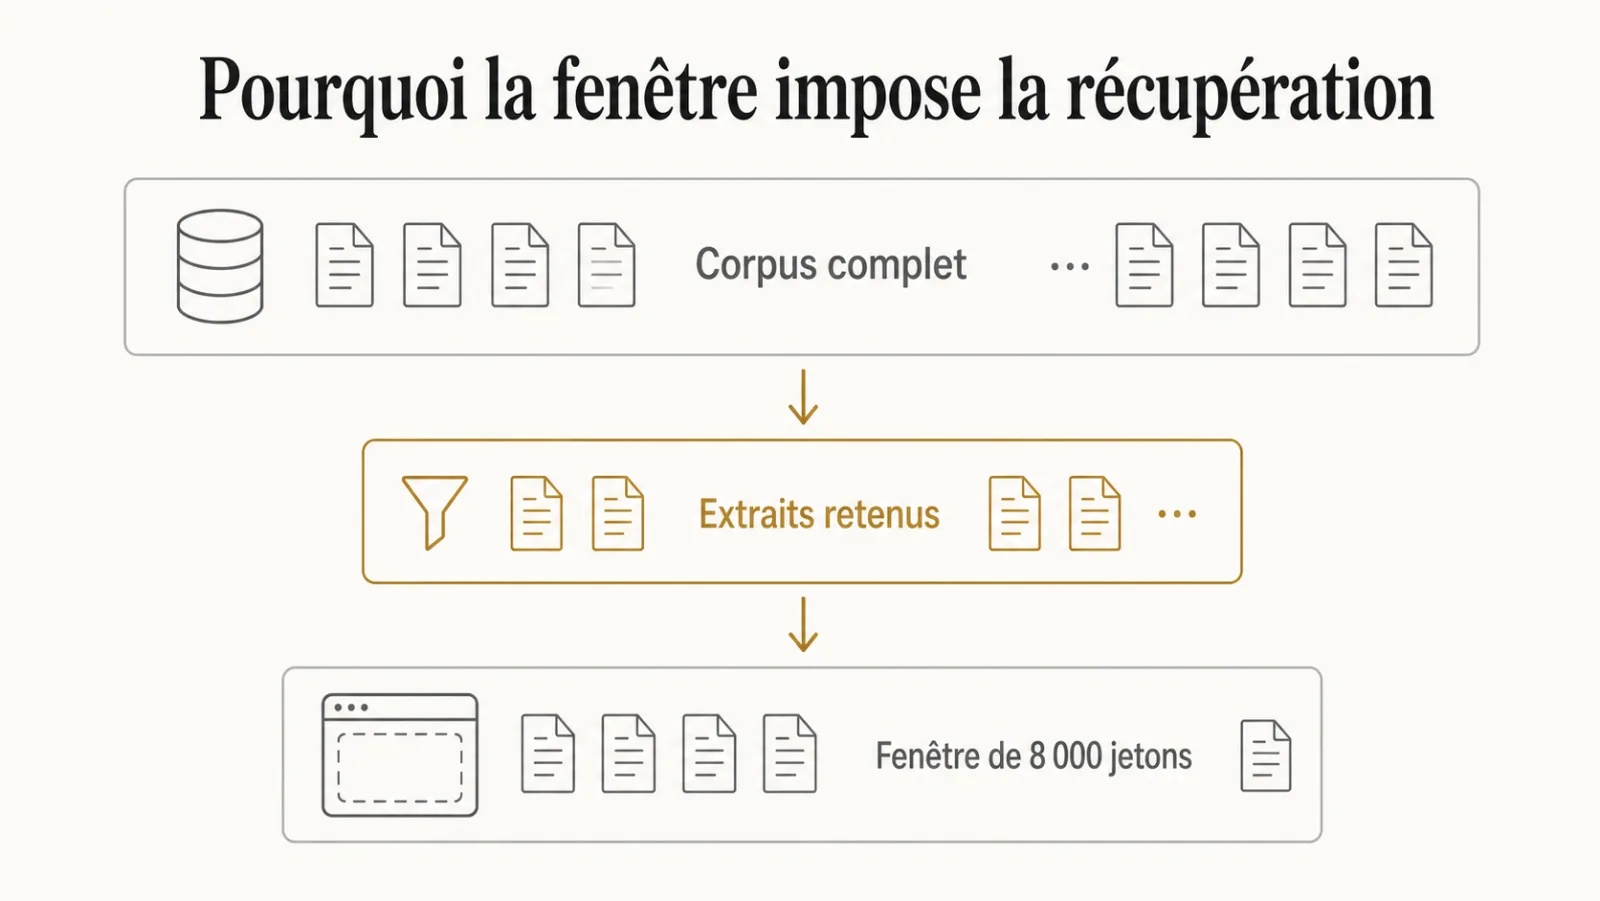
La fenêtre de contexte est la quantité maximale de texte qu’un modèle peut lire en une seule fois : la consigne, les documents fournis, la question et la réponse qu’il produit. Elle se mesure en jetons, des fragments de mots sur lesquels le modèle travaille ; en français, un jeton correspond en moyenne à un peu moins d’un mot. Tout ce qui dépasse la fenêtre n’existe pas pour le modèle.
Quinze pages, c’est moins qu’un contrat cadre, moins qu’une procédure qualité complète, très loin d’un corpus documentaire. Aucune organisation ne peut donc « donner ses documents au modèle ». Il faut choisir quoi lui donner, à chaque question, et ce choix est un problème d’ingénierie à part entière.
La démonstration publique masque cette contrainte parce qu’elle porte sur des cas courts : un texte collé, une image, un exercice. Dès qu’on branche un corpus réel, la limite se manifeste immédiatement : sous forme d’erreur de dépassement, ou pire, sous forme de troncature silencieuse où le modèle répond sans la moitié du contexte.
Pourquoi le choix des extraits à fournir au modèle ne peut-il pas se faire à la main ?
Sélectionner les bons extraits pour chaque question est un problème de recherche, pas de rédaction, et il cesse d’être faisable à la main dès que l’utilisateur ignore quel document contient la réponse. La tentation initiale, coller le document pertinent dans le prompt, fonctionne pour une démonstration et s’effondre dès qu’on ne sait plus lequel est pertinent.
C’est exactement le point où naît la récupération documentaire : indexer le corpus une fois, retrouver les passages utiles à chaque question, ne donner au modèle que ceux-là. On la désigne souvent par son sigle anglais, RAG, pour retrieval-augmented generation. L’architecture complète est décrite dans le RAG, la seule architecture qui tienne.
La conséquence organisationnelle est plus lourde qu’il n’y paraît. Le système ne peut être bon que si le corpus l’est, et un corpus d’entreprise contient presque toujours trois versions d’une même procédure, dont deux périmées. Le modèle n’a aucun moyen de savoir laquelle fait autorité. C’est une décision humaine, développée dans le corpus est le projet.
Comment fonctionne la récupération documentaire, étape par étape ?
La récupération documentaire fonctionne en deux temps : une préparation du corpus faite une fois, puis une recherche des passages pertinents répétée à chaque question avant l’appel au modèle. Chaque étape a ses propres réglages et ses propres erreurs.
- Inventorier le corpus : formats, volumes, dates, documents en vigueur et documents périmés.
- Extraire le texte de chaque document, y compris des documents numérisés, et le nettoyer des en-têtes et pieds de page répétés.
- Découper chaque document en passages qui conservent leur sens : une clause avec sa condition, une section avec son titre.
- Indexer ces passages avec leurs métadonnées : document d’origine, date, droits d’accès.
- À chaque question, rechercher les passages les plus proches, en ne cherchant que dans ceux que l’utilisateur a le droit de lire.
- Construire la consigne : la question, les quelques passages retenus, l’instruction de répondre uniquement à partir d’eux et de citer leur origine.
- Afficher la réponse avec ses sources, pour que l’utilisateur puisse vérifier.
Un exemple générique : un juriste demande quel est le délai de préavis dans les contrats d’un fournisseur donné. Le système ne lit pas tous les contrats ; il retrouve les trois clauses de résiliation concernées, les transmet au modèle avec la question, et affiche la réponse accompagnée des références des trois contrats.
Quelles conséquences immédiates la fenêtre de 8 000 jetons a-t-elle pour une équipe ?
- Le découpage devient un choix d’ingénierie. Couper tous les mille caractères sépare une clause de sa condition et rend la réponse fausse sans qu’aucune erreur ne s’affiche. Voir découper un document.
- Les droits d’accès doivent être filtrés avant la recherche. Filtrer après revient à laisser le système lire ce qu’il n’a pas le droit de lire, puis masquer le résultat, ce qui n’est pas une protection.
- Le coût devient proportionnel au contexte envoyé. Envoyer vingt extraits quand cinq suffisent multiplie la facture et dégrade souvent la réponse, l’information utile se noyant dans le bruit.
- La citation des sources devient possible. C’est le bénéfice inattendu : puisqu’on sait exactement quels extraits ont été fournis, on peut les afficher, et l’utilisateur peut vérifier.
Faut-il coller le document dans le prompt ou mettre en place une récupération ?
Coller le document dans le prompt convient tant que l’utilisateur sait quel document contient la réponse et que ce document tient dans la fenêtre ; au-delà, seule la récupération documentaire tient. Le choix se fait sur quelques critères simples.
| Critère | Coller le document | Récupération documentaire |
|---|---|---|
| Taille du contenu | Tient dans quinze pages | Dépasse la fenêtre, souvent de plusieurs ordres de grandeur |
| Qui choisit le document | L’utilisateur, qui sait où chercher | Le système, à partir de la question |
| Fréquence de mise à jour | Document stable ou ponctuel | Corpus qui évolue chaque semaine |
| Droits d’accès | Gérés par l’utilisateur lui-même | À appliquer automatiquement avant la recherche |
| Citation des sources | Implicite, un seul document | Nécessaire, plusieurs documents possibles |
| Effort initial | Nul | Indexation, découpage, jeu de tests |
La colonne de gauche correspond à un usage individuel, celui de l’essai personnel décrit dans ce que ChatGPT a changé en comité de direction. La colonne de droite correspond à un service rendu à toute une équipe. Passer de l’un à l’autre n’est pas une évolution progressive : c’est un changement d’architecture.
La multimodalité de GPT-4 est-elle utile en entreprise ?
Sur les corpus réels que je rencontre, la lecture d’images de GPT-4 sert surtout à traiter les documents scannés, un usage modeste mais à forte valeur. C’est loin de l’usage spectaculaire montré en démonstration.
Un corpus d’entreprise contient toujours une proportion de PDF images : contrats signés puis numérisés, courriers reçus, plans, formulaires remplis à la main. Jusqu’ici ils étaient invisibles à la recherche, ou dépendaient d’une reconnaissance optique médiocre qui produisait un texte truffé d’erreurs. Pouvoir les faire lire directement change leur statut : ils redeviennent interrogeables.
Mais attention au coût. Une page image consomme beaucoup plus de jetons qu’une page texte, et la facture s’en ressent immédiatement. Sur un corpus mixte, il reste préférable d’extraire le texte une seule fois à l’indexation plutôt que d’envoyer l’image à chaque question. La multimodalité devient alors un outil de préparation du corpus, pas un mode d’interrogation.
Le réflexe à prendre dès maintenant
Mesurer la taille réelle du corpus avant de concevoir quoi que ce soit. Un dossier partagé de trois giga-octets ne tiendra jamais dans une fenêtre, quelle que soit son évolution, et la fenêtre grandira moins vite que le corpus.
Quelles questions poser au cadrage d’un projet documentaire avec GPT-4 ?
Au cadrage d’un projet documentaire, je pose trois questions avant d’écrire une ligne de code, et elles portent toutes sur le corpus, pas sur le modèle. Quel est le volume réel, en nombre de documents et en formats. Qui décide qu’un document fait autorité. Et quels droits d’accès existent, sous une forme exploitable par une machine.
Sans ces réponses, la fenêtre de contexte, 8 000 jetons aujourd’hui, davantage demain, reste un faux problème : ce qui bloquera n’est pas la taille de la fenêtre, c’est l’incapacité à choisir quoi y mettre.
J’ajoute une quatrième question, plus inconfortable : quelles questions le système devra-t-il refuser de traiter. Un système qui répond à tout répond mal à beaucoup, et le périmètre de refus doit être décidé au cadrage. C’est le sujet du refus de répondre comme fonctionnalité.
Ces quatre réponses tiennent en une page. Elles déterminent l’essentiel du coût, du délai et de la qualité du système, bien davantage que le choix du modèle, qui sera de toute façon remplacé deux fois dans l’année. C’est aussi la matière d’un audit IA préalable : un état des lieux du corpus et des droits, avant tout choix technique.
Quelles erreurs commettent les équipes qui découvrent la limite de contexte ?
Les équipes qui découvrent la limite de contexte de GPT-4 commettent trois erreurs récurrentes : tronquer sans le savoir, compenser par un modèle plus gros, et repousser la question des droits d’accès. Toutes trois se repèrent tôt si on les cherche.
- Tronquer sans le savoir. Une bibliothèque coupe automatiquement le texte qui dépasse, et le modèle répond sur une moitié de document. La parade : mesurer le nombre de jetons envoyés à chaque appel et le journaliser.
- Attendre une fenêtre plus grande. Repousser la conception en espérant que la limite disparaisse. Le corpus grandira toujours plus vite que la fenêtre, et le coût suit ce qu’on envoie.
- Résumer le corpus pour le faire tenir. Un résumé perd précisément les détails, chiffres et exceptions, que les utilisateurs viennent chercher.
- Traiter les droits d’accès à la fin. Un index construit sans droits doit être reconstruit quand on les ajoute.
- Juger sur trois questions. Évaluer le système sur les exemples de la démonstration plutôt que sur un jeu de questions réelles, préparées avec les futurs utilisateurs.
Questions fréquentes
Combien de pages représentent 8 000 jetons ?
Environ quinze pages de texte courant, consigne et réponse comprises. La place réellement disponible pour les documents est donc inférieure, puisque la question, les instructions et la réponse du modèle consomment une partie de la fenêtre.
Une fenêtre plus grande supprimera-t-elle le besoin de récupération ?
Non. Un corpus d’entreprise dépasse toujours la fenêtre, quelle que soit sa taille, et le coût croît avec ce qu’on envoie. Une grande fenêtre change la maille du découpage, pas la nécessité de choisir.
Combien d’extraits faut-il envoyer par question ?
En pratique, entre trois et huit sur la plupart des corpus documentaires. Au-delà, l’information utile se noie et la réponse se dégrade, tout en coûtant davantage. Le bon nombre se règle sur le jeu de tests, jamais au jugé.
Faut-il traiter les documents scannés séparément ?
Oui. Un texte issu de reconnaissance optique se découpe mal et se cherche mal. Il vaut mieux le repérer à l’indexation, le traiter à part, et savoir qu’il constituera une source d’erreurs identifiée plutôt qu’une surprise en production.
Peut-on se passer de récupération pour un petit corpus ?
Oui, si le corpus tient entièrement dans la fenêtre et n’évolue pas. C’est le cas d’une documentation produit de quelques pages. Dès que le corpus grandit ou change, la récupération redevient nécessaire, et l’avoir anticipée évite une réécriture.
Qu’est-ce qu’une troncature silencieuse ?
C’est le cas où le texte envoyé dépasse la fenêtre et où une partie est coupée sans message d’erreur visible. Le modèle répond alors avec assurance sur un contexte incomplet. Seule la mesure systématique du nombre de jetons envoyés permet de la détecter.