Résumé
Grok 4.6, publié par xAI, relance une question que chaque nouvelle génération de modèle pose aux entreprises : faut-il changer, et sur quelle preuve ? Un nouveau modèle d’IA change trois choses pour une organisation : la taille du travail traité en une seule passe, la capacité à exécuter des tâches sous supervision, et la lisibilité des coûts. Aucune de ces promesses ne se vérifie sur une fiche technique. Cet article les traduit en cinq tests à mener sur vos propres dossiers, et en décisions pour les équipes comme pour la direction.
Pourquoi c’est maintenant
La question n’est plus quel outil est le meilleur. Elle devient : quel travail faire gagner, à quel coût, avec quelles garanties. En 2025, on comparait des fiches techniques. En 2026, on compare des façons de travailler : relecture, transformation de dossiers, accompagnement, automatisation. Pour une direction, la fiche importe moins que ce que l’outil permet de construire, de mesurer et de contrôler.
Ce que ça change concrètement
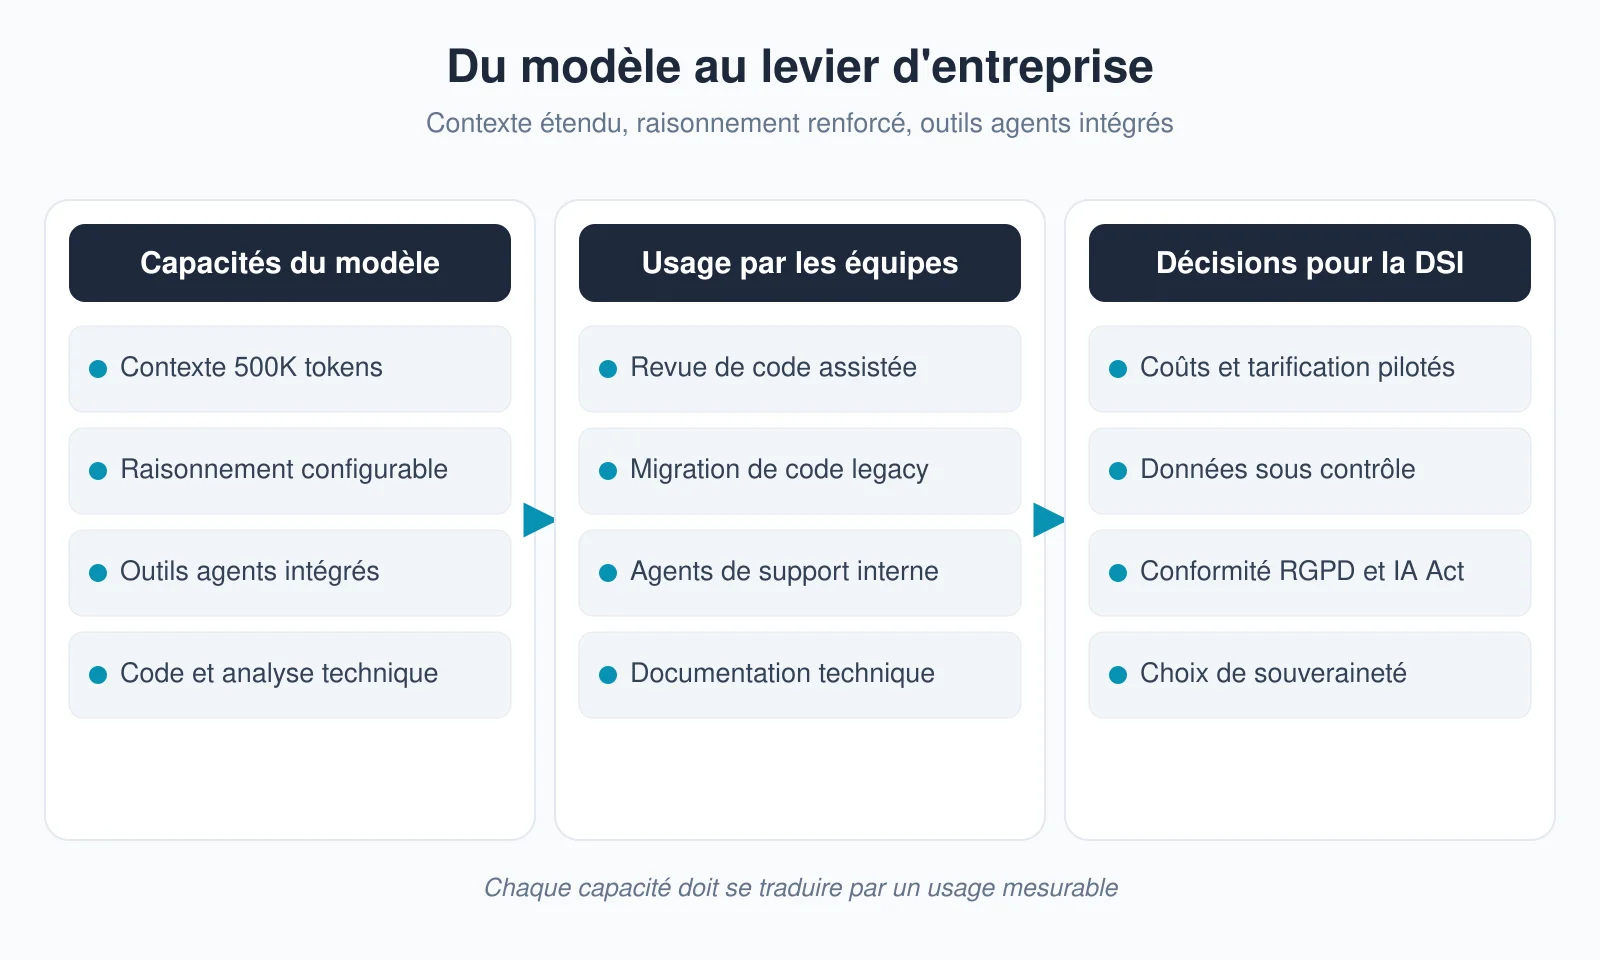
Le premier changement : un projet entier tient en une seule passe. Fini le découpage permanent du travail. On réunit l’ensemble et on pose la question.
Le deuxième changement : l’outil exécute. Il va chercher une information, prépare un résultat, vérifie. La différence entre une suggestion et une action, toujours sous supervision.
Le troisième changement : la lisibilité des coûts. Les prix se projettent dans un budget mensuel. La conversation avec la finance change de nature.
Ce que ça change pour vos équipes
Trois rituels évoluent. La relecture d’abord : l’outil couvre l’ensemble, l’humain arbitre. La transformation ensuite : un ancien dossier se convertit en étapes vérifiables une par une. L’automatisation enfin : les gestes répétés deviennent des flux supervisés, de la demande jusqu’au règlement.
La règle qui ne change pas : la validation. Un outil qui exécute se traite comme un collaborateur junior, avec relecture systématique, tests et traces. Le temps gagné se perd immédiatement si le contrôle disparaît. Le gain réel vient de la vitesse d’itération, pas de la délégation aveugle.
Ce que ça change pour la direction
Pour la direction, la question n’est pas quel outil choisir, mais comment l’adopter sans dette. Trois chantiers s’ouvrent.
Le budget : mesurer dès le premier jour. Des indicateurs par équipe, un coût par usage, des alertes quand un seuil est dépassé.
La conformité : classer ce qui peut sortir, ce qui reste chez vous, ce qui doit être anonymisé. La réponse n’est pas l’interdiction, c’est la clarté.
La souveraineté : garder la main sur les accès, les journaux et les fournisseurs. Changer d’outil reste une liberté.
Quels tests mener avant d’adopter un nouveau modèle comme Grok 4.6 ?
Cinq tests suffisent à décider, à condition de les mener sur vos dossiers et non sur les exemples de l’éditeur. Ils prennent deux à trois jours et réutilisent le même jeu de cas à chaque nouvelle sortie.
- Le jeu de cas réels. Trente questions tirées de l’usage effectif, dont un tiers de cas limites, avec la réponse attendue. C’est la seule mesure qui compare deux modèles sur votre travail. La méthode est décrite dans construire un jeu de tests en une journée.
- La passe longue. Un dossier complet soumis d’un bloc : le modèle retrouve-t-il l’information placée au milieu, ou seulement au début et à la fin ? Une grande fenêtre annoncée ne dit rien de la qualité de lecture.
- L’exécution supervisée. Sur un outil simulé, le modèle propose-t-il les bonnes actions, et s’arrête-t-il quand une autorisation manque ?
- Le coût par usage. Le prix au million de jetons ne suffit pas : mesurez le coût d’une tâche complète, contexte et raisonnement compris. Voir mesurer le coût par fonctionnalité.
- Les régressions. Les cas qui marchaient avec le modèle actuel marchent-ils encore ? Un gain moyen peut cacher une perte sur le cas le plus fréquent, comme le montre la recette de migration vers Sonnet 5.5.
Comment décider à partir des résultats ?
Un changement de modèle se justifie lorsqu’il améliore le jeu de cas sans régression sur les cas critiques, pour un coût par tâche égal ou inférieur. Le tableau ci-dessous fixe les seuils avant les essais, pas après.
| Ce que promet le modèle | Ce qu’il faut mesurer | Seuil de décision indicatif |
|---|---|---|
| Travail plus vaste en une passe | Taux de bonnes réponses sur dossiers longs | Au moins égal au découpage actuel |
| Exécution de tâches | Actions hors périmètre proposées sur outils simulés | Zéro sur les cas critiques |
| Coûts lisibles | Coût complet par tâche, sur 30 cas | Écart inférieur à 20 % de la projection |
| Meilleure qualité générale | Régressions sur les cas qui marchaient | Aucune sur les cas fréquents |
Si deux seuils sur quatre ne sont pas atteints, la bonne décision est d’attendre la version suivante. Changer de modèle a un coût propre : nouvelle recette, nouveaux prompts, nouvelle formation. Les annonces de performance se lisent avec la grille de comment lire une annonce de benchmark.
Ce que vous pouvez réutiliser
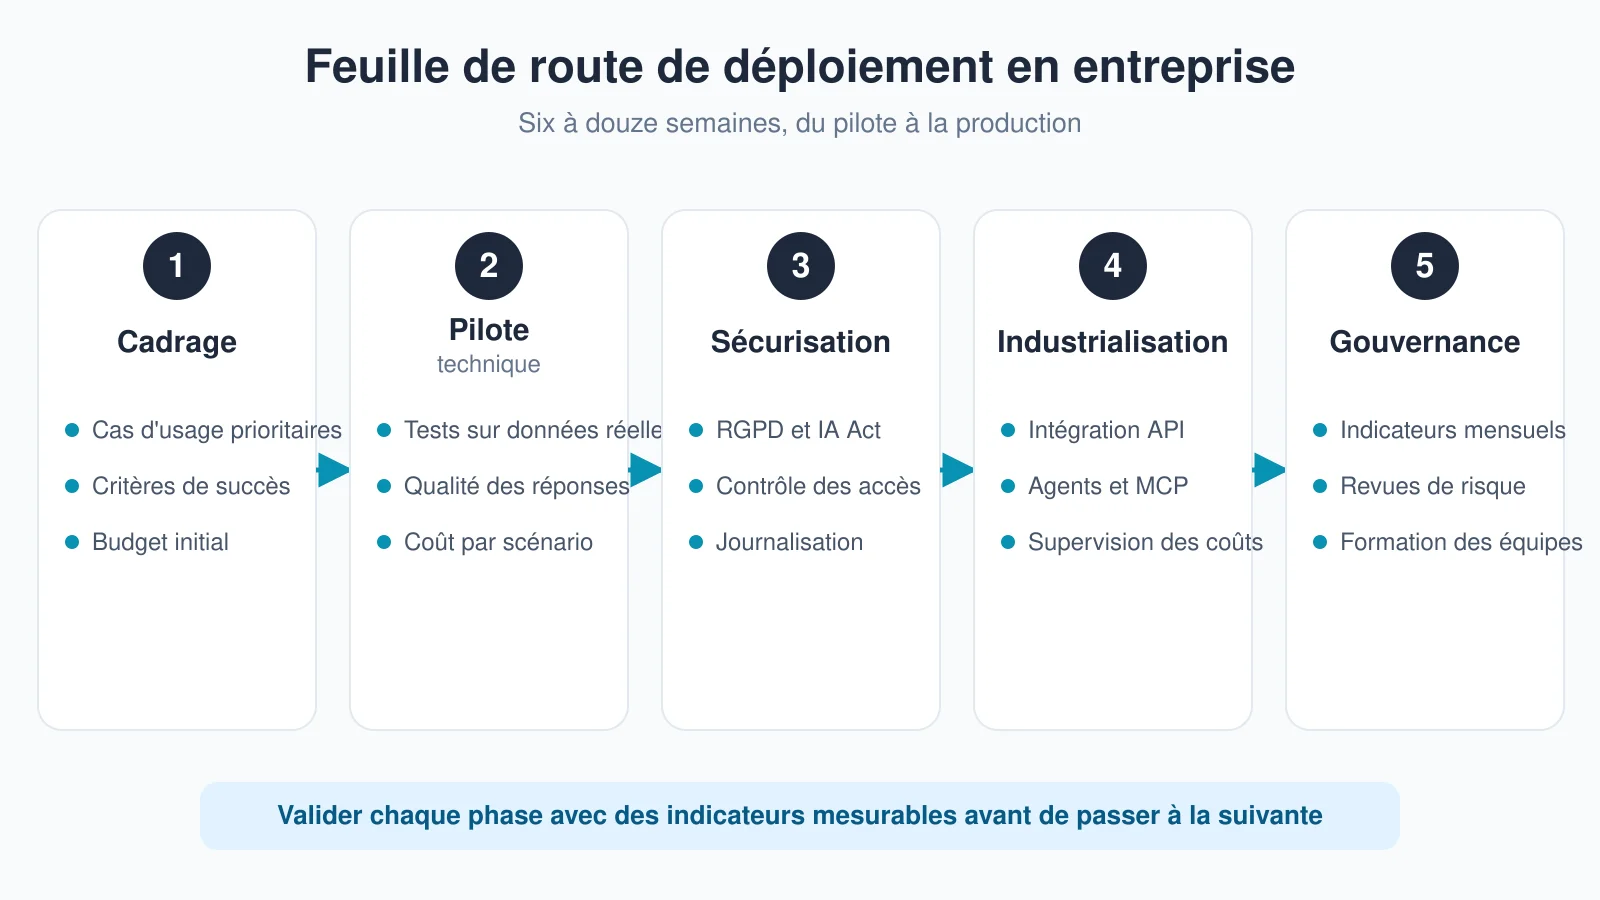
- Une grille de cadrage : les cas d’usage, les critères de succès mesurables, un budget par scénario, validés avant de commencer.
- Un protocole de pilote : des tests sur données réelles, une évaluation de la qualité, une mesure du coût par usage.
- Une liste de vérification : la classification des données, le contrôle des accès, la tenue des journaux, l’alignement RGPD et IA Act.
- Un socle de déploiement : l’intégration à vos outils, la supervision des coûts en continu.
- Un rythme de gouvernance : des indicateurs mensuels, des revues de risque, la formation des équipes, une décision documentée.
Questions fréquentes
Faut-il changer de modèle à chaque nouvelle sortie ?
Non. Un changement se justifie quand le nouveau modèle améliore votre jeu de cas réels sans régression, pour un coût par tâche égal ou inférieur. Sinon, attendre la version suivante coûte moins cher qu’une nouvelle recette.
Combien de temps faut-il pour évaluer un nouveau modèle d’IA ?
Deux à trois jours si un jeu de cas réels existe déjà. Sans ce jeu, comptez une journée de plus pour le constituer ; il resservira à chaque sortie.
Grok 4.6 est-il adapté à un usage en entreprise ?
Cela dépend de votre cas, de vos contraintes de données et de l’offre contractuelle disponible. Les cinq tests de cet article, menés sur vos dossiers, répondent à cette question mieux qu’un classement public.
Qui doit piloter l’évaluation : la DSI ou les métiers ?
Les deux. Les métiers fournissent les cas réels et jugent la qualité ; la DSI mesure le coût, la sécurité et l’intégration. Une évaluation menée par un seul côté produit soit un outil inutilisé, soit un outil non maîtrisé.
Conclusion
Un outil d’IA se juge comme un outil de production : des cas précis, des coûts mesurés, des garanties vérifiables. Les équipes qui gardent la validation humaine gagnent en vitesse sans perdre en contrôle. Les directions qui mesurent, classent et gouvernent dès maintenant seront prêtes pour la suite, quel que soit le fournisseur.
Pour structurer cette évaluation, un regard extérieur aide à éviter les angles morts. C’est le travail d’un Forward Deployed Engineer : faire passer une capacité technique à un processus maîtrisé.