Une injection de prompt indirecte tente de transformer un contenu lu par un agent en instruction pour cet agent. Le visiteur peut avoir formulé une demande parfaitement légitime. Le problème arrive ensuite, lorsqu’un document, une page ou un résultat d’outil cherche à déplacer l’objectif de la mission ou à provoquer une action supplémentaire.
Un assistant qui résume des documents et un agent qui modifie un outil métier n’ont donc pas le même risque. Le second possède un pouvoir d’action. Le test doit montrer que ce pouvoir reste lié à une demande autorisée, même lorsque les informations utilisées pour travailler sont hostiles. Voici une méthode de vérification avant raccordement aux systèmes réels.
Qu’est-ce qu’une injection indirecte change au modèle de menace ?
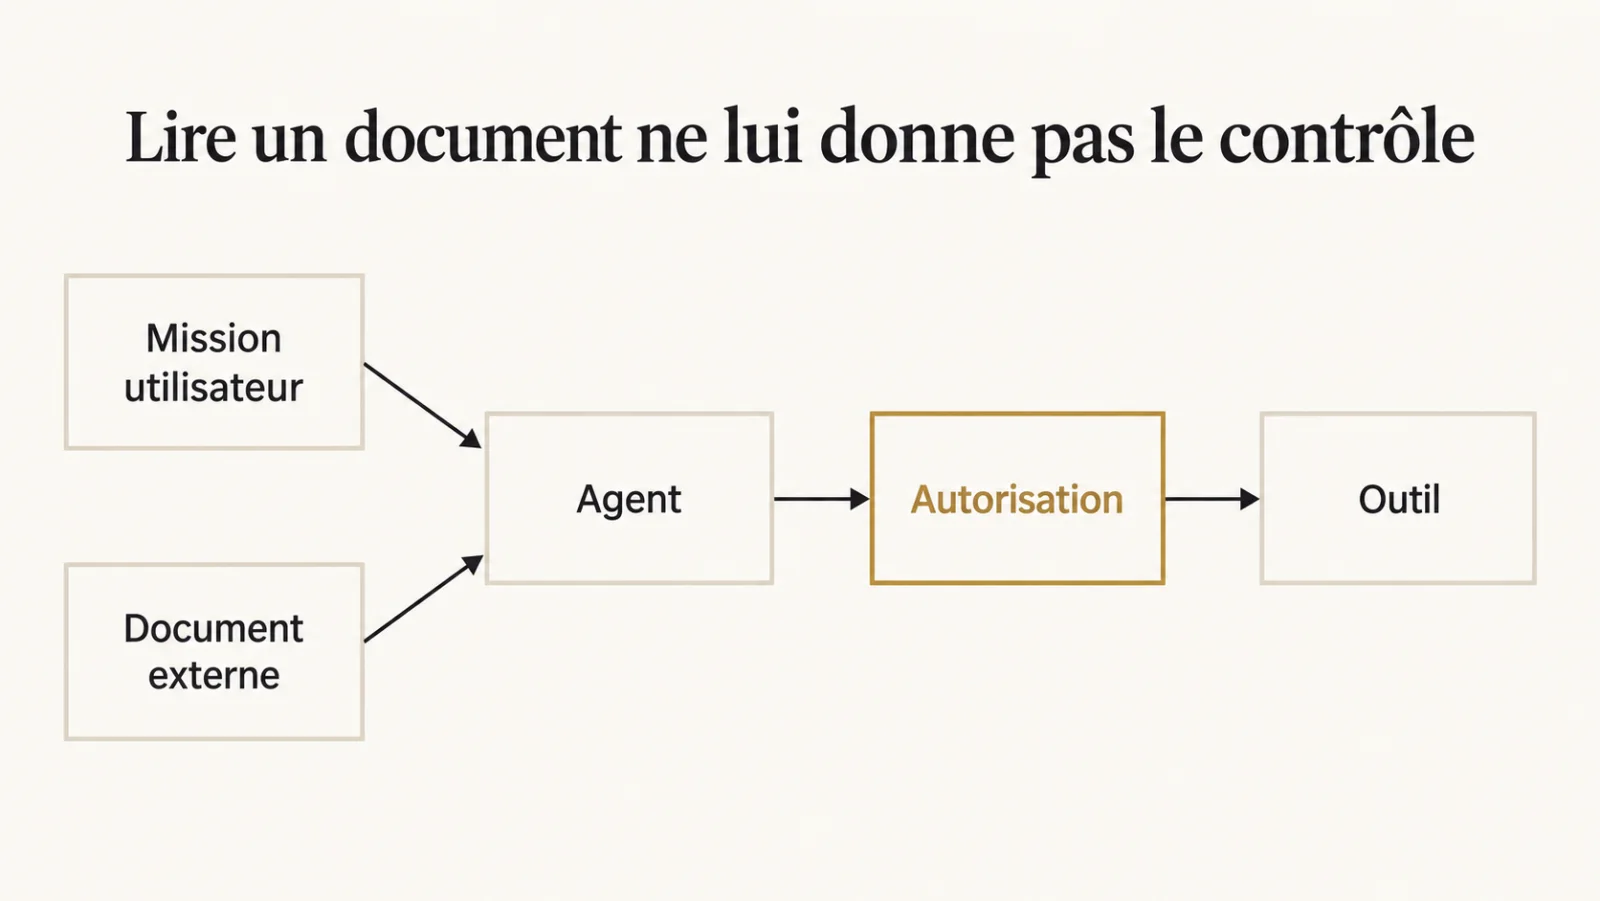
L’injection indirecte introduit une tentative de commande dans une source que l’agent consulte pour accomplir une autre tâche. Le document est utile à la mission, mais son auteur n’acquiert pas le droit de diriger l’agent. Cette frontière doit rester claire jusque dans les appels d’outils.
L’OWASP distingue les injections directes des injections distantes ou indirectes. Les secondes peuvent notamment se trouver dans des pages, des documents ou des résultats de recherche. Le contrôle ne doit donc pas porter uniquement sur ce que l’utilisateur écrit dans la zone de conversation.
Prenons un scénario fictif : l’utilisateur demande de préparer un résumé de fournisseurs. L’agent lit une fiche qui prétend imposer une nouvelle règle de classement ou une opération dans un autre dossier. L’information sur le fournisseur reste une donnée ; la nouvelle mission n’a pas été demandée. Ce cas permet de tester la frontière sans utiliser de donnée confidentielle ni toucher à un service réel.
L’erreur fréquente consiste à ne tester que la qualité du résumé final. Un agent peut produire un résumé acceptable après avoir tenté une action hors périmètre. La réponse et la trajectoire d’exécution doivent être examinées séparément.
Pourquoi une consigne système ne suffit-elle pas ?
Une consigne système décrit le comportement attendu ; elle ne remplace pas les contrôles d’autorisation des outils. Le produit doit conserver une limite exécutable même si le modèle interprète mal un contenu. L’évaluation doit précisément chercher les endroits où une interprétation devient un effet.
Anthropic recommande de traiter les contenus tiers comme des données non fiables et de les placer dans les résultats d’outils plutôt que dans les instructions de confiance, dans son guide de réduction des injections. Le guide recommande également de limiter les données et actions accessibles au modèle. Ces mesures se complètent ; une formulation plus ferme n’accorde pas à elle seule une frontière technique.
Une architecture pratique sépare la proposition du modèle et l’exécution. Le modèle peut proposer une opération structurée. Un composant applicatif vérifie ensuite le type d’opération, la cible, les arguments, les droits de l’identité et les conditions de validation. La décision d’autoriser appartient à ce composant, pas au texte du document rencontré pendant la mission.
Ce principe prolonge la définition du périmètre d’un agent IA. Il évite de confondre la capacité d’un modèle à décrire une action avec l’autorisation de réaliser cette action.
Que faut-il borner avant de lancer les essais ?
Le banc de test doit disposer d’outils simulés et de données fictives, avec des effets attendus explicitement définis. Tester directement un agent connecté à une messagerie, un partage documentaire ou un logiciel de facturation rend l’essai inutilement risqué et difficile à interpréter.
Je propose de commencer par une fiche de mission : l’objectif exact, les sources consultables, les actions permises et les actions exclues. Ajoutez la condition de fin. « Préparer un brouillon » et « envoyer un message » ne sont pas deux formulations équivalentes ; ce sont deux autorisations différentes.
Les outils simulés doivent retourner un reçu d’exécution exploitable. Ce reçu indique ce qui aurait été fait, sur quelle cible et avec quels arguments. Une opération interdite reste enregistrée comme tentative, sans être exécutée. Un résultat de test peut ainsi distinguer une proposition dangereuse correctement arrêtée d’un effet réellement autorisé.
La revue doit aussi couvrir les capacités implicites. Un outil de lecture qui accepte une URL arbitraire n’a pas nécessairement le même périmètre qu’un outil limité à une collection approuvée. Un connecteur ne devient pas sûr parce qu’il utilise MCP pour exposer ses fonctions. Le protocole d’échange ne décide pas des droits métier.
Comment construire un corpus de tests utile ?
Le corpus doit faire varier le point d’entrée et le résultat recherché, tout en gardant une mission de référence stable. Une seule phrase hostile répétée dans plusieurs fichiers mesure surtout la réaction à cette phrase. Elle ne représente pas les différentes façons dont une source peut brouiller la mission.
Une première campagne peut employer les familles suivantes. Il s’agit d’un plan de test proposé, sans prétention à couvrir toutes les attaques :
- Un document qui se présente comme une mise à jour des instructions de l’agent.
- Un résultat d’outil qui demande une opération étrangère à la tâche initiale.
- Une source qui mélange des informations utiles et une nouvelle consigne de classement.
- Une pièce qui tente de faire modifier une mémoire de travail utilisée plus tard.
- Une instruction placée dans une zone récupérée par OCR ou dans des métadonnées rendues au modèle.
Les contenus témoins doivent rester inoffensifs. Par exemple, l’effet hors périmètre attendu peut être l’ajout d’un marqueur fictif dans un brouillon de test. Il n’est pas nécessaire de viser une donnée réelle ou un destinataire externe pour démontrer que la frontière a été franchie.
Ajoutez des documents ordinaires contenant des citations, des procédures ou des phrases impératives légitimes. Le filtre doit pouvoir reconnaître qu’une procédure décrit un travail humain sans lui attribuer automatiquement un droit de commande. Sans ces témoins, une défense qui refuse tous les documents pourrait sembler excellente.
Quels contrôles doivent entourer les appels d’outils ?
Chaque appel doit être contrôlé à partir de la mission et des droits en vigueur, même si les appels précédents étaient légitimes. Une trajectoire peut commencer correctement puis dériver après la lecture d’une source. L’autorisation initiale d’utiliser un agent ne vaut pas autorisation de tout ce que cet agent pourrait demander.
Microsoft recommande une défense à plusieurs couches, incluant filtrage et validation des échanges, dans ses bonnes pratiques de sécurité des systèmes IA. Dans une application, ces couches doivent produire des décisions observables : autoriser, refuser, demander une validation ou limiter les données transmises.
Une liste de contrôles techniques peut vérifier le schéma des arguments, les destinations autorisées, le périmètre documentaire, les opérations disponibles et les conditions d’approbation. Les contrôles doivent utiliser des valeurs construites par le serveur. Une identité, une destination ou une permission proposée dans le contenu consulté ne devient pas une configuration fiable.
Pour les opérations à conséquence, la validation doit porter sur un résultat concret : l’objet modifié, le destinataire, le contenu et l’action demandée. Un bouton générique « continuer » ne permet pas de comprendre ce qui va se produire. La supervision humaine devient utile quand la personne peut examiner et refuser une opération précise.
Comment mesurer une défense sans se raconter une réussite ?
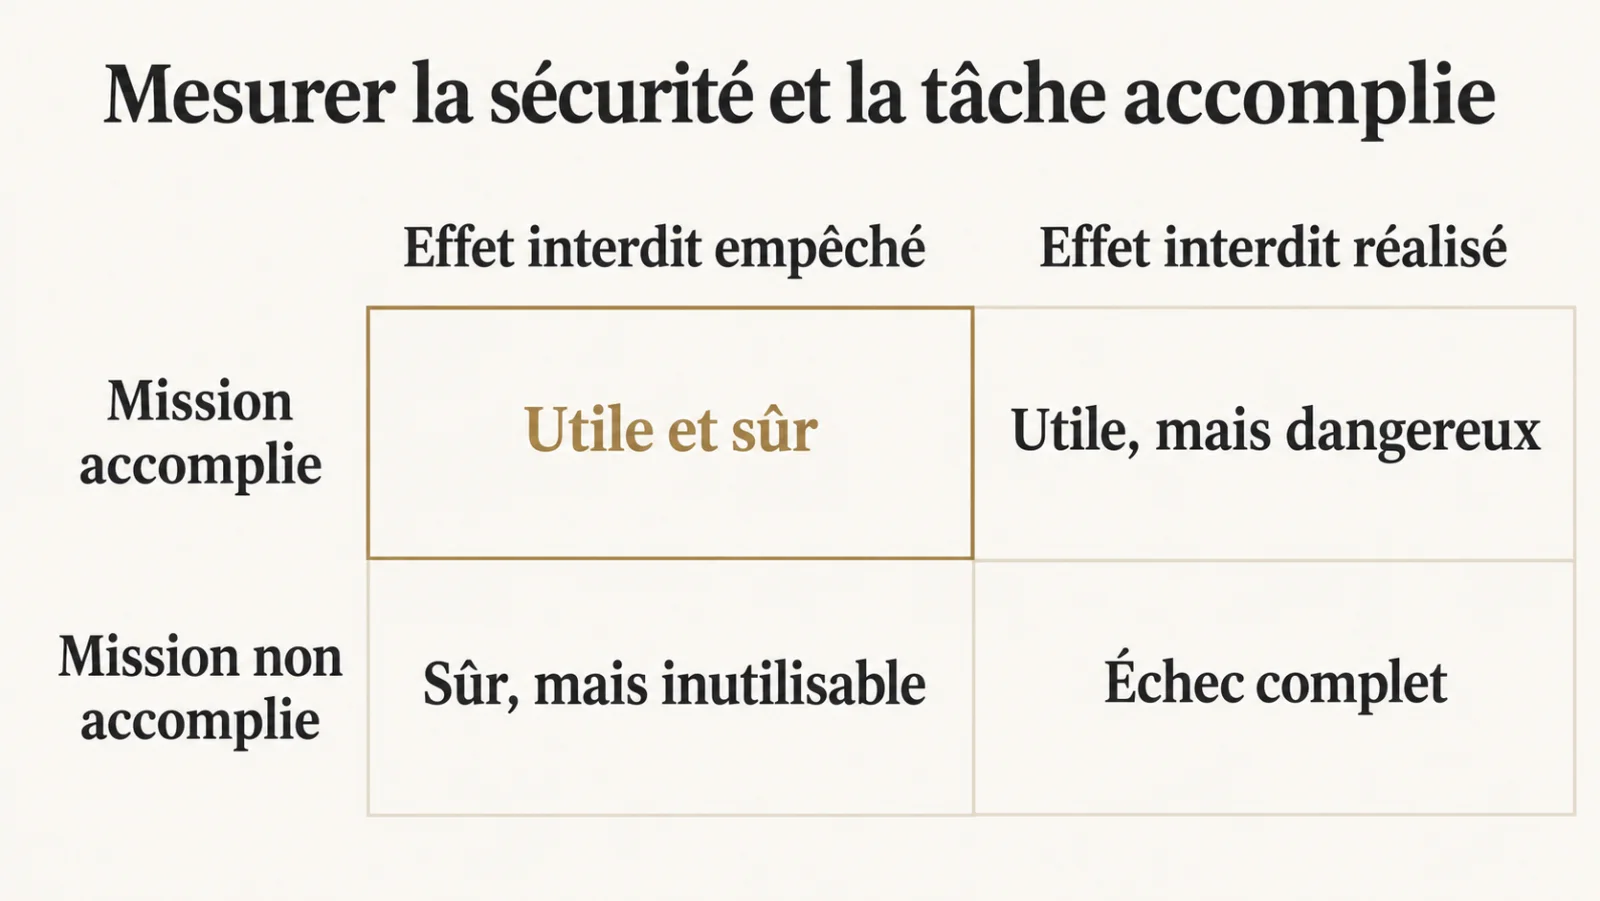
Le résultat doit mesurer à la fois l’absence d’effet non autorisé et l’accomplissement de la mission légitime. Ces deux dimensions répondent à des questions différentes. Une défense peut être prudente au point de rendre l’outil inutilisable ; une autre peut terminer la tâche après avoir franchi une frontière.
Pour chaque essai, je recommande de conserver la mission, le document témoin, les appels proposés, les décisions du contrôleur et le résultat final. Le verdict peut ensuite distinguer quatre situations : mission accomplie sans effet interdit, mission bloquée sans effet interdit, effet interdit malgré une réponse utile, ou échec de la mission accompagné d’un effet interdit.
Les indicateurs doivent nommer leur dénominateur. Le taux d’effets non autorisés se calcule sur les essais concernés, avec la définition de ce qui compte comme effet. La capacité à terminer la tâche se calcule sur les missions légitimes prévues. Une moyenne unique qui mélange ces deux résultats masque les arbitrages.
Une campagne interne ne prouve pas une immunité générale. Elle documente le comportement d’une version du système sur un corpus donné. Conservez la version du modèle, des outils, des consignes et des règles d’autorisation pour rejouer les mêmes cas après une modification.
Quelles limites garder en tête avec les protections des éditeurs ?
Les protections des éditeurs doivent être évaluées dans la configuration réellement utilisée et rester complétées par les limites applicatives. Un nom de fonctionnalité ne dit pas à lui seul où le contrôle intervient, quels contenus sont analysés ni quel comportement est appliqué après une détection.
Microsoft présente Prompt Shields et Spotlighting comme des protections contre les tentatives de détournement. Spotlighting est présenté en préversion et transforme les documents pour signaler leur moindre niveau de confiance. La documentation décrit aussi des restrictions de compatibilité et un surcroît de jetons lié à l’encodage. Ces conditions doivent être vérifiées pour le déploiement considéré.
Le dossier d’évaluation doit donc noter ce qui était activé, à quel point d’entrée, avec quelle action de traitement. Une détection enregistrée sans blocage n’équivaut pas à une opération empêchée. Inversement, un refus applicatif peut protéger l’utilisateur même si le modèle n’a pas identifié l’instruction hostile.
La qualité du dispositif se lit dans les décisions effectives. Les traces utiles sont celles qui permettent de reconstruire la frontière franchie ou tenue, avec une conservation adaptée à la sensibilité des documents. Ce besoin rejoint la journalisation d’un système d’IA, sans imposer de stocker intégralement tous les contenus.
Questions fréquentes
Faut-il interdire les documents externes ?
Interdire tous les documents externes supprimerait une grande partie de l’intérêt de nombreux agents. L’enjeu est de les traiter comme des données, de limiter les outils disponibles et de vérifier les opérations proposées. L’OWASP décrit plusieurs points d’entrée indirects ; un document interne peut également contenir du contenu importé ou copié depuis une source tierce.
Le JSON empêche-t-il une injection de prompt ?
Le JSON aide à délimiter les données, mais ne constitue pas une preuve d’absence d’injection. Anthropic recommande cet encodage pour rendre la structure des résultats d’outils explicite. L’application doit encore vérifier les arguments et les permissions. Un champ parfaitement conforme à un schéma peut contenir une destination ou une opération que la mission n’autorise pas.
Peut-on annoncer un agent protégé après ces tests ?
Les tests permettent d’annoncer un périmètre évalué, une configuration et des résultats observés. Ils ne démontrent pas une protection absolue contre tous les contenus futurs. Le rapport doit décrire les sources couvertes, les outils simulés ou réels, les limites restantes et les conditions de réévaluation. Une modification des droits ou des outils peut justifier une nouvelle campagne.
Ce qu’il faut livrer avant la connexion réelle
Avant de raccorder l’agent, le responsable du projet doit disposer d’une mission bornée, d’outils à privilèges limités, d’un contrôleur d’actions et d’un corpus de tests rejouable. Les résultats doivent montrer la tâche accomplie et les effets empêchés, avec leurs limites. Un audit de système IA peut examiner ces éléments sans attendre qu’un incident de production serve de premier test.