Le 24 septembre 2026, Google présente PageBreak, un agent interne destiné à rechercher des vulnérabilités dans ses applications Web. L’angle qui m’intéresse est la place donnée à la vérification : produire une hypothèse et démontrer un problème sont deux opérations différentes. Cette séparation devrait guider toute équipe qui envisage de confier une partie de ses revues de sécurité à des agents IA.
Une alerte bien rédigée peut rester fausse. À l’inverse, une anomalie difficile à reproduire peut être réelle. La valeur d’un dispositif d’évaluation dépend donc de ce qu’il permet de vérifier, de la façon dont il conserve les incertitudes et du travail qu’il laisse aux équipes chargées de corriger.
Que montre l’annonce de PageBreak ?
Dans sa présentation de PageBreak, Google décrit des validateurs spécialisés qui confrontent les hypothèses de l’agent à un environnement en fonctionnement. L’entreprise indique avoir découvert plus de 500 vulnérabilités XSS dans ses applications et revendique très peu de faux positifs. Ce sont les résultats rapportés par Google dans son propre périmètre, pas une mesure indépendante ni un taux attendu pour un autre système.
Google précise également que les candidats non confirmés servent à orienter de nouvelles investigations et à améliorer les validateurs. Ils ne sont pas transmis comme des alertes vérifiées aux équipes produit. Je retiens surtout cette distinction de statut : une file d’hypothèses à examiner ne devrait pas être confondue avec une liste de défauts établis.
Qu’est-ce qu’une preuve exploitable pour une équipe ?
Une preuve exploitable relie une condition initiale, une opération autorisée et un résultat observable. Elle indique le périmètre, les versions et les droits utilisés, de façon à permettre un contrôle par une autre personne. Un extrait de code suspect ou une explication convaincante peut amorcer l’enquête, mais ne décrit pas forcément le comportement du système réel.
Je demanderais à chaque rapport de distinguer quatre éléments : ce que l’on suppose, ce que l’on a testé, ce que l’on a observé et ce que l’on conclut. Cette présentation évite de glisser d’un vocabulaire d’incertitude à une affirmation catégorique au moment où le dossier est envoyé. Elle facilite également le désaccord : un réviseur peut accepter l’observation tout en contestant l’interprétation de son impact.
Cette logique rejoint celle d’un audit de système IA. Le rôle de l’audit est de produire des constats contrôlables, de localiser leurs causes et de hiérarchiser les corrections. Le volume d’alertes n’est pas, à lui seul, une preuve de qualité du travail.
Comment séparer génération d’hypothèses et validation ?
La génération explore des possibilités ; la validation applique un protocole borné. Dans un dispositif interne, je séparerais les permissions, les traces et les résultats de ces deux étapes. L’agent chargé de proposer une piste ne devrait pas pouvoir modifier seul le critère qui décidera si sa piste est confirmée.
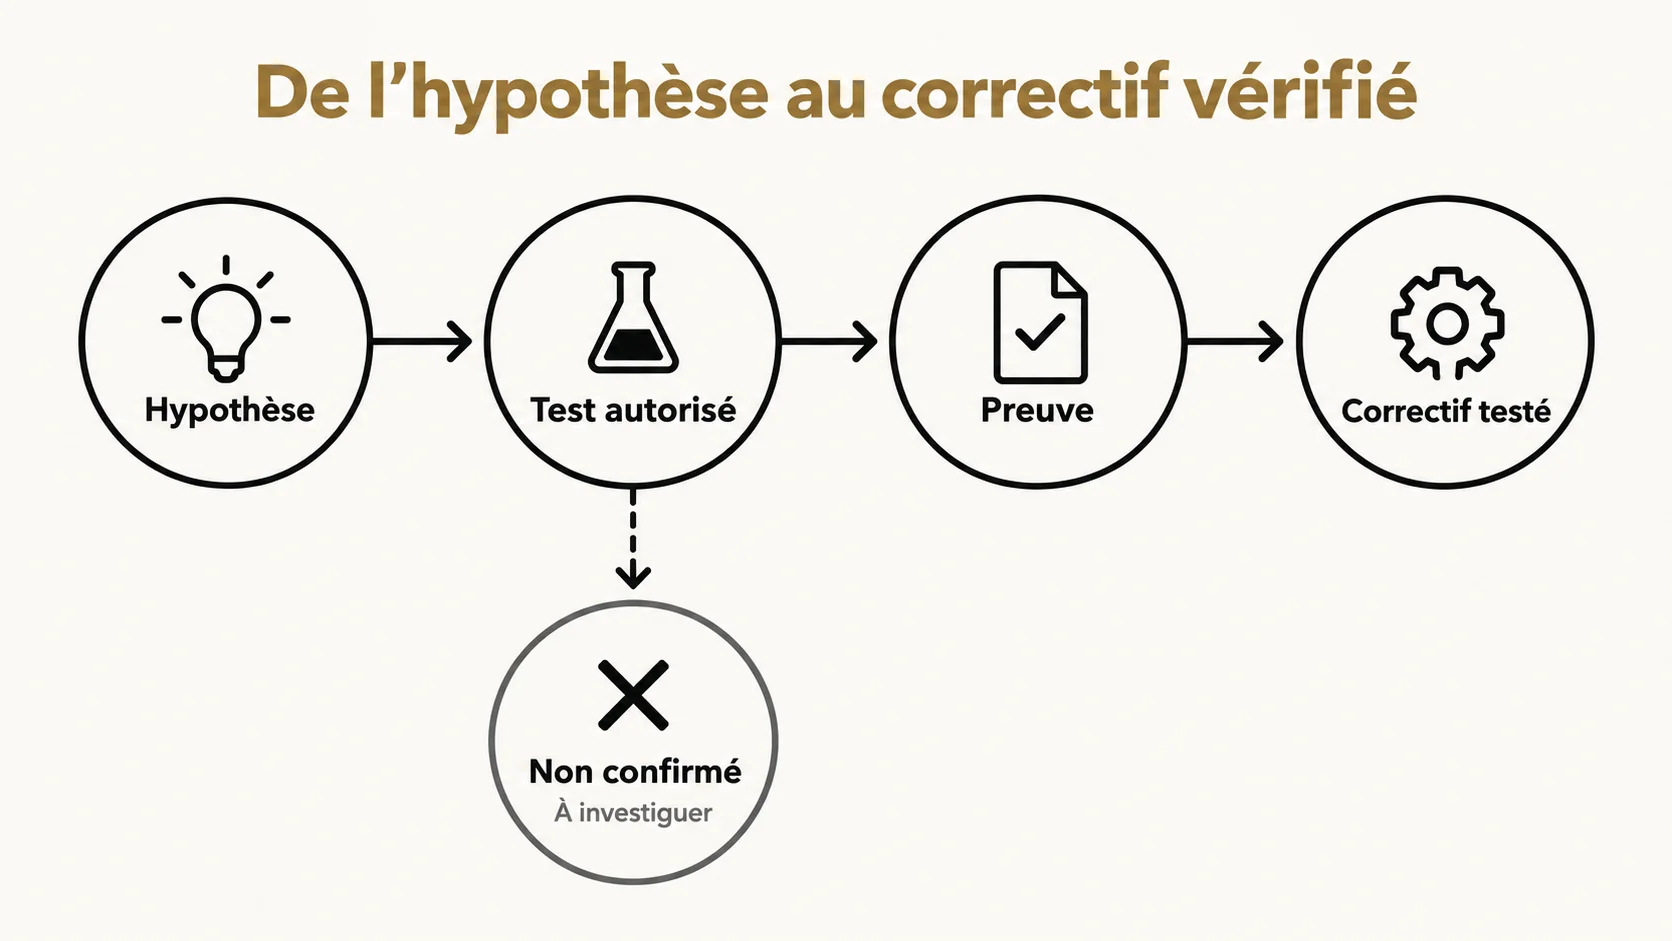
Cette séparation ne nécessite pas d’automatiser immédiatement toutes les vérifications. Une équipe peut commencer par un petit nombre de contrôles connus, dont elle comprend les préconditions. Le reste demeure soumis à examen. Le principe important est de ne pas laisser un texte généré devenir son propre certificat de validité.
Que faire d’une anomalie non reproduite ?
Une anomalie non reproduite doit rester non confirmée, avec la raison de cette limite. Il peut manquer un droit, une version, une donnée ou une capacité du banc de test. Elle ne devient pas automatiquement un faux positif. L’absence de preuve et la preuve d’absence ne sont pas interchangeables.
Le dossier doit donc permettre plusieurs issues : problème confirmé, comportement attendu, test non concluant ou examen hors périmètre. Fermer toutes les alertes difficiles pour afficher un bon taux de précision donnerait une image trompeuse de la couverture. Il faut pouvoir revenir sur un candidat quand l’environnement ou le protocole évolue.
Une collection de tests construite sur des situations connues aide à vérifier les validateurs eux-mêmes. Incluez des cas où l’anomalie existe et des témoins où elle n’existe pas. Sans témoins, un contrôle qui déclenche tout le temps peut donner l’impression de bien fonctionner.
Quels indicateurs permettent de juger le dispositif ?
Le premier indicateur utile est la part des rapports examinés qui reposent effectivement sur une preuve suffisante. Il doit être accompagné du nombre de cas, de la période et du périmètre observés. Un pourcentage sans dénominateur ne permet pas de distinguer un essai limité d’un dispositif éprouvé sur des environnements variés.
Suivez aussi le temps de revue, les dossiers rouverts, les tests non concluants et le délai entre confirmation et correction. La couverture constitue une question séparée : certaines familles de problèmes peuvent être absentes des tests. Une excellente précision sur les alertes remontées n’indique pas combien de défauts ont été manqués.
Je regarderais enfin la charge déplacée. Un agent qui génère rapidement des centaines de pistes peut économiser du temps d’exploration tout en saturant la revue. L’évaluation doit prendre en compte cette chaîne complète, jusqu’à la décision et au contrôle du correctif.
Quelles limites poser à un agent de vérification ?
Un agent de vérification doit opérer sur un périmètre explicitement autorisé, avec des comptes, données et capacités adaptés au test. Une annonce concernant un outil interne Google n’autorise évidemment pas à lancer des essais sur des services tiers. Dans une organisation, les restrictions d’accès et les conditions d’arrêt font partie du protocole, pas d’un commentaire ajouté après l’exécution.
Le contexte lu par l’agent peut lui-même être trompeur. Il faut donc maintenir une séparation entre les données examinées et les instructions autorisées. L’article sur les injections de prompt indirectes propose une manière d’éprouver cette frontière sans connecter les outils de test à des actions réelles.
La revue humaine ne doit pas être une signature automatique. Le réviseur doit disposer des observations utiles, connaître les limites de couverture et pouvoir rejeter une conclusion. Une intervention humaine dépourvue d’éléments contrôlables ne transforme pas une hypothèse en preuve.
Quel premier pilote organiser ?
Je commencerais par une application de test maîtrisée et une famille de contrôles connue de l’équipe. Le pilote aurait trois livrables : une fiche de périmètre, un ensemble de cas avec résultats attendus et un modèle de rapport qui sépare clairement hypothèse, observation et décision. Les accès et les conditions d’arrêt seraient définis avant l’exécution.
Un exemple fictif peut être une application interne de démonstration, avec des versions volontairement différentes d’un même comportement. L’équipe connaît les cas attendus et vérifie si le dispositif les distingue. Ce scénario n’apporte aucune mesure sur une application cliente : il sert à examiner la qualité du protocole et des traces avant de décider d’un usage réel.
Une fois un problème confirmé et corrigé, rejouez le contrôle correspondant et les tests fonctionnels pertinents. Le correctif doit supprimer le défaut sans casser le comportement légitime. La preuve utile inclut alors un état avant, un état après et la version qui relie les deux.
Ce que je retiens pour les équipes
PageBreak donne un exemple intéressant de séparation entre exploration et vérification. La méthode à reprendre n’est pas un chiffre de performance sorti de son contexte : c’est une discipline de preuve, de classement des incertitudes et de contrôle des effets.
Avant d’acheter ou de construire un agent d’audit, demandez ce qui rend ses conclusions vérifiables. Un outil qui explique ses limites et produit des éléments reproductibles permet une décision plus solide qu’un outil qui présente chaque hypothèse comme une découverte.