Qu’est-ce qu’un filigrane de contenu généré par IA ?
Un filigrane de contenu généré par IA est un marquage technique inséré par le système qui produit le contenu, pour qu’un outil de détection puisse ensuite reconnaître que ce contenu provient de ce système. Il est en principe invisible pour le lecteur et lisible par une machine.
Trois familles de méthodes coexistent. La signature statistique agit sur le choix des mots d’un texte : le système favorise de façon imperceptible certaines séquences, qu’un détecteur sait reconnaître. L’empreinte dans les métadonnées attache au fichier une information sur son origine, éventuellement signée. Le motif imperceptible modifie les pixels d’une image ou le signal d’un son sans changer ce que l’on perçoit.
Ces méthodes répondent à une question précise : ce contenu est-il probablement sorti de tel système ? Elles ne répondent pas à celle que posent souvent juristes et acheteurs : peut-on prouver devant un tiers d’où vient ce contenu et qu’il n’a pas été modifié ?
Que prouve réellement un filigrane sur un contenu généré ?
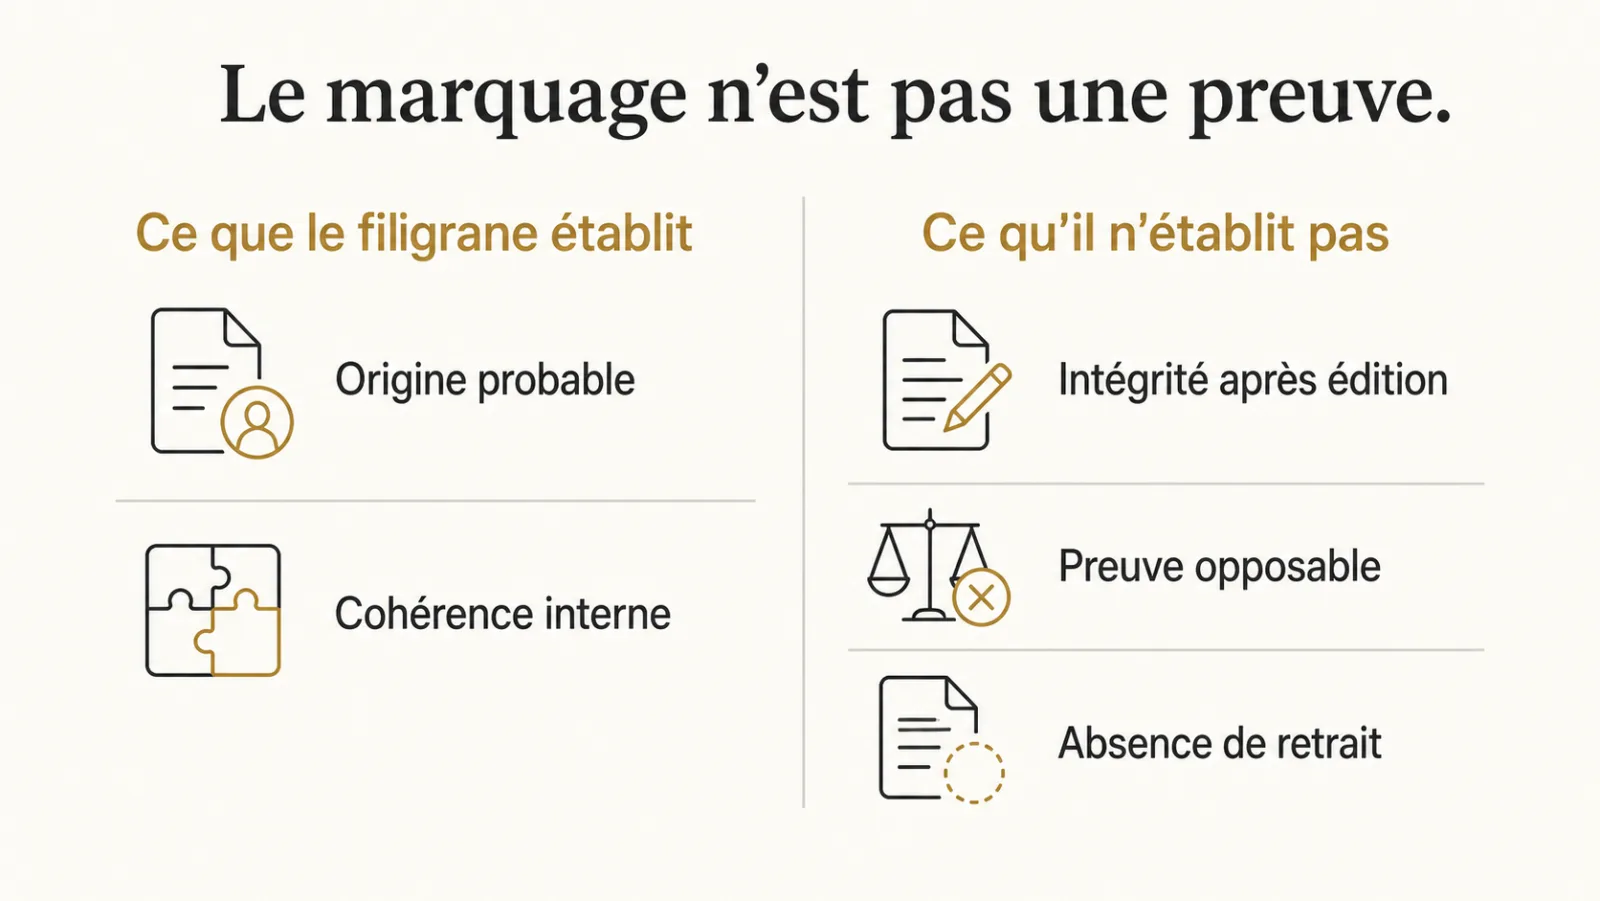
Un filigrane technique établit qu’un contenu provient probablement d’un système donné, mais il n’établit ni l’absence de modification, ni une origine opposable, ni l’absence de retrait par un tiers. Cette nuance décide de ce qu’on peut en faire.
Les méthodes existent et elles fonctionnent dans leur domaine : une signature statistique dans le choix des mots, une empreinte dans les métadonnées d’un fichier, un motif imperceptible dans une image.
Toutes partagent la même limite. Elles sont conçues pour résister à une manipulation ordinaire, pas à une manipulation déterminée. Une reformulation, une conversion de format, une capture d’écran suffisent souvent à les faire disparaître.
Que ne faut-il pas attendre d’un filigrane ?
L’intégrité d’un contenu après édition, la preuve opposable de son origine et la détection fiable d’un retrait de marquage sont hors de portée des méthodes actuelles de filigrane. Les promettre engage l’organisation sur ce qu’elle ne peut pas tenir.
L’intégrité après édition : un texte marqué puis retouché à la main perd sa signature progressivement. Il n’existe pas de seuil net entre « encore détectable » et « plus détectable ».
La preuve opposable : la présence d’un marquage n’établit pas juridiquement l’origine, et son absence n’établit pas qu’un contenu est humain. Un document non marqué peut avoir été généré par un système qui ne marque pas.
La détection d’un retrait : rien ne distingue un contenu dont le marquage a été supprimé d’un contenu qui n’en a jamais porté.
Qui doit marquer les contenus générés : le fournisseur ou le déployeur ?
Selon l’article 50, paragraphe 2, du règlement (UE) 2024/1689, ce sont les fournisseurs de systèmes d’IA générative qui doivent marquer leurs sorties dans un format lisible par machine et détectable, pas les organisations qui se contentent de les déployer. Cette distinction change la lecture de tout ce qui précède.
Le fournisseur est celui qui développe un système d’IA, ou le fait développer, et le met sur le marché ou en service sous son propre nom. Le déployeur est celui qui utilise ce système sous son autorité dans le cadre de son activité. L’obligation de marquage technique s’applique à compter du 2 août 2026. Pour les systèmes déjà mis sur le marché avant cette date, le règlement (UE) 2026/1744, dit omnibus, reporte cette obligation au 2 décembre 2026. Le texte la module par ce qui est techniquement faisable : il impose un marquage, il ne lui demande pas d’être infaillible.
Pour le fournisseur, marquer n’est donc pas une option, et c’est précisément pour cela que la thèse de cet article lui importe : se conformer à l’obligation de marquage ne transforme pas ce marquage en preuve d’origine.
Pour le déployeur, les obligations de transparence sont d’une autre nature : signaler les hypertrucages, avec les aménagements prévus par le texte, et les textes générés publiés pour informer le public sur des questions d’intérêt public. Pour ces seuls textes, l’exception suppose un examen humain ou un contrôle éditorial et une responsabilité éditoriale assumée. La répartition entre les acteurs de la chaîne est détaillée dans marquer un contenu généré : où l’obligation se pose.
| Question | Fournisseur d’un système d’IA générative | Déployeur |
|---|---|---|
| Marquage lisible par machine (art. 50, § 2) | Obligatoire, dans la mesure de ce qui est techniquement faisable | Pas d’obligation de marquage technique propre à ce titre |
| Information des personnes | Concevoir le système pour que les personnes sachent qu’elles interagissent avec une IA | Signaler les hypertrucages ; pour les textes d’intérêt public, exception sous examen humain ou contrôle éditorial et responsabilité éditoriale assumée |
| Ce qu’une clause peut promettre | Le dispositif de marquage mis en œuvre et ses limites connues | Le dispositif : mention, journalisation, validation |
| Ce qu’elle ne peut pas promettre | Que tout contenu reste identifiable après édition ou retrait | Que les contenus soient identifiables par un tiers |
Un point de vigilance : une organisation qui construit son propre système génératif sur un modèle tiers et le met en service sous son nom peut se trouver dans la position de fournisseur de ce système. La qualification se vérifie au cas par cas, avant de rédiger le moindre engagement.
Ce sur quoi une organisation peut s’appuyer à la place
- Sa propre journalisation, qui établit ce que le système a produit, quand et pour qui. C’est la seule trace dont l’organisation maîtrise l’intégrité. Voir l’observabilité des systèmes IA.
- La validation humaine tracée, qui transfère la responsabilité du contenu à une personne identifiée.
- La mention explicite dans l’interface, qui, pour un déployeur, remplit l’obligation d’information sans dépendre d’une technique de marquage propre. Le marquage lisible par machine relève, lui, du fournisseur du système génératif.
- La documentation du système, qui décrit ce qui est produit et comment. Voir écrire la fiche d’un système d’IA.
Peut-on détecter de façon fiable qu’un document reçu a été généré par une IA ?
Détecter si un document reçu a été généré par une machine est un problème différent du marquage, et il n’a pas de solution fiable aujourd’hui pour fonder une décision individuelle. C’est pourtant la demande que je reçois le plus souvent sur ce sujet.
Le cas type est une organisation qui reçoit des candidatures, des copies ou des dossiers, et qui veut savoir lesquels ont été produits par un système. Les outils qui promettent cette détection existent, et leur taux de faux positifs est trop élevé pour justifier une décision sur une personne.
Ma recommandation est constante : ne pas fonder de décision individuelle sur une détection automatique. Si le contenu généré pose problème dans un processus, c’est le processus qu’il faut revoir, en demandant autre chose qu’un texte : un échange oral, un travail réalisé en situation, une pièce justificative vérifiable.
Que peut-on écrire dans un engagement contractuel sur le marquage ?
Pour un déployeur, une clause qui promet de marquer tous les contenus générés est intenable, alors qu’une clause qui décrit le dispositif mis en place et ses limites se tient. Pour un fournisseur, le marquage est une obligation légale, mais la clause doit elle aussi décrire le dispositif plutôt que promettre une preuve d’origine.
La formulation qui tient nomme ce qui est fait : mention dans l’interface, journalisation des productions, validation humaine avant diffusion externe, et, chez un fournisseur, la méthode de marquage appliquée. Elle ne promet pas un résultat technique que la méthode ne garantit pas.
La formulation qui ne tient pas est celle qui reprend le vocabulaire commercial : contenus marqués, traçabilité assurée, origine garantie. Ces termes ont un sens commercial et pas de contenu vérifiable.
Cette prudence rédactionnelle relève du même principe que celui appliqué aux annonces de performance dans comment lire une annonce de benchmark : ne reprendre à son compte que ce qu’on peut vérifier soi-même.
La phrase qui évite un engagement intenable
Décrire le dispositif, jamais le résultat. « Les contenus produits sont journalisés et validés avant diffusion » se prouve. « Les contenus générés sont identifiables » ne se prouve pas, et vous en répondrez.
Que change l’absence de preuve à la conception d’un système d’IA ?
Puisque le filigrane technique ne porte pas la preuve, c’est le flux de traitement qui doit la porter : validation, journal et mention, décidés dès le cadrage du système. Cela déplace l’effort de l’outil vers le processus, ce qui est une bonne nouvelle.
La démarche tient en cinq étapes :
- Qualifier son rôle pour chaque système : fournisseur, déployeur, ou les deux selon les usages.
- Placer la validation humaine : quels contenus passent par une personne avant diffusion, et qui signe.
- Définir le journal : ce qu’il conserve (entrée, sortie, version du système, validateur), combien de temps, et qui y accède.
- Situer la mention : dans l’interface, dans le document, ou dans les deux, selon que le contenu reste interne ou sort de l’organisation.
- Rédiger les engagements à partir de ces trois éléments, et non à partir des promesses du fournisseur.
Elles sont les mêmes que celles qui structurent le dossier de conformité, ce qui permet de les traiter une fois pour les deux besoins, comme décrit dans ce qui doit exister avant l’échéance. Un audit IA peut servir à faire cet inventaire système par système.
Quelles erreurs fréquentes commettent les organisations avec le filigrane ?
Les erreurs fréquentes autour du filigrane consistent à lui prêter une valeur de preuve, à confondre les rôles de fournisseur et de déployeur, et à croire qu’un détecteur peut trancher une situation individuelle. Elles se retrouvent dans les contrats comme dans les politiques internes.
- Écrire « origine garantie » dans un contrat. Aucune méthode de marquage ne garantit l’origine devant un tiers.
- Penser que le marquage du fournisseur règle tout. L’engagement du fournisseur est une pièce utile, mais il ne remplace pas la mention due par le déployeur, comme le rappelle faut-il dire à l’utilisateur qu’il parle à une machine.
- Ignorer sa propre qualification. Une organisation qui met en service un système génératif sous son nom peut être fournisseur, avec l’obligation de marquage qui va avec.
- Sanctionner sur un score. Un détecteur produit une probabilité, pas un constat.
- Négliger le journal. Sans trace interne fiable, l’organisation n’a plus rien à opposer en cas de litige sur un contenu.
Le calendrier réglementaire ne change rien à ce constat, comme le montre omnibus : le report de l’AI Act ne solde rien.
Questions fréquentes
Un filigrane prouve-t-il l’origine d’un contenu ?
Non. Il établit une origine probable. Il ne prouve ni l’intégrité après édition, ni une origine opposable à un tiers, et son absence ne prouve pas qu’un contenu est humain.
Qui est obligé de marquer les contenus générés par IA ?
L’article 50, paragraphe 2, du règlement (UE) 2024/1689 vise les fournisseurs de systèmes d’IA générative : ils doivent marquer leurs sorties dans un format lisible par machine et détectable, dans la mesure du techniquement faisable. L’obligation s’applique au 2 août 2026, et au 2 décembre 2026 pour les systèmes déjà sur le marché selon le règlement omnibus 2026/1744. Le déployeur a, lui, des obligations d’information distinctes.
Peut-on détecter un texte généré à l’entrée ?
Pas de façon fiable. Les outils existants ont un taux de faux positifs trop élevé pour fonder une décision individuelle, avec le risque d’accuser à tort. Mieux vaut revoir le processus et demander une autre forme de preuve qu’un texte.
Que peut-on écrire dans un contrat ?
Le dispositif, jamais le résultat. « Les contenus produits sont journalisés et validés avant diffusion » se prouve ; « les contenus générés sont identifiables » ne se prouve pas. Un fournisseur décrit en plus la méthode de marquage qu’il applique et ses limites.
Une entreprise qui utilise un assistant génératif doit-elle marquer ses textes ?
Si elle se contente de déployer un système fourni par un tiers, le marquage technique relève du fournisseur ; elle doit en revanche informer dans les cas prévus par le texte, notamment pour les hypertrucages et certains textes d’intérêt public. Si elle construit et met en service son propre système sous son nom, elle peut devenir fournisseur, et la question se pose autrement.
Sources
- Can AI-Generated Text be Reliably Detected? : la paraphrase récursive fait chuter la détection des filigranes et des détecteurs, Sadasivan et al., arXiv, mars 2023.
- Retrait du classificateur de textes générés pour faible précision (26 % de vrais positifs, 9 % de faux positifs), OpenAI, 31 janvier 2023, mis à jour le 20 juillet 2023.
- GPT detectors are biased against non-native English writers, Liang et al., Stanford, arXiv / Patterns, avril 2023.
- Règlement (UE) 2024/1689, article 50 sur les obligations de transparence, dont le marquage des contenus générés dans un format lisible par machine, Journal officiel de l'UE, 13 juin 2024.