Ce qu'un classement mesure réellement
Un classement public mesure la performance moyenne sur un jeu de tâches choisi par quelqu'un d'autre, dans des conditions définies par ses auteurs. Il aide à repérer des candidats, mais ne suffit pas à décider d’une migration.
La confusion vient de la forme. Un score chiffré, un tableau, un classement : tout indique une mesure objective. Elle l'est, mais elle mesure autre chose que ce qui vous intéresse.
La question que pose un classement est « ce modèle est-il bon en général ». Celle que vous posez est « ce modèle traite-t-il correctement mes documents, dans ma langue, pour ma tâche, à un coût acceptable ». Les deux réponses ne coïncident pas.
Question un : sur quel jeu de tests
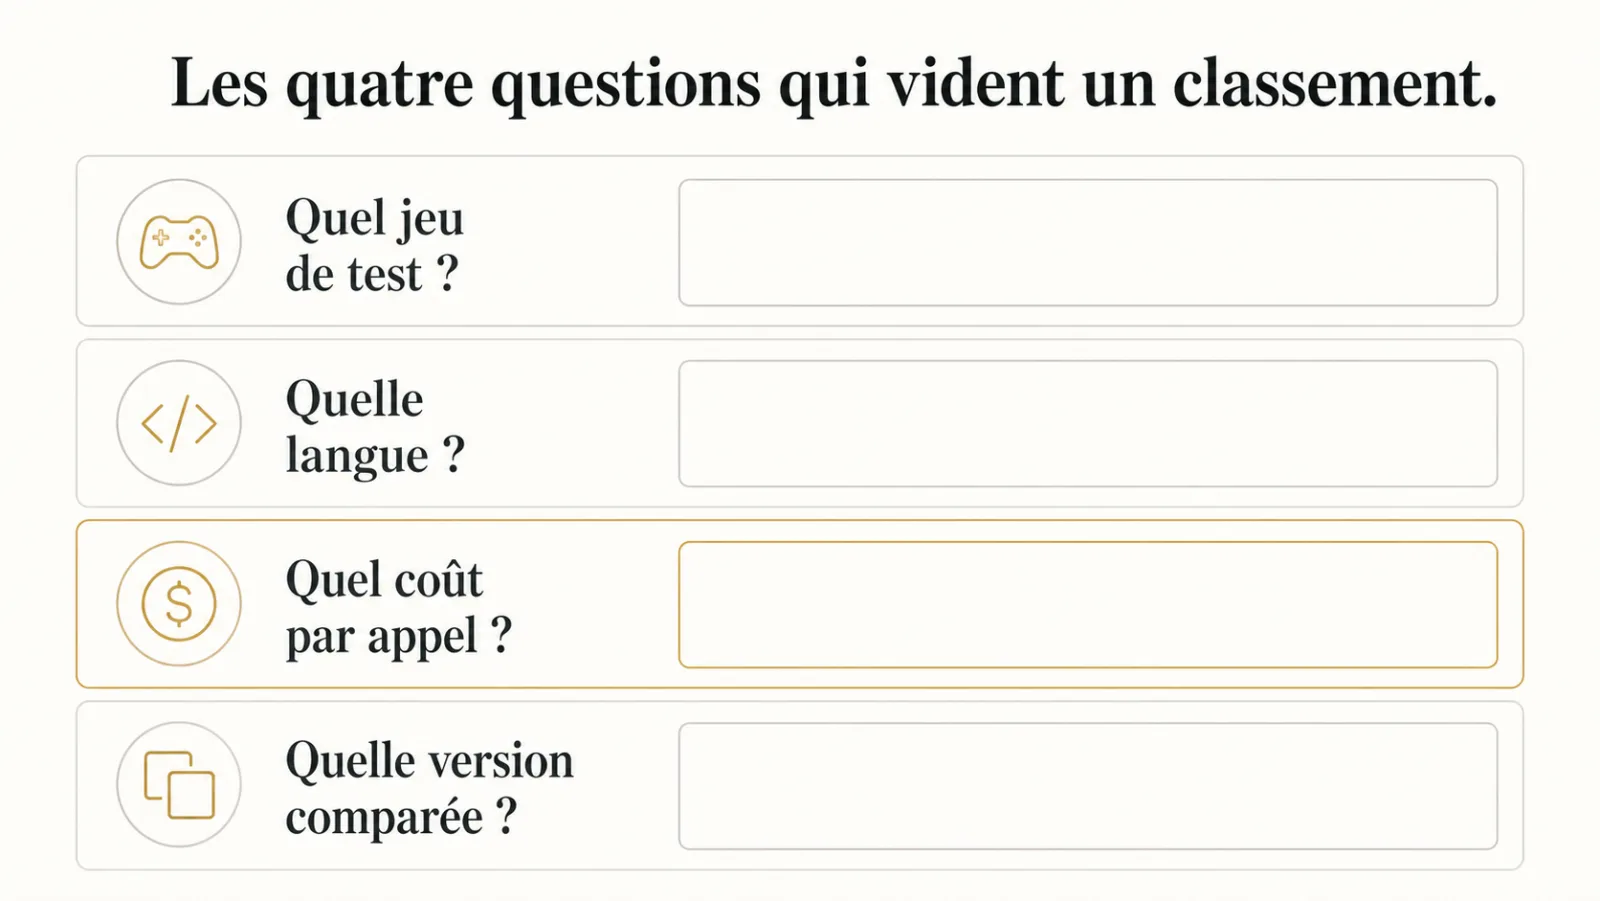
Un score n'a de sens que rapporté au jeu de tâches sur lequel il a été obtenu, et sa représentativité pour votre usage doit être vérifiée. C'est le premier filtre.
Les jeux publics couvrent des tâches différentes : raisonnement, code, connaissances ou usages spécialisés. Vérifiez s’ils représentent vos besoins réels : extraire une information d'un document mal mis en page, classer une demande ambiguë, refuser une question hors périmètre.
S'ajoute un problème de contamination. Un chevauchement avec les données d’entraînement constitue un risque à examiner, sans supposer qu’il affecte automatiquement chaque modèle. La signification d’un écart dépend du protocole, de la variabilité et des tâches évaluées.
Ce constat justifie l'existence du jeu de tests maison, seul instrument qui réponde à votre question. C’est le sujet de construire un jeu de tests en une journée.
Les trois autres questions
- Dans quelle langue ? Un modèle évalué en anglais peut perdre plusieurs points en français, particulièrement sur les formats de sortie contraints.
- À quel coût par appel ? Un gain de trois points pour un coût multiplié par dix n'est pas un progrès mais un arbitrage, et il se décide sur votre volume.
- Comparé à quelle version ? Une comparaison à une version antérieure d'un concurrent, ou à un réglage non optimisé, ne dit rien.
- Et une quatrième, implicite : qui a produit la mesure ? Un résultat publié par le fournisseur du modèle mérite une lecture différente d'un résultat indépendant.
Le piège du gain moyen sur les cas moyens
Une moyenne peut masquer des régressions sur certaines familles de cas. Examinez la répartition des résultats et les échecs critiques, sans supposer que tout progrès concerne uniquement les cas moyens.
Un score moyen s'améliore en traitant mieux ce qui était déjà à peu près correct. Les cas véritablement difficiles, question mal formulée, document contradictoire, formulation inhabituelle, demande hors périmètre, progressent beaucoup plus lentement.
Or ce sont exactement ces cas qui produisent les incidents, les corrections manuelles et la perte de confiance des utilisateurs.
D'où la composition que je recommande pour un jeu de tests : un tiers de cas limites tirés des échecs réellement observés. C'est ce tiers qui prédit le comportement après bascule, et c'est lui qui manque dans tous les jeux d'évaluation publics.
Comment utiliser malgré tout ces annonces
Un classement sert à repérer les candidats à tester, jamais à trancher. C'est son bon usage, et il est réel.
Une annonce indique qu'un nouveau modèle mérite d'être ajouté à la comparaison trimestrielle. Elle ne dit pas qu'il faut basculer, ni même qu'il sera meilleur sur votre tâche.
La séquence saine tient en quatre étapes. Repérer le candidat dans l'annonce. L'ajouter comme option dans la couche d'abstraction. Relancer le jeu de tests. Comparer le taux d'erreur et le coût par appel.
Une comparaison sur des cas représentatifs instruit la décision. Sa durée dépend du périmètre, des risques et de l’infrastructure de test disponible. C’est la logique posée dans l'évaluation continue.
La phrase qui clôt le débat en réunion
« On l'ajoute au jeu de tests et on regarde jeudi. » Elle transforme une discussion sans issue en tâche de deux heures, et elle n'est possible que si le jeu de tests existe déjà.
Quels critères supplémentaires mesurer dans votre usage ?
Le refus approprié, la stabilité du format et le comportement sur vos documents peuvent être décisifs pour votre usage. Certains benchmarks les étudient ; votre recette doit vérifier leur pertinence dans vos propres conditions.
Le taux de refus approprié mesure si le modèle dit qu'il ne sait pas quand il ne sait pas. Un modèle qui invente est inutilisable quel que soit son score. C’est le point développé dans le refus de répondre est une fonctionnalité.
La stabilité du format décide de la fiabilité d'une chaîne automatisée. Une sortie invalide une fois sur vingt casse le traitement, et cette fréquence n'apparaît dans aucune évaluation publique.
Le comportement sur documents dégradés, scans médiocres, mises en page complexes, tableaux, détermine la qualité perçue, parce que c'est sur ces documents que les utilisateurs butent.
Ces mesures alimentent un jeu de tests qui évolue avec les documents, les incidents et le périmètre du service.
Questions fréquentes
Un écart de deux points entre deux modèles est-il significatif ?
Pas automatiquement. Il faut examiner le protocole, la variabilité, les tâches et le risque de contamination. Une recette métier complète la lecture du benchmark.
Pourquoi une bascule déçoit-elle après une bonne annonce ?
Une amélioration moyenne peut coexister avec des régressions sur vos cas. Les données, les droits, les outils et les paramètres du test peuvent aussi différer de la production.
À quoi servent alors les classements ?
À repérer les candidats à tester. Une annonce justifie d'ajouter un modèle à la comparaison trimestrielle ; elle ne justifie jamais une bascule à elle seule.
Quels critères compléter dans notre recette ?
Le taux de refus approprié, la stabilité du format de sortie et le comportement sur documents mal mis en page. Leur importance dépend de votre tâche ; il faut aussi mesurer les droits, les actions et le coût lorsqu’ils influencent la décision.
Comment passer du score public à une recette métier ?
La généralisation consiste à évaluer le comportement sur des données nouvelles. Un résultat sur un jeu connu ne garantit donc pas les performances sur vos documents. Définissez les critères de réussite, réservez des cas de validation et documentez les paramètres.
Pour comparer deux versions, la recette Sonnet 5.5 sépare les écarts par famille de tâches. Pour un modèle de simulation, la validation du domaine physique ajoute des références et des limites explicites. Le cadre NIST rappelle l’importance de mesurer les risques dans le contexte d’utilisation.