Comment fonctionne le mélange d’experts de Mixtral ?
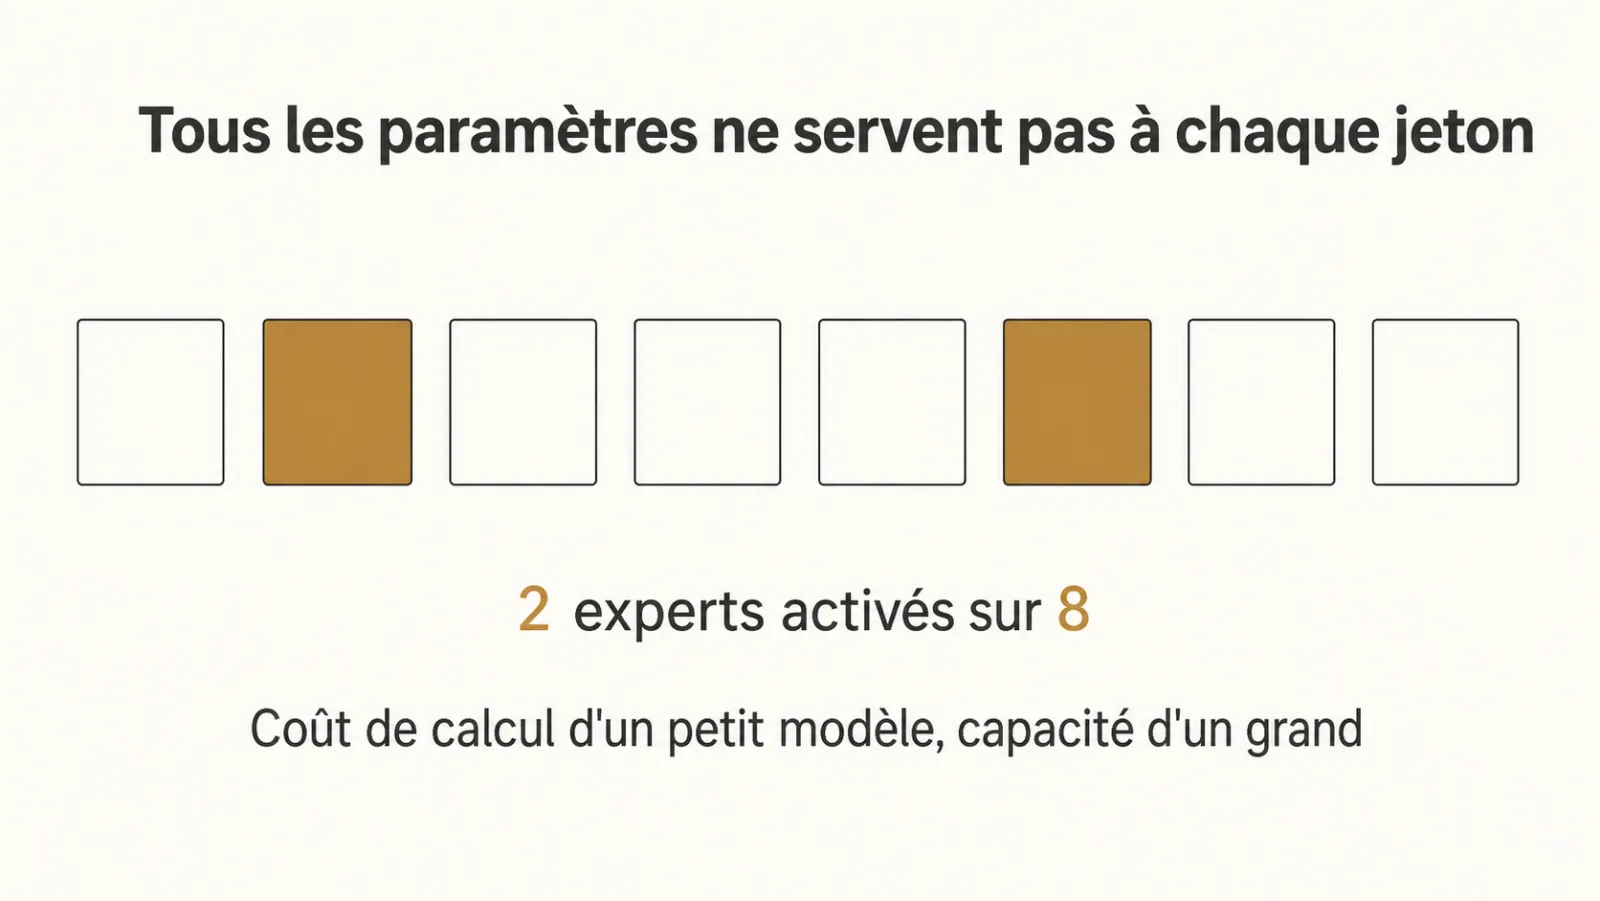
Mixtral répartit une partie de son calcul entre plusieurs réseaux appelés experts, puis en active deux par couche et par jeton au lieu de tous les mobiliser.
Mistral présente Mixtral 8x7B le 11 décembre 2023 comme un modèle à mélange d’experts parcimonieux, avec des poids ouverts sous licence Apache 2.0. Dans les blocs concernés, un routeur choisit deux experts parmi huit et combine leurs sorties.
L’analogie du cabinet de spécialistes aide en réunion : un dossier n’occupe pas tout le cabinet. Elle a une limite importante. Les experts du modèle ne sont pas des professionnels auxquels seraient attribués des métiers humains ; ce sont des ensembles de paramètres appris.
Le point utile pour une direction est le découplage entre paramètres disponibles et paramètres mobilisés à chaque étape. Cette architecture ouvre un nouvel arbitrage économique. Elle ne suffit pas à choisir un modèle et ne dispense pas d’observer son résultat sur les tâches visées.
Combien de paramètres Mixtral utilise-t-il réellement ?
Mistral annonce 46,7 milliards de paramètres au total pour Mixtral 8x7B, dont 12,9 milliards mobilisés par jeton, ce qui distingue capacité stockée et calcul actif.
Ces valeurs expliquent pourquoi le nom du modèle ne correspond pas à une simple multiplication de modèles denses indépendants. Les blocs partagés et les experts composent un seul réseau.
Je conserve surtout une distinction : réduire le calcul actif ne supprime pas le besoin de stocker les poids. Le matériel doit permettre d’accéder aux experts sélectionnés et de servir les requêtes dans les conditions de charge prévues. La précision numérique choisie, les mémoires de contexte et le nombre de demandes simultanées comptent aussi.
Il serait trompeur de déduire une configuration de machine du seul chiffre des paramètres actifs. La même prudence vaut pour Mistral 7B et le choix d’un petit modèle : le coût se mesure sur un système, avec une tâche et une charge définies.
Pourquoi moins de calcul ne signifie-t-il pas moins de mémoire ?
Un modèle à mélange d’experts peut réduire le calcul actif tout en conservant un besoin important de mémoire pour ses poids et les contextes des requêtes.
| Ressource | Ce qu’elle sert à faire | Ce que le mélange d’experts change | Ce qu’il faut mesurer |
|---|---|---|---|
| Mémoire des poids | Rendre les paramètres accessibles | Les experts restent présents | Empreinte selon la précision |
| Calcul actif | Produire chaque jeton | Une partie des experts est utilisée | Débit sur la tâche réelle |
| Mémoire du contexte | Maintenir l’état des requêtes | Elle reste nécessaire | Effet des longueurs et de la concurrence |
| Exploitation | Maintenir un service disponible | Elle reste une responsabilité | Incidents, capacité et reprise |
Dans une architecture de déploiement simple, les poids résident en mémoire. D’autres stratégies de placement sont possibles, avec leurs propres échanges et délais. Elles doivent être testées plutôt que supposées gratuites.
La fenêtre de GPT-4 Turbo rappelle un autre poste : la longueur des entrées et des sorties. Une architecture parcimonieuse ne rend pas un contexte immense sans coût.
Le nombre d’experts activés varie-t-il avec la question ?
Dans Mixtral 8x7B, le routeur change les experts sélectionnés selon le jeton, mais le nombre retenu reste fixé à deux dans chaque couche concernée.
Cette nuance évite une erreur économique : attribuer une facture imprévisible à un nombre d’experts qui augmenterait sur les questions difficiles. L’identité des experts varie ; ce n’est pas, dans cette architecture, une liberté de mobiliser davantage d’experts à chaque jeton.
Les coûts observés peuvent néanmoins varier. La réponse peut être plus longue, la demande peut attendre en file et la charge peut modifier le débit. Les conditions de service d’une API peuvent aussi différer de celles d’un hébergement interne.
Je compare donc des profils complets : longueur des entrées, longueur des sorties, simultanéité et durée jusqu’à une réponse utilisable. Un coût moyen par appel masque ces différences. Pour une tâche déterminée, les unités utiles sont la réponse acceptée ou le document correctement traité, avec la correction humaine incluse.
Comment comparer une API et un hébergement interne ?
Comparer une API et un hébergement interne demande de mesurer la qualité obtenue, la charge attendue et les responsabilités d’exploitation, au-delà du coût apparent des jetons.
- Décrire les tâches et les limites : données autorisées, format attendu, erreurs bloquantes.
- Construire des cas de référence avec des réponses vérifiables, y compris des demandes ambiguës.
- Exécuter les variantes sur les mêmes entrées et conserver leurs sorties.
- Mesurer latence, débit et consommation de ressources à la charge prévue.
- Ajouter les dépenses d’intégration, de maintenance, de surveillance et de reprise.
- Décider qui exploite le service et quelle preuve déclenchera un réexamen.
Les benchmarks présentés par Mistral motivent un essai. Ils ne démontrent pas que Mixtral répondra mieux sur un corpus particulier. Une comparaison avec un modèle dense reste utile lorsque ce dernier suffit à la tâche.
La licence de Llama 2 illustre une autre dimension du choix : les conditions d’utilisation. Une disponibilité technique ne résume pas le contrat ni les responsabilités de l’organisation.
Que reste-t-il à construire autour d’un modèle ouvert ?
Un modèle ouvert fournit des poids et des possibilités de déploiement, tandis que le système doit encore assurer la recherche, les accès, les tests et la supervision.
La qualité du corpus reste décisive. Un document périmé ou une procédure contradictoire ne devient pas fiable parce que le modèle est plus capable. C’est le propos de l’article sur le corpus.
Une réponse documentaire exige aussi de retrouver les passages pertinents et d’expliquer leur provenance. Le mécanisme est distinct du mélange d’experts, comme le rappelle la récupération documentaire. L’architecture du modèle modifie son calcul ; elle ne remplace pas l’index de l’organisation.
Enfin, l’hébergement interne suppose une personne capable de diagnostiquer un incident et de restaurer le service. Il faut prévoir des accès, des versions, un suivi de capacité et un dispositif de retour à une configuration connue. Sans cela, télécharger des poids déplace une dépendance sans construire une autonomie.
Quand faut-il reprendre la décision d’hébergement ?
La décision d’hébergement doit être reprise lorsque les volumes, les contraintes de données ou l’offre disponible changent suffisamment pour modifier les résultats de la comparaison initiale.
Je préfère une règle écrite à une conviction durable. Par exemple : revoir le choix si la charge dépasse la capacité testée, si un fournisseur retire une version ou si une nouvelle contrainte interdit un transfert de données. Ces déclencheurs sont décidés pour le système concerné.
Une couche d’intégration limitée facilite la comparaison. Elle conserve la structure des entrées, les formats de sortie et la mesure des erreurs, même lorsque le moteur change. Il faut néanmoins vérifier les particularités du nouveau modèle.
Un audit IA peut objectiver cet arbitrage : qualité atteinte, charge complète et responsabilités. Je ne suppose ni la domination future du mélange d’experts ni un seuil de rentabilité universel. La décision actuelle doit rester défendable avec des données actuelles au moment où elle est prise.
Quelles erreurs faut-il éviter avec le mélange d’experts ?
Les erreurs à éviter consistent à confondre paramètres actifs et mémoire nécessaire, à prendre un benchmark pour une recette et à oublier la maintenance du système.
Le nombre de paramètres ne constitue pas une promesse de qualité. Une réponse doit être contrôlée sur les cas attendus, les langues utilisées et les formats réellement consommés par l’application.
Autre piège : comparer une API complète à une machine sans inclure le travail d’exploitation. La disponibilité, les mises à jour et les incidents ne disparaissent pas dans un coût matériel. À l’inverse, une API peut répondre à un besoin de volume limité sans immobiliser une infrastructure.
Je rends aussi visible le périmètre testé. Une bonne extraction de champs ne démontre pas une bonne analyse de contrat. Une réussite sur une question courte ne couvre pas les longues conversations. Le choix reste attaché à la tâche, même lorsque l’annonce du modèle suscite l’envie de tout déplacer.
Quelles questions fréquentes se poser avant d’utiliser Mixtral ?
Qu’est-ce qu’un mélange d’experts ?
Un mélange d’experts utilise un routeur pour sélectionner certains blocs de paramètres à chaque étape, afin de limiter le calcul sans mobiliser tous les experts. Le mécanisme se distingue d’un assemblage de professionnels spécialisés.
Mixtral active-t-il davantage d’experts sur les questions difficiles ?
Mixtral 8x7B sélectionne deux experts parmi huit par couche et par jeton ; la question peut changer leur identité, mais pas ce nombre prévu. La longueur de réponse influence en revanche le travail effectué.
Peut-on dimensionner la mémoire avec les seuls paramètres actifs ?
Les paramètres actifs ne suffisent pas à dimensionner la mémoire, car les poids disponibles, les contextes et les requêtes simultanées doivent aussi être pris en compte. Il faut tester la configuration.
Les poids ouverts garantissent-ils l’autonomie ?
Les poids ouverts donnent des possibilités de contrôle, mais l’autonomie dépend aussi des compétences, de l’exploitation et des composants qui entourent le modèle dans le système. Elle doit être construite.
Faut-il choisir Mixtral parce que son architecture est différente ?
Une architecture différente justifie une comparaison, mais le choix de Mixtral doit reposer sur la qualité des résultats et le coût complet des tâches visées. Un modèle plus simple peut suffire.
Que faut-il conserver après la comparaison ?
Après la comparaison, conservez les cas, les sorties, les mesures et la décision datée pour pouvoir reprendre l’arbitrage lorsque le contexte ou l’offre change. Le seuil de réexamen doit rester explicite.
Lectures complémentaires : modèles ouverts et souveraineté, le prix de l’inférence et l’observabilité des systèmes IA.