Qu’est-ce qu’une formation à l’IA générative qui produit un usage durable ?
Une formation à l’IA générative qui produit un usage durable est une formation dont les participants utilisent encore l’outil, sur une tâche qu’ils répètent, plusieurs semaines après la session. Tout le reste, la qualité des supports, l’aisance de l’animateur, l’enthousiasme de fin de journée, n’en est qu’un moyen.
Cette définition écarte une grande partie de l’offre courante, qui vise à faire découvrir les grands modèles et à transmettre des bonnes pratiques de formulation. Ces contenus ont une valeur de culture générale ; ils ne transforment pas une manière de travailler.
Une formation orientée usage se reconnaît à trois traits. Elle part du travail réel des participants plutôt que d’exemples préparés. Elle enseigne autant les limites de l’outil que ses capacités. Et elle se termine par un suivi, parce que les vraies difficultés n’apparaissent qu’une fois la personne seule devant son dossier. C’est cette approche qui structure les formations à l’IA que je conduis.
Pourquoi les formations centrées sur les outils ne changent-elles pas les pratiques ?
Les formations centrées sur les outils échouent parce qu’elles transmettent une culture générale sur l’IA générative, alors que les participants ont besoin d’une capacité applicable à leur propre travail. C’est ce que j’ai arrêté de faire.
Mes premières sessions ressemblaient à ce qu’on trouvait partout : une présentation des grands modèles, une démonstration, une liste de bonnes pratiques de formulation, un temps de questions.
Les retours à chaud étaient excellents. L’usage trois mois plus tard était quasi nul. Ce décalage m’a occupé un moment, jusqu’à ce que la raison devienne évidente : j’avais transmis une culture générale, pas une capacité.
Le mécanisme est simple. Une démonstration réussie montre ce que l’outil sait faire sur un cas choisi pour réussir. De retour à son poste, le participant affronte un cas qui n’a pas été choisi : un document long, un vocabulaire maison, une contrainte de confidentialité. Le premier résultat décevant suffit à refermer l’onglet. Les raisons de ces premiers échecs sont presque toujours les mêmes, et elles sont détaillées dans pourquoi vos premiers essais échouent.
Pourquoi faire travailler les participants sur leurs propres fichiers ?
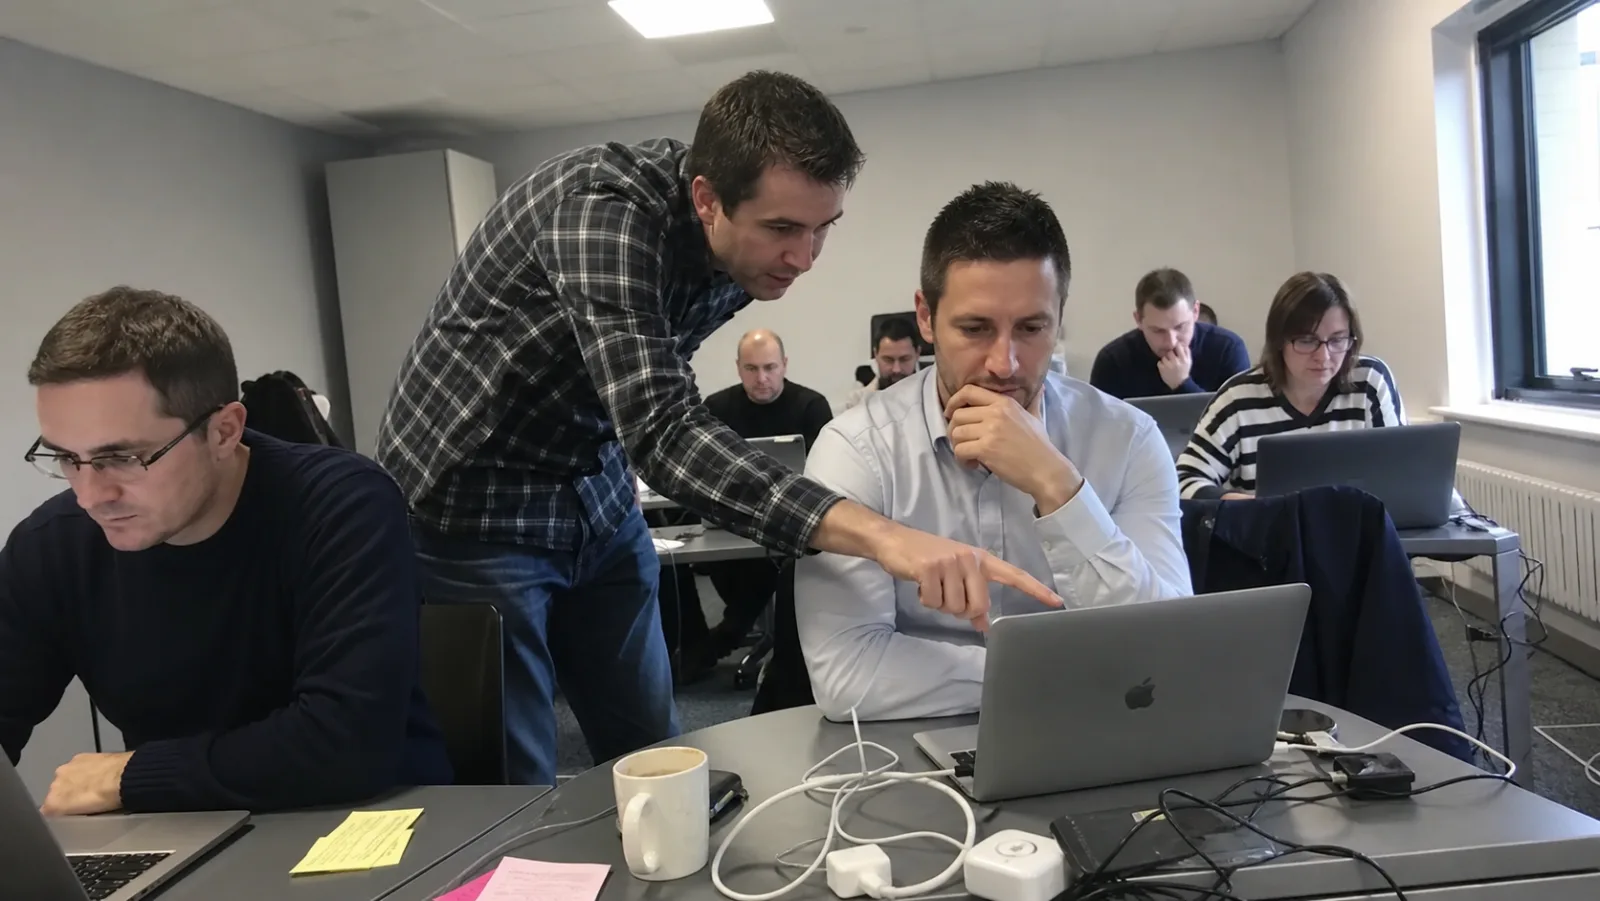
Faire travailler les participants sur leurs propres fichiers rend la formation à l’IA générative concrète, exigeante et utile le jour même, parce que chacun juge le résultat sur un travail qu’il connaît. C’est la règle qui a tout changé : leurs fichiers, pas les miens.
Je demande maintenant aux participants d’arriver avec un document réel sur lequel ils travaillent cette semaine. Un vrai. Pas un exemple.
Cela produit trois effets immédiats. La séance devient concrète, parce que chacun voit son propre travail. Elle devient inégale, parce que certains cas résistent, et c’est précisément là que la formation prend de la valeur. Et elle devient utile le jour même : la personne repart avec un livrable qu’elle allait devoir produire de toute façon.
Le taux d’usage à trois mois n’est plus comparable.
Cette règle impose une précaution : tous les documents ne peuvent pas être confiés à n’importe quel outil. Avant la session, il faut fixer avec les participants ce qui peut entrer dans un prompt et ce qui doit rester dehors, selon les principes posés dans ce qu’on a le droit de mettre dans un prompt. Un service juridique travaillera sur un contrat anonymisé ; une équipe commerciale sur une proposition dont on a retiré les noms et les montants.
Les cinq choses que je fais systématiquement
- Commencer par un échec. Je montre l’outil qui se trompe, sur un cas de leur métier, dans les dix premières minutes. Ça installe la vigilance avant l’enthousiasme.
- Interdire la copie sans lecture. La règle est explicite : on ne transmet jamais une sortie qu’on n’a pas relue et dont on ne pourrait pas répondre. Elle prolonge ce qu’on ne délègue jamais à un modèle.
- Travailler sur le vrai corpus, avec les vraies contraintes de confidentialité, quitte à réduire le périmètre.
- Nommer un référent par équipe, présent en session, qui devient le point de contact ensuite.
- Revenir à trois semaines. C’est là que les vraies questions arrivent, parce que les gens ont essayé et buté.
Comment organiser une formation à l’IA générative étape par étape ?
Une formation à l’IA générative efficace s’organise en six étapes, de la collecte des documents avant la session jusqu’à la mesure de l’usage six semaines plus tard. Chaque étape a un objectif précis et un livrable vérifiable.
- Cadrer le public et le besoin. Identifier qui vient et pour quelle décision ou quelle tâche.
- Collecter la matière en amont. Demander à chaque participant un document réel de la semaine, vérifier qu’il peut être utilisé sans exposer de données protégées, et le rappeler plusieurs fois.
- Ouvrir sur une erreur. Montrer l’outil qui se trompe sur un cas du métier, avant toute démonstration réussie.
- Faire produire, pas regarder. Chacun traite son propre document, relit la sortie, la corrige et en tire un livrable.
- Formaliser les usages retenus. Chaque participant note les tâches répétitives qu’il confiera à l’outil ; le référent d’équipe consolide la liste.
- Revenir et mesurer. Une reprise à trois semaines traite les blocages réels ; un relevé à six semaines compte les usages installés.
Cette séquence n’a rien de sophistiqué. Sa force tient à ce qu’elle refuse de s’arrêter le soir de la session.
Faut-il former séparément la direction, les managers et les équipes opérationnelles ?
Il faut former séparément la direction, les managers et les équipes opérationnelles, parce que ces trois publics ont des besoins qui n’ont rien à voir et qu’un contenu commun en fait perdre deux. Le découpage se fait par besoin, pas par niveau technique.
Une direction générale a besoin d’arbitrer : où mettre l’argent, quel risque on prend, quelles obligations arrivent. Un manager a besoin de réorganiser un processus : ce qui disparaît, ce qui reste, qui valide. Une équipe opérationnelle a besoin de gagner du temps dès la semaine suivante.
Mettre ces trois publics dans la même salle avec le même contenu garantit que deux d’entre eux perdent leur journée. C’est pourtant ce que proposent la plupart des catalogues.
| Public | Question centrale | Contenu prioritaire | Ce qu’il doit emporter |
|---|---|---|---|
| Direction générale | Où investir et quel risque accepter ? | Cas d’usage chiffrables, risques, obligations à venir | Une liste d’arbitrages à rendre |
| Managers | Comment réorganiser un processus ? | Étapes qui disparaissent, points de validation, rôles | Un processus redessiné avec ses contrôles |
| Équipes opérationnelles | Comment gagner du temps dès lundi ? | Pratique sur leurs documents, relecture, limites | Un livrable produit et un usage répété identifié |
Pour le premier public, la question n’est presque jamais technique. Elle porte sur la gouvernance et la décision, comme le montre ce que ChatGPT a changé en comité de direction.
L’indicateur que je regarde, et le seul
Pas la satisfaction à chaud, qui est toujours bonne. Le nombre de personnes qui, six semaines après, ont intégré l’outil dans une tâche qu’elles répètent. C’est mesurable, c’est ingrat, et c’est le seul chiffre qui prédit quoi que ce soit.
Pourquoi la formation fait-elle partie du déploiement d’un système d’IA ?
La formation fait partie du déploiement d’un système d’IA, parce qu’un système que personne ne sait faire tourner n’est pas en production : il est en sursis. Je ne la considère plus comme une prestation séparée.
C’est pour cela que la dernière phase de mes missions consiste à faire tenir l’outil par les équipes, devant moi, avant que je parte. Tant que ce n’est pas démontré, la mission n’est pas finie.
Concrètement, la démonstration porte sur des gestes précis : alimenter l’outil avec les bons documents, reconnaître une réponse douteuse, savoir à qui signaler un comportement anormal. Une équipe qui ne les maîtrise pas abandonnera l’outil au premier incident, ou continuera à l’utiliser sans voir qu’il se trompe.
Que faut-il enseigner maintenant que chacun peut créer un assistant ?
Quand chacun peut créer un assistant en dix minutes, la compétence à transmettre n’est plus « créer » mais « savoir quand un assistant ne suffit plus ». C’est le déplacement pédagogique majeur de cette période.
Apprendre à rédiger une consigne prend une heure et devient rapidement obsolète, les modèles étant de plus en plus tolérants aux formulations approximatives.
Apprendre à reconnaître qu’un usage a changé de nature, qu’il engage l’organisation, qu’il touche des données protégées, qu’il est devenu quotidien pour une équipe entière, reste utile durablement. C’est le contenu que je place désormais en premier, et il rejoint ce qui est décrit dans les trois gestes qui font tenir un système.
Un exemple générique aide à fixer l’idée. Un assistant personnel qui reformule des courriels n’engage que son auteur. Le même assistant, partagé avec une équipe support qui s’en sert pour répondre aux clients, engage l’organisation : il faut alors une base documentaire maîtrisée, une relecture et un responsable. Le passage d’un cas à l’autre doit être repéré par les participants eux-mêmes ; c’est souvent le moment où l’on passe d’une consigne à une véritable architecture de récupération documentaire.
Comment savoir si une formation à l’IA générative a servi ?
Une formation à l’IA générative a servi si des personnes utilisent encore l’outil six semaines plus tard, et la note de satisfaction en fin de session ne le dit pas. Les deux ne corrèlent pas.
Six semaines est un horizon pratique, pas une norme : sur les sessions que j’ai animées, c’est à peu près le délai au bout duquel l’enthousiasme retombe et où seuls subsistent les usages qui apportent réellement quelque chose. Le raisonnement complet figure dans écrire la fiche d’un système d’IA, pour la partie documentation, et la mesure d’usage se construit comme décrit dans mesurer le coût par fonctionnalité.
La mesure reste légère : le référent de chaque équipe demande à chaque participant sur quelle tâche répétée il utilise l’outil. Une réponse vague vaut une absence d’usage.
Quelles erreurs éviter quand on forme une organisation à l’IA générative ?
Les erreurs les plus fréquentes dans une formation à l’IA générative consistent à former sur des exemples inventés, à mélanger les publics et à s’arrêter le soir de la session. Elles ont en commun de privilégier le confort de l’animation sur l’usage réel.
- Former à un outil plutôt qu’à des tâches. Les interfaces changent vite ; la capacité à juger une sortie sur son propre travail reste.
- Montrer uniquement des réussites. Une démonstration sans erreur prépare mal à la première réponse fausse, qui arrive toujours.
- Confondre adhésion et adoption. Une salle convaincue n’est pas une équipe qui a changé sa manière de travailler.
- Ne prévoir aucun relais. Sans référent identifié, chaque question restée sans réponse devient une raison d’abandonner.
Questions fréquentes
Que faut-il enseigner en priorité ?
À reconnaître qu’un usage a changé de nature : qu’il engage l’organisation, touche des données protégées ou est devenu quotidien pour une équipe. La rédaction de consignes devient obsolète, ce discernement non.
Pourquoi travailler sur les fichiers des participants ?
Parce qu’un participant qui connaît son document juge immédiatement la qualité du résultat, repère l’erreur et perçoit la limite. Sur un exemple fabriqué, il n’a aucun repère et retient une impression.
Comment mesurer l’effet d’une formation ?
Par le nombre de personnes qui utilisent encore l’outil six semaines plus tard, sur une tâche qu’elles répètent. La note de satisfaction en fin de session est toujours bonne et ne prédit rien.
Combien de temps doit durer une formation à l’IA générative ?
Une journée sur les propres documents des participants suffit à installer un premier usage, à condition d’être suivie d’une reprise à trois semaines. Des demi-journées espacées conviennent mieux aux tâches courtes et répétitives. La durée compte moins que le suivi.
Peut-on utiliser de vrais documents malgré la confidentialité ?
Oui, à condition de fixer avant la session ce qui peut être confié à l’outil utilisé. On travaille sur des documents anonymisés ou sur un périmètre réduit plutôt que sur des exemples inventés. Réduire le périmètre coûte moins que perdre le réalisme.