Qu’est-ce que le coût par fonctionnalité d’un système d’IA ?
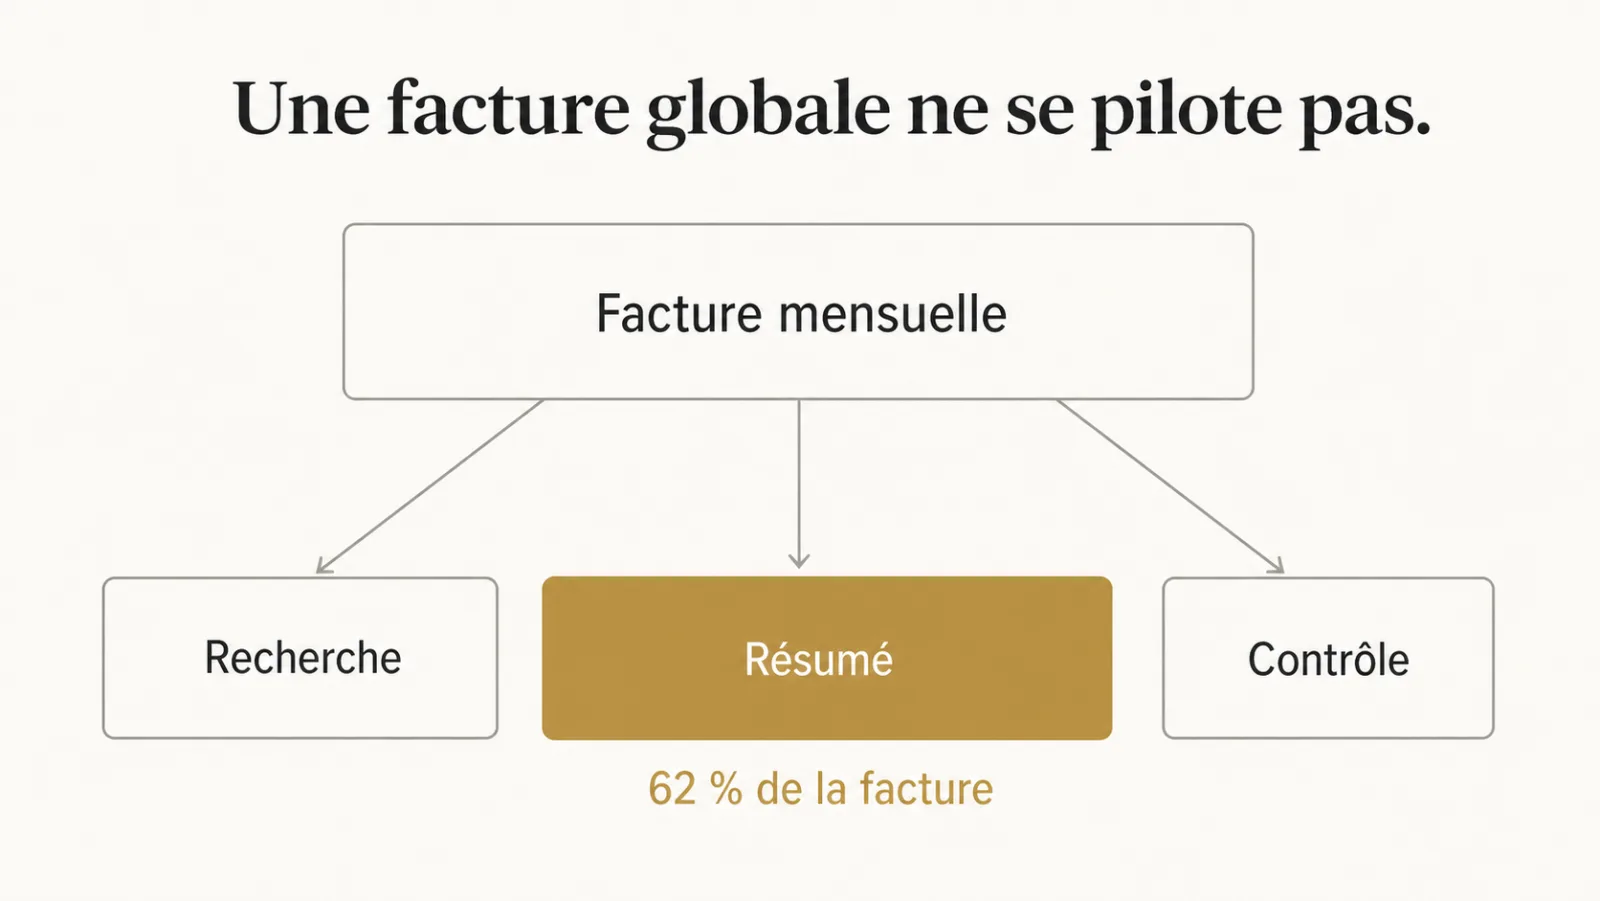
Le coût par fonctionnalité d’un système d’IA est la part de la dépense en appels de modèles attribuée à chaque usage précis du produit, synthèse, recherche, conversation, traitement de fond, à partir d’une étiquette posée sur chaque appel. C’est l’unité qui permet de piloter, là où la facture globale ne permet que de constater.
Un total mensuel permet de suivre la dépense globale ; il ne suffit pas à identifier les fonctionnalités à corriger. Il faut relier les coûts aux tâches et aux usages observés.
Une facture élevée peut ouvrir plusieurs pistes. Quelqu’un propose de réduire le contexte, quelqu’un d’autre de changer de modèle, un troisième de limiter l’usage. Chacune de ces propositions peut être bonne ou inutile, et rien ne permet de trancher.
Attribuer la dépense à chaque fonctionnalité transforme cette discussion en décision. Dans un exemple fictif, une fonctionnalité représentant les deux tiers de la facture pour trois utilisateurs par semaine mérite une revue. La décision dépend ensuite de sa valeur métier, pas seulement de son coût. C’est la question de fond posée dans où part réellement un budget d’IA.
Comment attribuer les appels aux fonctionnalités ?
Attribuer les appels aux fonctionnalités demande d’enregistrer leur origine, leur consommation et leur tarif de référence, puis de relier les appels successifs à la tâche qui les a déclenchés. L’effort dépend de l’instrumentation disponible.
- Étiqueter chaque appel avec la fonctionnalité, le type de tâche et un identifiant de requête, de préférence sans données personnelles inutiles.
- Enregistrer les volumes facturables au retour : entrée, sortie, cache lorsque disponible, outils payants et état de réussite ou d’interruption.
- Conserver le tarif et la version du modèle utilisés pour l’estimation, avec l’horodatage et les éventuelles reprises.
- Rapprocher l’estimation de la facture réelle, en documentant les écarts et la part des appels sans étiquette.
Une tâche utilisateur peut déclencher plusieurs appels. Sans identifiant commun, une reprise ressemble à une nouvelle demande et le coût utile reste invisible. Les traitements programmés ont également besoin d’une étiquette, même sans utilisateur connecté.
Les journaux techniques peuvent fournir une base, sans que toute journalisation réponde automatiquement aux mêmes exigences. Les contrôles à préparer avant une échéance juridique dépendent du système et de son rôle. La mesure financière s’articule ici avec l’observabilité d’un système d’IA et les réflexions sur ce qui doit exister avant l’échéance.
Quelles vues produire pour comprendre la dépense ?
Les vues à produire relient les coûts aux fonctionnalités, aux usages, aux volumes de contexte et à la distribution des requêtes, avec un critère stable d’acceptation des tâches.
- Coût par fonctionnalité, avec volume, part d’appels étiquetés et tâches acceptées.
- Coût par utilisateur ou groupe autorisé, afin de comprendre les usages intensifs sans conclure à un abus.
- Jetons moyens par requête, suivis avec la distribution et les changements de configuration.
- Coût au quantile 95, complété par les cas extrêmes et les dépassements. Voir la réflexion devient un budget.
Comment lire ces quatre vues ?
Les quatre vues de coût répondent à des questions différentes, et leurs écarts doivent être interprétés avec le volume de tâches et la qualité obtenue. Elles orientent une investigation, pas une correction automatique.
| Vue | Question | Signal à examiner | Action possible |
|---|---|---|---|
| Coût par fonctionnalité | Où part la dépense ? | Ligne coûteuse pour peu d’usage | Vérifier sa valeur et son architecture |
| Coût par utilisateur | Quels usages consomment ? | Activité intensive isolée | Comprendre le besoin et les droits |
| Jetons moyens par requête | L’entrée change-t-elle ? | Hausse sans évolution attendue | Comparer les contenus envoyés |
| Coût au quantile 95 | Que coûtent les requêtes hautes ? | Écart avec médiane et historique | Examiner appels, reprises et plafonds |
Un quantile élevé ne signale pas à lui seul une anomalie : une tâche longue peut être utile et correctement exécutée. Les événements les plus rares peuvent aussi lui échapper. Je conserve donc le maximum, les dépassements de budget et le nombre d’observations, en complément de la distribution.
Quels écarts la mesure peut-elle révéler ?
La mesure peut révéler une dépense concentrée sur certaines fonctionnalités, mais son importance et ses causes doivent être établies dans les journaux du système étudié. Aucun pourcentage universel n’est établi ici.
Je cherche notamment trois situations : une synthèse qui renvoie tout le dossier à chaque demande, une conversation dont l’historique transmis s’allonge, ou un traitement de fond qui s’exécute plus souvent que nécessaire. Ce sont des pistes de diagnostic, pas un classement de fréquence démontré.
Pour un traitement programmé, vérifier le besoin métier de sa cadence et la possibilité de ne traiter que les documents modifiés. Une cadence horaire peut être justifiée ; elle ne l’est pas simplement parce qu’elle a été choisie pendant le prototype.
La correction doit préserver le résultat attendu. Réduire la fréquence peut diminuer la facture tout en rendant les réponses trop anciennes. Le délai d’intervention dépend alors de l’architecture, des exigences de fraîcheur, de la sécurité et de la recette.
Dans quel ordre corriger une fonctionnalité trop coûteuse ?
Je commence par identifier la cause de la dépense, puis je compare les leviers possibles sur les mêmes tâches acceptées, sans imposer un ordre universel d’optimisation. Le risque de qualité dépend du changement réalisé.
La sélection du contexte, le cache et le routage vers un autre modèle sont trois leviers distincts. Réduire l’entrée peut retirer une pièce indispensable ; un cache mal invalidé peut conserver une information périmée ; un modèle moins cher peut nécessiter davantage de reprises.
Je teste séparément chaque modification pour connaître son effet. La démarche prolonge réduire le contexte envoyé et la mise en cache du contexte. Le gain doit inclure la mise en place et l’exploitation, pas uniquement l’économie sur un appel.
Prioriser les lignes dont le coût, la valeur et l’effort justifient une intervention. Une fonctionnalité peu utilisée peut éviter une erreur importante. À l’inverse, une fonction populaire peut être remplaçable par un traitement plus simple.
Je conserve la configuration précédente pour la comparaison et je définis les critères d’arrêt de l’essai. L’optimisation cesse d’être utile lorsque son gain attendu ne justifie plus son effort ou sa dégradation de service.
Quels indicateurs conserver après une optimisation ?
Après une optimisation, conserver les volumes, les reprises et le coût des tâches acceptées permet de détecter une dérive et d’en rechercher la cause sans se limiter à la facture totale.
Conserver les volumes d’entrée, les reprises, les dépassements de budget et le coût des tâches acceptées. Une moyenne qui monte appelle une lecture du contenu et des usages : elle ne prouve pas, à elle seule, que le contexte est devenu inutile.
Comment vérifier le coût réel d’une tâche ?
Le coût réel d’une tâche se vérifie en rapprochant les dépenses de tous ses appels du résultat accepté, tout en séparant consommation technique et temps humain nécessaire à la validation. Le tarif par jeton ne suffit pas.
L’annonce OpenAI du cache API d’octobre 2024 distingue entrées ordinaires, entrées mises en cache et sorties. L’annonce de Claude 3.7 de février 2025 inclut les jetons de réflexion dans le prix de sortie. Ces exemples datés expliquent pourquoi des catégories de consommation différentes doivent être suivies ; ils ne fixent pas les tarifs de votre contrat.
Conserver pour chaque lot le tarif applicable, les volumes facturés, les outils, les reprises et les interruptions. Le coût du lot divisé par le nombre de tâches acceptées donne un indicateur utile ; sans tâche acceptée, ce ratio n’est pas calculable.
Fixer le critère d’acceptation avant l’essai évite de changer la définition du succès pour défendre une économie. Le temps de relecture et de correction doit apparaître à côté du coût technique. Une recette de migration de modèle prolonge ce principe de comparaison.
Que permet la mesure du coût par fonctionnalité face à une direction ?
La mesure du coût par fonctionnalité permet à une direction de rapprocher dépense, usage et valeur métier, avec des hypothèses explicites et des résultats qu’elle peut examiner. Elle complète le pilotage du total mensuel.
Dans un exemple fictif, une fonctionnalité coûte huit cents euros par mois pour quatre utilisateurs. Ce chiffre justifie une question, pas un arrêt automatique. Si elle évite une erreur coûteuse, sa valeur peut dépasser largement cette dépense ; encore faut-il établir ce bénéfice.
Je présente donc le coût, les tâches acceptées, le temps humain et les incidents. Je sépare les résultats observés des bénéfices supposés et j’indique ce qui manque pour décider.
Ces montants ne décrivent aucun client. Ils illustrent un arbitrage qui doit intégrer le risque et la valeur, au-delà du seul coût réel d’un système d’IA en production.
La mesure permet aussi de défendre une fonction utile lorsque le budget est discuté. Elle n’en garantit pas le maintien : elle rend la décision documentée et les conséquences visibles.
Quelles erreurs éviter en mesurant le coût d’un système d’IA ?
Les erreurs fréquentes en mesurant le coût d’un système d’IA consistent à raisonner en moyenne, à oublier les traitements de fond et à optimiser le coût sans contrôler la qualité. Chacune fausse la décision qui suit.
- Suivre la moyenne seule, qui masque les requêtes pathologiques.
- N’étiqueter que les appels déclenchés par les utilisateurs, en oubliant les traitements programmés.
- Changer de modèle pour économiser sans rejouer le jeu de tests sur les tâches acceptées.
- Mesurer une fois puis arrêter, alors que le contexte et les usages évoluent.
Pour poser l’instrumentation et produire une première lecture des quatre vues, un audit IA part des journaux d’appels existants.
Lectures complémentaires : migration Sonnet 5.5. Ces liens complètent la navigation du site.
Quelles questions poser avant d’optimiser la dépense d’IA ?
Avant d’optimiser la dépense d’IA, il faut vérifier l’attribution des appels, le résultat attendu et les risques de chaque levier sur les tâches réellement acceptées par les utilisateurs.
Questions fréquentes
Comment attribuer la dépense d’IA à chaque fonctionnalité ?
En étiquetant chaque appel dans la couche d’abstraction avec la fonctionnalité, le type de tâche et l’identifiant de requête, puis en enregistrant jetons envoyés, produits et coût. Le délai dépend du nombre d’outils et de l’instrumentation existante.
Que révèle la mesure du coût par fonctionnalité ?
Elle peut révéler des tâches de fond trop fréquentes, des contextes volumineux ou des reprises coûteuses. Il faut établir leur poids à partir des appels observés.
Jusqu’où faut-il optimiser ?
Jusqu’au point où le gain mesuré, la valeur métier et la réduction du risque justifient l’effort. Il n’existe pas de règle universelle limitant le travail aux trois premières lignes.
Quel indicateur conserver après la campagne ?
Le nombre moyen de jetons envoyés par requête, suivi dans le temps. Suivez aussi les reprises et le coût des tâches acceptées pour détecter les dérives de contexte et de configuration.
Pourquoi suivre le quantile 95 plutôt que la moyenne ?
Le quantile élevé aide à examiner les requêtes coûteuses, mais n’identifie pas toutes les anomalies. Le compléter par la médiane, les maximums, les dépassements et un volume d’observations suffisant.
Faut-il commencer par changer de modèle pour réduire la facture ?
Identifier d’abord la cause de la dépense et comparer les leviers sur les mêmes tâches. Réduction de contexte, cache et changement de modèle ont chacun des risques à vérifier, sans ordre universel.