Qu’est-ce qu’un modèle de raisonnement ?
Un modèle de raisonnement est un modèle de langage entraîné à produire une réflexion intermédiaire avant sa réponse finale, ce qui améliore la justesse sur les problèmes difficiles au prix de jetons et de temps supplémentaires. La réflexion n’est plus gratuite : elle devient une dépense.
Un modèle classique produit sa réponse directement, jeton après jeton. Un modèle de raisonnement commence par une phase de travail interne : il décompose le problème, essaie une piste, la vérifie, revient en arrière si elle échoue. Cette phase peut ne pas être montrée à l’utilisateur, mais elle est calculée et facturée comme des jetons produits.
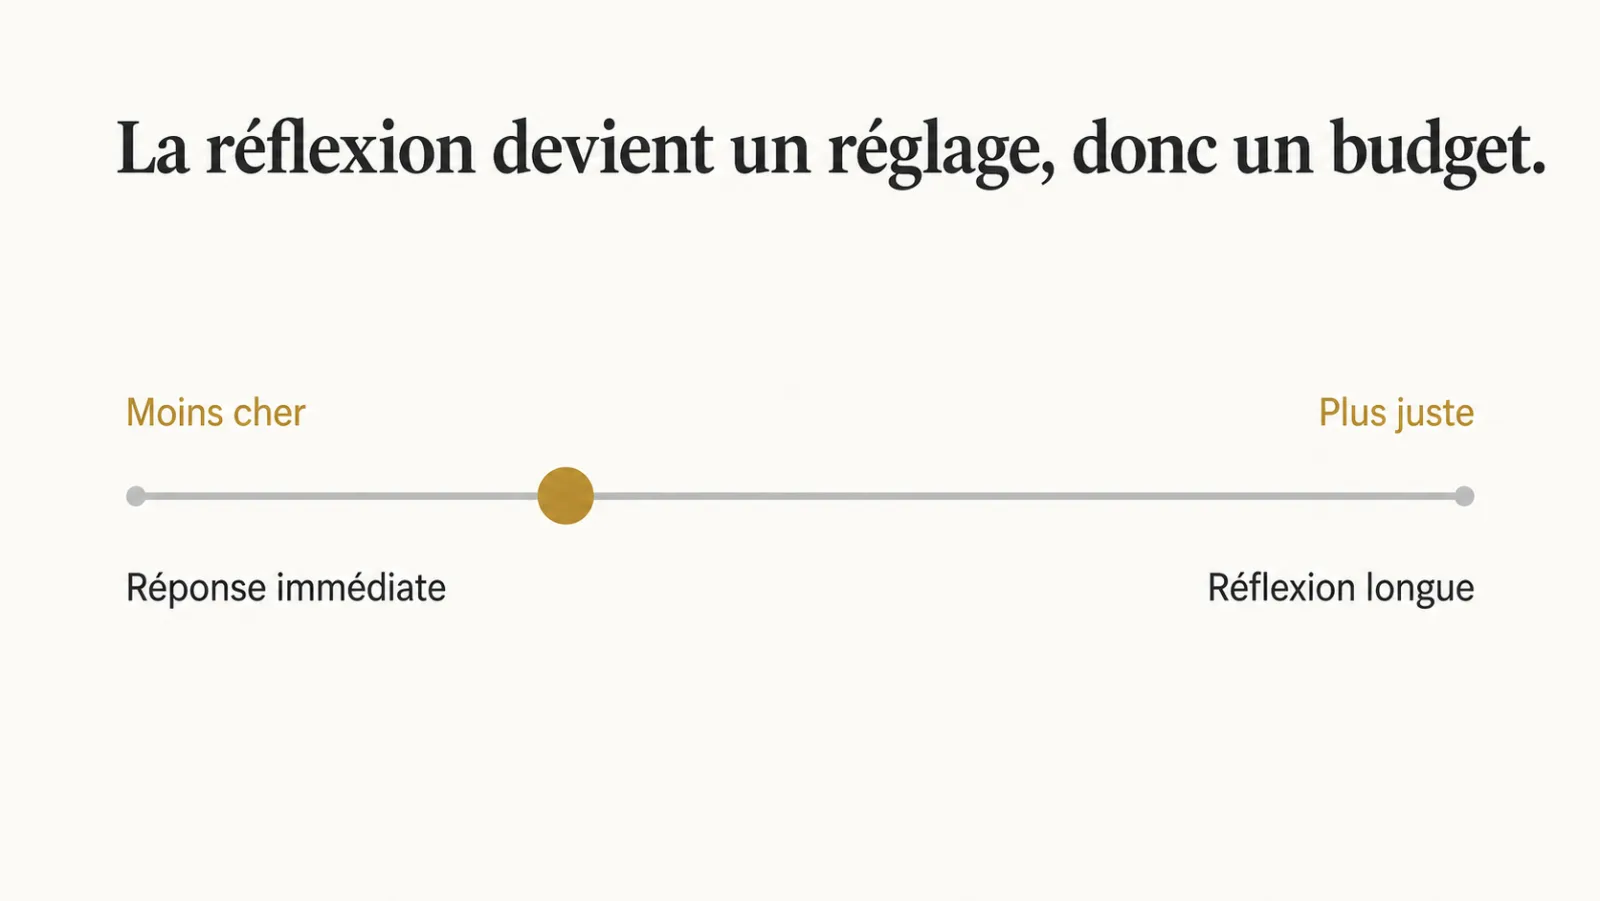
L’idée centrale est qu’on peut acheter de la qualité au moment de la réponse, en consacrant plus de calcul à chaque question, au lieu de l’obtenir uniquement par un modèle plus gros. Cela transforme la justesse en grandeur réglable, et donc en arbitrage économique.
Comment un modèle de raisonnement change-t-il la structure du coût ?
Un modèle de raisonnement consomme des jetons pour réfléchir avant de répondre, ce qui rend le coût d’une requête dépendant de sa difficulté et non plus seulement de sa longueur. C’est une rupture pour la prévision budgétaire.
Jusqu’ici, le coût d’un appel se calculait à l’avance : tant de jetons envoyés, tant de jetons produits. Il devenait possible d’estimer une facture mensuelle avec précision.
Avec un modèle qui réfléchit, une question difficile peut consommer beaucoup plus qu’une question simple de longueur identique, parfois d’un ordre de grandeur. La dispersion devient forte, et la moyenne cesse d’être un bon prédicteur.
La conséquence est qu’il faut mesurer au quantile élevé, comme pour la latence, et prévoir un plafond par requête. Les leviers d’économie habituels changent aussi de poids : la mise en cache du contexte réduit le coût de ce qu’on envoie, pas celui de la réflexion produite.
Quelles tâches justifient de payer la réflexion d’un modèle de raisonnement ?
La réflexion d’un modèle de raisonnement apporte un gain net sur les tâches à plusieurs étapes contraintes, et presque rien sur les tâches documentaires ordinaires. Cette distinction évite de payer un supplément généralisé pour un bénéfice localisé.
Les tâches qui en profitent partagent une structure : plusieurs contraintes qui interagissent, un résultat vérifiable, et une solution qui ne se trouve pas du premier coup. Un calcul de conformité croisant plusieurs règles, une planification sous contraintes, la détection d’une incohérence entre trois documents.
Les tâches qui n’en profitent pas sont celles où la réponse est présente dans le contexte : retrouver une clause, résumer un document, reformuler. Aucun raisonnement supplémentaire ne fera apparaître une information qui n’a pas été récupérée. C’est le point développé dans le RAG, la seule architecture qui tienne.
C’est l’erreur la plus fréquente que je rencontre : utiliser un modèle de raisonnement pour compenser une mauvaise récupération. Cela coûte cher et ne corrige rien.
| Type de tâche | Exemple générique | Réflexion utile ? | Raison |
|---|---|---|---|
| Recherche d’information | Retrouver une clause dans un contrat | Non | La réponse est dans le contexte ou n’y est pas |
| Synthèse, reformulation | Résumer un rapport, réécrire un courriel | Non | Aucune étape logique à enchaîner |
| Classification simple | Router un ticket vers une équipe support | Rarement | Un modèle rapide suffit si les catégories sont claires |
| Contrôle croisé | Vérifier un dossier contre plusieurs règles | Oui | Plusieurs contraintes interagissent |
| Planification | Construire un planning sous contraintes | Oui | La solution exige des essais et des retours |
| Détection d’incohérences | Comparer trois documents qui se contredisent | Oui | Il faut raisonner sur des écarts, pas retrouver un fait |
Comment doser le curseur en pratique
- Par type de tâche, pas globalement. Un système mixte doit avoir plusieurs réglages, un par famille d’appels.
- Sur mesure du gain réel : comparer le taux d’erreur avec et sans réflexion sur le même jeu de cas. Le gain est parfois nul.
- Avec un plafond par requête, faute de quoi une question mal posée peut consommer un budget entier.
- En surveillant la dispersion, pas la moyenne. Voir l’observabilité des systèmes IA.
Comment décider d’activer la réflexion sur une tâche ?
Décider d’activer la réflexion sur une tâche suit une méthode en cinq étapes, qui commence par vérifier la récupération et se termine par une décision datée et documentée. Elle évite de régler le curseur à l’intuition.
- Vérifier le contexte. Sur les cas en échec, contrôler que l’information nécessaire figure bien dans ce qui a été fourni au modèle. Si elle manque, le problème est la récupération, et l’étude s’arrête là.
- Isoler la famille de tâches. Regrouper les appels qui partagent une même structure, par exemple tous les contrôles de conformité, et traiter chaque famille séparément.
- Mesurer sur le même jeu de cas. Faire passer le jeu de tests avec un modèle rapide puis avec un modèle de raisonnement, et relever le taux d’erreur, le coût par requête au quantile élevé et le temps de réponse.
- Confronter le gain à l’usage. Un gain de justesse ne vaut que si la latence est acceptable pour l’usage et si le surcoût reste inférieur au coût des erreurs évitées.
- Documenter et plafonner. Noter le réglage retenu, le gain mesuré et la date, puis fixer un plafond de jetons par requête.
Cette méthode suppose un jeu de tests existant. Sans lui, aucune des étapes trois à cinq n’est praticable, ce qui renvoie à l’évaluation continue.
Pourquoi la latence limite-t-elle les modèles de raisonnement en usage interactif ?
Un modèle de raisonnement peut mettre des dizaines de secondes à répondre, ce qui l’exclut de la plupart des usages conversationnels où un utilisateur attend la réponse. Cette contrainte est plus limitante que le coût dans la plupart des projets.
Le raisonnement se paie en temps autant qu’en jetons. Une réponse qui arrive après quarante secondes est inutilisable dans une interface où l’utilisateur attend, quelle que soit sa qualité. C’est le mécanisme d’abandon décrit dans la latence devient un critère de conception.
La configuration qui fonctionne consiste à réserver la réflexion aux traitements différés : une analyse produite pendant la nuit, un contrôle lancé après dépôt d’un dossier, une revue hebdomadaire. Dans ces contextes, quarante secondes ne coûtent rien.
Pour l’interactif, la réponse reste un modèle rapide sur un contexte bien récupéré. C’est moins impressionnant et nettement plus utile.
Le réflexe qui évite la dépense inutile
Avant d’activer la réflexion sur une tâche, vérifier que l’information nécessaire est bien présente dans le contexte fourni. Dans la plupart des cas que je rencontre, une mauvaise réponse vient d’une récupération incomplète, pas d’un défaut de raisonnement. C’est un constat de terrain, pas une statistique : il se vérifie en quelques minutes sur les cas en échec.
Qu’est-ce que les modèles de raisonnement changent dans la conception des systèmes d’IA ?
Avec les modèles de raisonnement, la qualité cesse d’être une propriété du modèle pour devenir un réglage par tâche, ce qui déplace la compétence des équipes vers l’arbitrage. C’est le changement de fond.
Auparavant, améliorer un système signifiait changer de modèle ou améliorer le prompt. Désormais, une troisième voie existe : payer davantage de réflexion là où elle rapporte.
Cette voie n’est exploitable qu’avec un jeu de tests, parce qu’elle exige de comparer un gain de justesse à un surcoût. Sans mesure, le curseur se règle par intuition, ce qui produit invariablement le même résultat : réflexion maximale partout, facture multipliée, gain marginal.
La discipline à installer est donc celle de l’arbitrage documenté : pour chaque famille de tâches, le réglage choisi, le gain mesuré, la date de la décision.
Dans l’architecture, cela prolonge la logique des paliers décrite dans Claude 3 : choisir le palier, pas le modèle. Un système bien conçu route déjà les appels simples vers un petit modèle, devenu très peu cher comme le montre GPT-4o mini. Le modèle de raisonnement s’ajoute comme un palier supplémentaire, réservé aux familles de tâches où la mesure le justifie.
Comment présenter le budget de réflexion à une direction ?
Le budget de réflexion se présente à une direction comme un curseur entre coût et justesse, pas comme une caractéristique de modèle, ce qui évite les deux malentendus habituels. La décision redevient alors un arbitrage ordinaire.
Le premier malentendu consiste à comprendre « le modèle réfléchit » comme une amélioration générale et gratuite, et à demander qu’elle soit activée partout. Le second consiste à l’écarter comme un gadget coûteux.
Présentée comme un curseur, la décision redevient ordinaire. Pour prendre un exemple purement illustratif : si, sur une famille de tâches, la mesure montre que payer trois fois plus divise le taux d’erreur par deux, cela peut valoir le coup ; si, sur une autre, le gain mesuré est nul, on ne paie pas. Les chiffres réels sortent du jeu de tests de chaque système. Une direction tranche très bien ce type d’arbitrage quand ils sont posés.
Ce cadrage s’inscrit naturellement dans un audit IA : on y recense les familles de tâches, on mesure, et on présente une décision par famille plutôt qu’un choix de modèle global.
Quelles erreurs éviter avec les modèles de raisonnement ?
Les erreurs les plus fréquentes avec les modèles de raisonnement consistent à les activer partout, à les utiliser pour compenser une mauvaise récupération et à les budgéter sur la moyenne. Toutes se corrigent par la mesure.
- Activer la réflexion globalement. Le surcoût touche toutes les requêtes alors que le gain se concentre sur quelques familles de tâches.
- Compenser une récupération défaillante. Un modèle qui réfléchit sur un contexte incomplet raisonne juste sur de mauvaises prémisses.
- Budgéter sur la moyenne. La dispersion des coûts rend la moyenne trompeuse ; seul le quantile élevé protège la facture.
- Oublier le plafond. Sans limite de jetons par requête, une question mal posée peut consommer une part disproportionnée du budget.
- Ignorer la latence. Un gain de justesse ne sert à rien dans une interface que l’utilisateur quitte avant la réponse.
Ces erreurs sont aussi celles qui bloquent le passage en production, au même titre que les cinq verrous du prototype.
Questions fréquentes
Un modèle de raisonnement améliore-t-il toutes les tâches ?
Non. Il apporte un gain net sur les tâches à plusieurs contraintes qui interagissent, et pratiquement rien sur les tâches documentaires où la réponse est déjà présente dans le contexte fourni. Le gain se mesure famille de tâches par famille de tâches.
Peut-on l’utiliser en conversation ?
Difficilement : la réflexion se paie en temps, avec des réponses qui peuvent prendre des dizaines de secondes. La configuration qui fonctionne réserve ces modèles aux traitements différés, où la latence ne coûte rien. L’interactif reste l’affaire d’un modèle rapide sur un contexte bien récupéré.
Comment budgéter un système qui réfléchit ?
En mesurant la dispersion plutôt que la moyenne, et en posant un plafond de jetons par requête. Une question difficile peut consommer beaucoup plus qu’une question simple de même longueur. Le budget se construit au quantile élevé.
Que faire quand les réponses sont mauvaises ?
Vérifier d’abord la récupération. Le plus souvent, l’information nécessaire n’était pas dans le contexte, et aucun supplément de raisonnement ne la fera apparaître. Ce contrôle se fait rapidement sur les cas en échec.
Pourquoi un modèle de raisonnement coûte-t-il plus cher ?
Parce qu’il produit des jetons de réflexion avant sa réponse, et que ces jetons sont facturés même lorsqu’ils ne sont pas affichés. Plus la question est difficile, plus la réflexion est longue. Le coût dépend donc de la difficulté, pas seulement de la longueur.
Faut-il remplacer son modèle actuel par un modèle de raisonnement ?
Non, il faut l’ajouter comme un palier supplémentaire. Les tâches simples restent sur un modèle rapide et peu coûteux, et seules les familles de tâches où la mesure montre un gain passent par la réflexion. Remplacer globalement multiplie la facture sans gain proportionné.
Sources
- Learning to Reason with LLMs, présentation d'o1 et gain de performance avec le temps de réflexion, OpenAI, 12 septembre 2024.
- Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters, Snell et al., Google DeepMind et UC Berkeley, août 2024.
- Guide des modèles de raisonnement, jetons de raisonnement facturés comme jetons de sortie, documentation API, OpenAI.