Qu’est-ce que la latence d’un système d’IA, et que change GPT-4o ?
La latence est le délai vécu par l’utilisateur avant une réponse exploitable, et l’annonce de GPT-4o invite à la mesurer comme une contrainte de conception. Ce n’est pas seulement un gain de performance : l’interaction bascule du registre de la requête à celui de la conversation.
Deux mesures sont à distinguer. Le temps jusqu’au premier jeton est le délai avant que le premier mot de la réponse apparaisse. Le temps total est le délai jusqu’à la fin de la réponse. Dans une interface écrite, le premier éclaire le début de l’attente ; le temps total compte pour lire ou utiliser la réponse complète.
Dans son annonce du 13 mai 2024, OpenAI rapporte des réponses audio à partir de 232 millisecondes, avec une moyenne de 320 millisecondes. Ce sont les mesures annoncées par l’éditeur pour le modèle, pas une garantie de délai pour une application avec réseau, récupération et contrôles.
À cette date, l’API propose les capacités texte et vision. Le nouveau mode vocal et l’accès API aux capacités audio et vidéo sont annoncés pour un déploiement progressif ultérieur. Les démonstrations ne prouvent donc pas que chaque entreprise peut déjà exploiter toute cette chaîne vocale.
Une conversation demande aussi gestion des interruptions, fin de tour de parole et reprise. Une réponse rapide ne suffit pas à rendre l’échange naturel si ces mécanismes sont mal conçus.
Quels seuils de latence viser pour un assistant d’IA ?
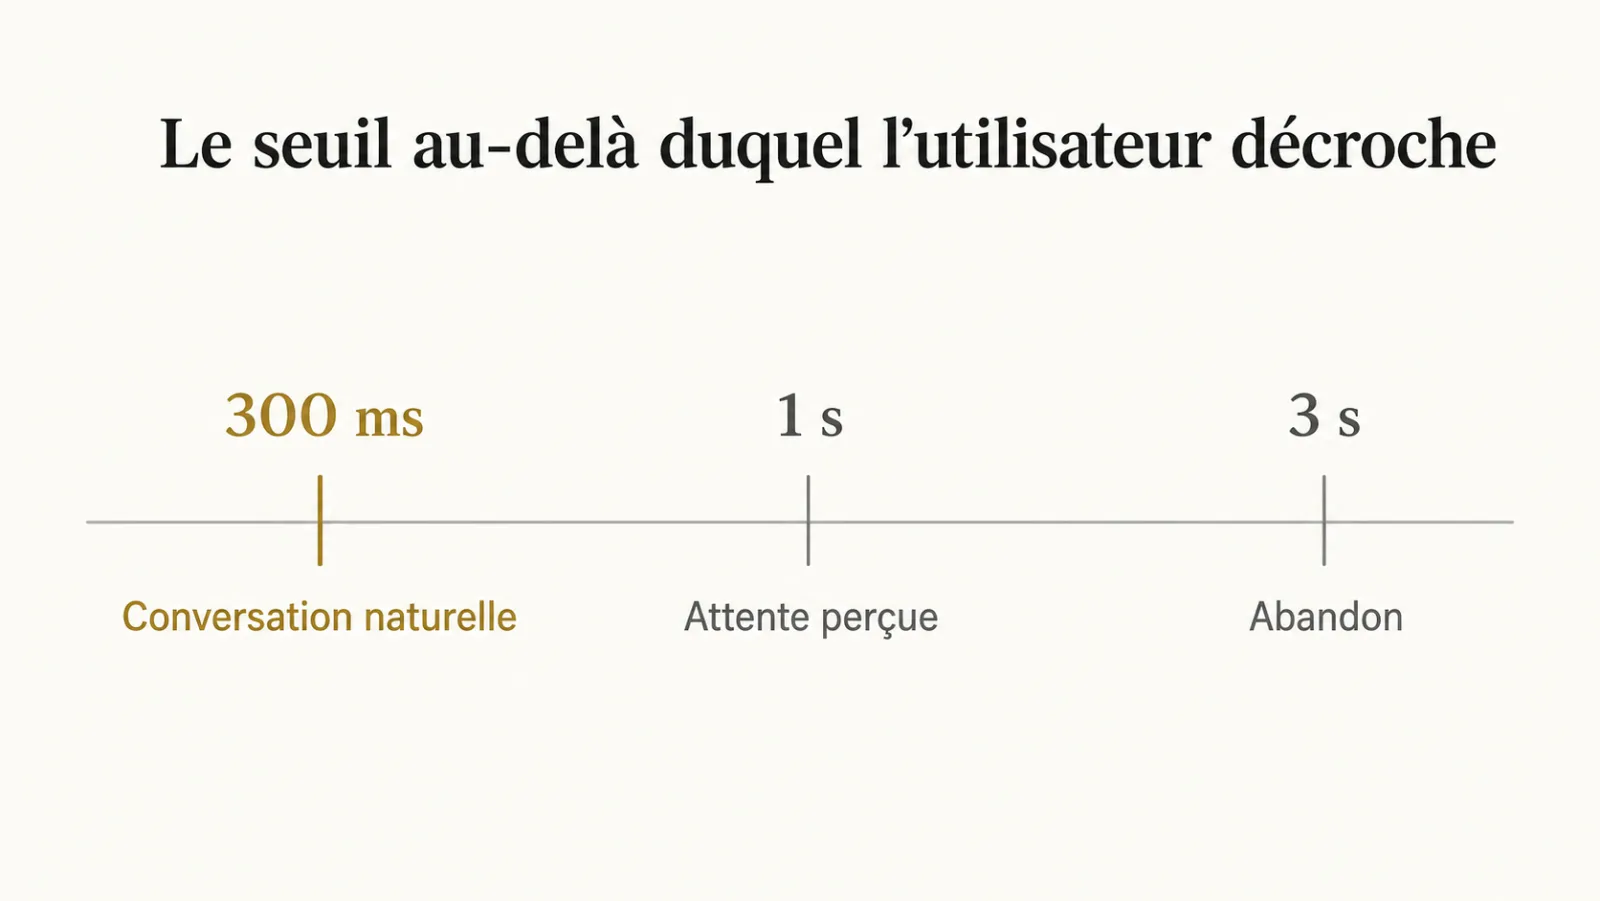
Les objectifs de latence doivent être fixés selon l’usage et vérifiés avec les utilisateurs, sans traiter une seconde ou trois secondes comme des seuils universels. Les repères de Jakob Nielsen publiés en 1993 décrivent les effets de l’attente sur l’interaction. Ils ne démontrent pas un abandon systématique des assistants après trois secondes.
Pour une interface écrite, la contrainte est plus souple parce que l’affichage progressif du texte occupe l’attention. L’utilisateur qui voit les premiers mots arriver attend volontiers la suite. C’est pourquoi le temps jusqu’au premier jeton compte davantage que le temps total.
Pour un usage vocal, l’affichage progressif n’existe pas : le silence est un silence. Le délai se mesure jusqu’au premier son utile, avec la transcription, la recherche et la synthèse si elles interviennent. Une architecture se juge sur ce délai complet.
| Usage | Objectif à définir | Mesure à suivre | Point de contrôle |
|---|---|---|---|
| Conversation vocale | Réponse compatible avec le tour de parole | Fin de parole au premier son utile | Réseau, interruptions et étapes séquentielles |
| Interface écrite | Début de réponse et achèvement acceptables | Premier contenu visible et temps total | Affichage, qualité et contrôles avant exposition |
| Traitement en arrière-plan | Échéance opérationnelle respectée | Durée totale et files d’attente | Reprises, erreurs et résultat disponible |
Le budget de latence doit couvrir toute la chaîne. Une interface peut annoncer le traitement en cours, mais cette information ne remplace pas un résultat utile ni une échéance respectée.
Quels maillons mesurer pour localiser l’attente dans un assistant documentaire ?
Il faut mesurer la recherche, le réseau, les appels, le contexte et les contrôles pour attribuer l’attente au bon maillon avant de modifier l’architecture.
- La récupération, si l’index est mal dimensionné ou si le filtrage des droits se fait après la recherche au lieu d’avant.
- Le nombre d’appels enchaînés. Des étapes séquentielles ajoutent leurs durées ; le délai ne triple que si les trois étapes ont la même durée et constituent toute la chaîne.
- La taille du contexte envoyé. Une entrée plus longue peut augmenter le délai, selon le modèle et l’infrastructure ; cet effet doit être mesuré. Voir une grande fenêtre reste une facture.
- Les garde-fous mal placés. Un contrôle de sécurité qui attend la réponse complète avant de la valider peut retarder l’affichage, mais reste nécessaire si le contenu ne doit pas être exposé avant validation.
Comment réduire la latence d’un système documentaire, étape par étape ?
Réduire la latence d’un système documentaire consiste à mesurer chaque maillon de la chaîne, puis à traiter dans l’ordre la récupération, les appels enchaînés, la taille du contexte et le placement des garde-fous. On ne corrige bien que ce qu’on a mesuré séparément.
- Découper la mesure. Chronométrer séparément la récupération, chaque appel au modèle, et les contrôles. Sans ce découpage, on optimise au hasard.
- Filtrer avant de chercher. Appliquer les droits d’accès dans la requête de recherche plutôt que sur les résultats, pour empêcher l’exposition de documents non autorisés, puis mesurer l’effet sur la recherche.
- Paralléliser ou supprimer les appels enchaînés. Ce qui peut être fait en même temps doit l’être ; ce qui n’apporte rien de mesurable doit disparaître.
- Réduire le contexte. Envoyer moins d’extraits, mieux choisis, plutôt que remplir la fenêtre. La récupération reste la seule architecture qui tienne précisément pour cette raison.
- Comparer un modèle plus petit sur les étapes simples. Une classification peut satisfaire les critères avec un modèle moins coûteux, comme le montre l’arbitrage ouvert par Mistral 7B.
- Choisir le mode d’affichage compatible avec la sécurité. Un contrôle nécessaire précède l’exposition du contenu ; prévoir un indicateur d’attente plutôt que supprimer ce contrôle.
Chaque modification doit être vérifiée sur le jeu de tests : un gain de vitesse qui dégrade la qualité n’en est pas un. C’est le rôle de l’évaluation continue.
Pourquoi la latence décide-t-elle de l’adoption d’un outil d’IA ?
La latence peut réduire l’adoption lorsqu’elle perturbe la tâche, mais son effet doit être mesuré avec la qualité, la disponibilité et la compréhension de l’interface. Un délai moyen ne suffit pas à expliquer un abandon.
L’utilisateur peut contourner un outil qui le ralentit, sans signaler une erreur. Je relie donc les mesures de délai aux tâches réellement accomplies, aux demandes répétées et aux retours des utilisateurs. Une baisse d’usage n’est pas, seule, une preuve de latence excessive.
Mesurez la distribution : médiane, délais longs, requêtes en erreur et temps jusqu’au résultat exploitable. Une moyenne peut cacher une famille de documents particulièrement lente. Séparez aussi les essais à froid, les requêtes ordinaires et les périodes de forte charge.
Le suivi doit préserver la confidentialité des traces. La méthode est approfondie dans l’observabilité des systèmes IA, conservée ici comme lecture complémentaire.
Quelle métrique de latence afficher sans masquer les autres délais ?
Le temps jusqu’au premier contenu utile et les délais longs éclairent l’attente, mais doivent être accompagnés du temps total, des erreurs et du taux de réussite.
Le 95e percentile donne un repère sur les requêtes lentes, avec un volume de mesures suffisant et une période explicite. Un premier jeton technique n’équivaut pas nécessairement au premier mot affiché ou au premier son entendu.
Comment arbitrer entre latence, qualité et coût ?
On arbitre entre latence, qualité et coût tâche par tâche : chaque étape du système reçoit le modèle le plus rapide et le moins cher qui atteint le niveau de qualité exigé sur le jeu de tests. Il n’existe pas de réglage unique valable pour tout le système.
Les trois critères tirent dans des directions différentes. Le modèle le plus capable est souvent le plus lent ; un contexte plus riche améliore parfois la réponse mais allonge le traitement ; un contrôle supplémentaire sécurise mais retarde.
La grille de décision qui fonctionne tient en trois questions. L’utilisateur attend-il cette étape, ou se déroule-t-elle en arrière-plan ? Une erreur à cette étape est-elle visible et grave ? L’étape a-t-elle une réponse courte et vérifiable ? Une étape attendue, peu risquée et structurée va au modèle le plus rapide. Une étape d’analyse, risquée, qui se déroule pendant que l’utilisateur lit déjà le début de la réponse, peut se permettre un modèle plus lent. C’est la logique de choisir le palier, pas le modèle.
Quels nouveaux usages la rapidité des modèles ouvre-t-elle ?
Une latence réduite peut faciliter l’assistance en situation, la conversation vocale et les corrections interactives, sous réserve de disponibilité des capacités et de fiabilité suffisante. Ce sont des usages différents, pas des versions accélérées des précédents.
L’assistance en situation, un technicien devant une machine, un agent au téléphone avec un client, suppose une réponse dans le rythme de l’action. Le délai acceptable dépend de ce que la personne fait pendant l’attente.
Ces usages ont une caractéristique commune : l’utilisateur peut disposer de peu de temps pour vérifier, selon la situation. La rapidité augmente donc l’exigence de fiabilité au lieu de la relâcher, et impose de concevoir explicitement ce que le système fait quand il n’est pas sûr.
La réponse tient en une règle : dans un usage rapide, le refus doit être aussi rapide que la réponse. Le refus doit être compréhensible et compatible avec le rythme de la tâche, sans masquer un traitement nécessaire.
Cette exigence rejoint directement la question du périmètre : une interaction rapide peut réduire le temps disponible pour vérifier, et plus il importe d’avoir décidé à l’avance ce que le système n’a pas le droit de faire seul. Le cadre est posé dans le périmètre avant l’autonomie.
Quelles erreurs fréquentes dégradent la latence perçue ?
Les erreurs qui dégradent le plus la latence perçue sont de mesurer la moyenne, d’enchaîner les appels par habitude, de remplir la fenêtre de contexte et de bloquer l’affichage progressif. Les essais doivent inclure charges, documents difficiles et erreurs.
- Piloter à la moyenne. La moyenne ne montre pas les familles de requêtes lentes.
- Enchaîner les appels par confort de conception. Chaque appel ajoute son délai complet à l’attente de l’utilisateur.
- Envoyer tout le contexte disponible. Plus long à traiter, plus cher, et rarement meilleur.
- Oublier le retour d’état. Si une validation impose d’attendre, expliquer le traitement en cours sans exposer de contenu non contrôlé.
- Concevoir un usage vocal comme un usage écrit. Le silence ne pardonne pas ce que l’affichage progressif masquait.
Quand l’usage d’un outil baisse sans erreur visible, un audit IA commence généralement par mesurer la latence au quantile élevé, avant même d’examiner la qualité des réponses.
Comment fixer et vérifier les objectifs de latence d’un assistant IA ?
Quelle latence viser pour un assistant documentaire ?
L’objectif dépend du rythme de la tâche et doit être testé avec les utilisateurs ; distinguez premier contenu utile, temps total et délais longs plutôt qu’un seuil universel.
Faut-il mesurer la latence moyenne d’un système d’IA ?
La moyenne complète la distribution, mais ne décrit pas les requêtes lentes ; médiane, percentiles et erreurs doivent être reliés aux documents, à la charge et aux tâches.
Où se perd la latence en pratique ?
Dans la récupération mal dimensionnée, les appels enchaînés, la taille du contexte envoyé et les garde-fous qui attendent la réponse complète avant de la valider. Mesurer chaque maillon séparément permet de savoir lequel corriger en premier.
La rapidité réduit-elle l’exigence de fiabilité ?
Un usage rapide peut limiter la vérification humaine, ce qui renforce le besoin de limites explicites et de contrôles ; la vitesse ne justifie pas leur suppression.
Qu’est-ce que le temps jusqu’au premier jeton ?
C’est le délai entre l’envoi de la question et l’apparition du premier mot de la réponse ; Dans une interface écrite à affichage progressif, c’est la mesure qui correspond le mieux à l’attente ressentie par l’utilisateur.
Un système vocal peut-il reprendre l’architecture d’un assistant écrit ?
La reprise d’une architecture écrite demande de mesurer toute la chaîne vocale, interruptions et fin de parole comprises ; la disponibilité des capacités doit être distinguée des démonstrations.