Qu’est-ce que GPT-4 Turbo change à la fenêtre de contexte et aux prix ?
GPT-4 Turbo, annoncé par OpenAI le 6 novembre 2023 lors de son DevDay, porte le contexte à 128 000 jetons tout en divisant par trois le prix des jetons d’entrée et par deux celui des jetons de sortie par rapport à GPT-4. Selon OpenAI, la fenêtre équivaut à plus de trois cents pages de texte dans une seule requête.
Le modèle est proposé en préversion, avec des connaissances qui s’étendent jusqu’en avril 2023. La fenêtre de contexte, c’est la quantité de texte que le modèle peut recevoir en une fois : la consigne, les documents joints, l’historique de la conversation et la question.
| Modèle | Fenêtre | Prix d’entrée (pour 1 000 jetons) | Prix de sortie (pour 1 000 jetons) | Entrée théorique à capacité maximale |
|---|---|---|---|---|
| GPT-4 | 8 192 jetons | 0,03 $ | 0,06 $ | environ 0,25 $ |
| GPT-4 32k | 32 768 jetons | 0,06 $ | 0,12 $ | environ 1,97 $ |
| GPT-4 Turbo | 128 000 jetons | 0,01 $ | 0,03 $ | environ 1,28 $ |
La dernière colonne illustre un calcul d’entrée, hors sortie. La fenêtre doit également garder de la place pour la réponse ; une requête réelle ne remplit donc pas nécessairement toute cette capacité. L’espace inutilisé n’est pas facturé comme des jetons envoyés.
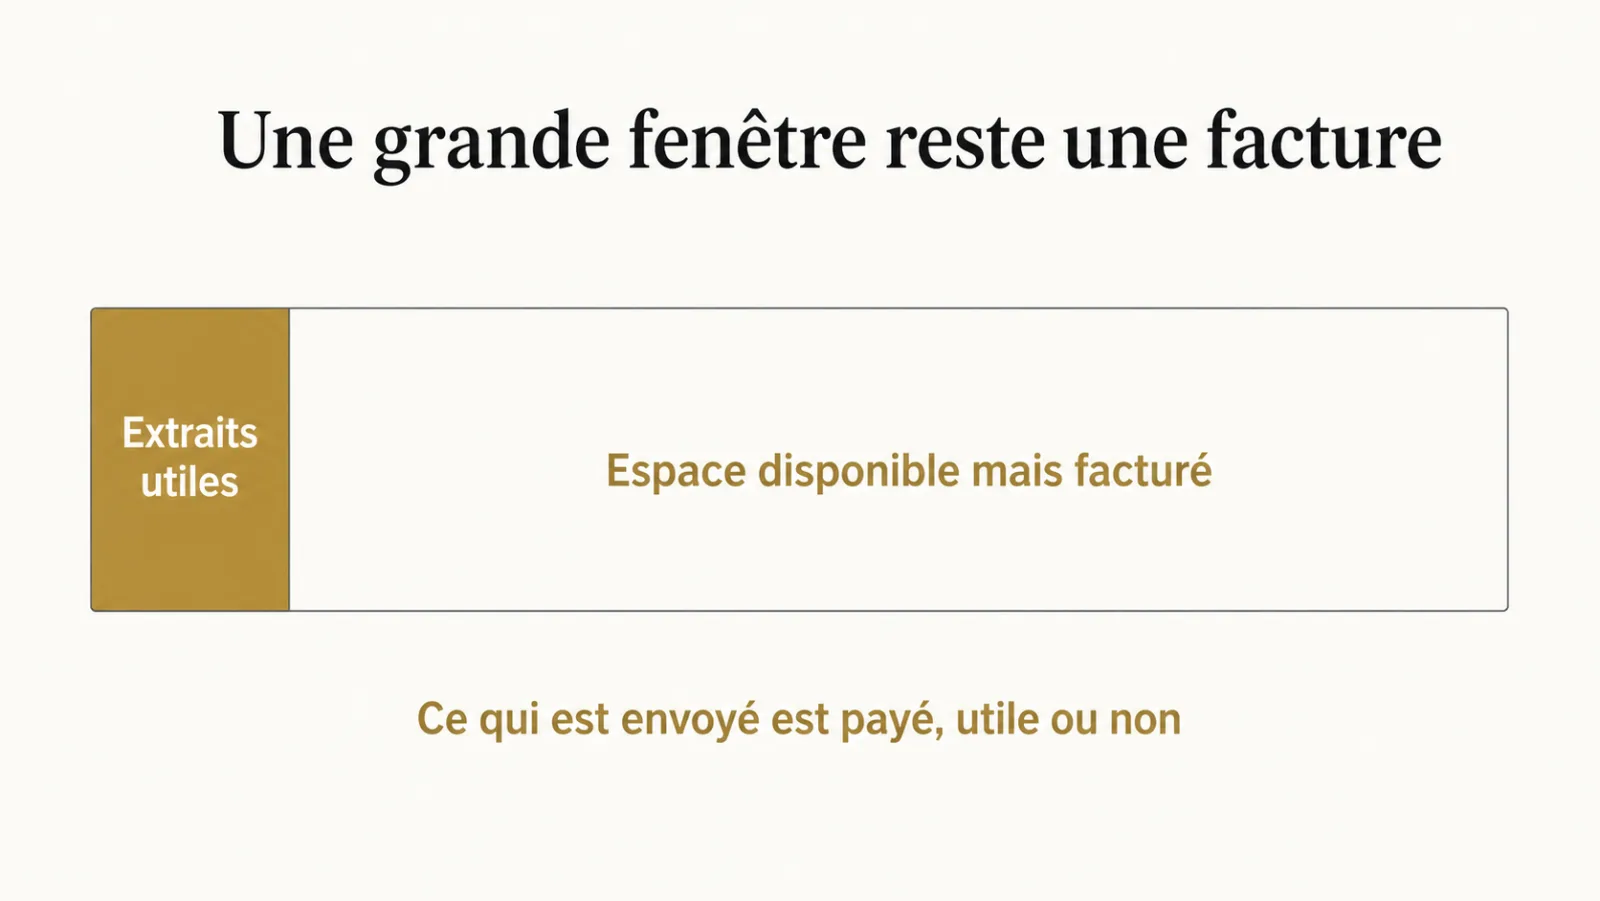
Cette comparaison résume le paradoxe. Le prix par jeton baisse, mais une requête qui remplit la nouvelle fenêtre coûte environ cinq fois plus qu’une requête qui remplissait l’ancienne fenêtre de huit mille jetons. La capacité disponible n’est pas un budget à consommer.
Pourquoi une facture peut-elle augmenter quand le prix par jeton baisse ?
Une facture augmente malgré la baisse du prix par jeton dès que la consommation par requête croît plus vite que le prix unitaire ne baisse, si l’équipe choisit d’envoyer davantage de contenu. Le paradoxe s’explique en une phrase : la capacité disponible est traitée comme un budget à consommer.
Quand la fenêtre était de huit mille jetons, la contrainte imposait la sobriété. Les longs dossiers exigeaient de sélectionner ou de traiter les passages séparément, ce qui a fait naître les chaînes de récupération décrites dans la fenêtre de 8 000 jetons de GPT-4. À cent vingt-huit mille, la sélection devient optionnelle, et l’option la plus simple consiste à tout envoyer.
Prenons un exemple chiffré, purement illustratif. Une équipe envoie en moyenne six mille jetons par requête à GPT-4, soit environ 0,18 dollar d’entrée par appel. Elle passe à GPT-4 Turbo et, puisque la fenêtre le permet, joint désormais des documents entiers : soixante mille jetons par requête. Le prix unitaire a été divisé par trois, la consommation multipliée par dix, et la facture d’entrée passe à 0,60 dollar par appel, plus du triple.
Rien dans ce scénario n’est une erreur technique. C’est une décision de conception qui n’a pas été prise, et qui se prend donc par défaut.
Pourquoi ajouter du contexte peut-il dégrader une réponse ?
Au-delà d’un certain volume de contexte, ajouter des documents peut faire baisser la précision des réponses au lieu de l’augmenter, parce que l’information utile se dilue parmi des passages qui ne le sont pas. C’est le point contre-intuitif, et c’est celui qui convainc les équipes quand l’argument budgétaire ne suffit pas.
Le mécanisme est documenté : les travaux publiés cet été par Liu et ses coauteurs sous le titre « Lost in the Middle » montrent que, sur les modèles étudiés, l’information placée au milieu d’un long contexte est moins bien exploitée que celle placée au début ou à la fin. Vingt extraits dont deux sont pertinents peuvent produire une réponse moins bonne que les deux extraits seuls, parce que le modèle a dix-huit occasions de se tromper de source.
La conséquence pratique va à l’encontre du réflexe naturel. Face à une mauvaise réponse, la tentation est d’envoyer plus de contexte. Vérifiez d’abord si le passage utile manque ou s’il se trouve noyé dans des extraits inutiles. Selon ce diagnostic, ajoutez une référence manquante ou réduisez le bruit. C’est tout l’objet d’une architecture de récupération, qui ne perd pas sa raison d’être parce que la fenêtre s’agrandit.
Quels réglages permettent de suivre et de limiter la facture ?
Pour suivre et limiter la facture, fixez des budgets, journalisez les consommations et testez le routage, en conservant la qualité comme condition de chaque économie.
- Fixer un plafond de jetons par requête dans le code, pas dans une consigne. Une limite qui n’est pas appliquée par le système n’est pas une limite.
- Mesurer le coût par appel et par fonctionnalité, au même endroit pour tous les fournisseurs, idéalement dans une couche d’abstraction unique. Sans cette mesure, aucune optimisation n’est instruite.
- Router les tâches simples vers un petit modèle. Vérifiez que l’économie couvre aussi les erreurs et les reprises, comme discuté dans Mistral 7B et l’arbitrage par le routage.
- Poser une alerte sur la dérive, pas seulement sur le total. Une hausse doit être expliquée par les demandes, le modèle ou les documents ; elle peut aussi correspondre à un usage devenu plus complexe.
Comment maîtriser le coût d’une conversation qui grossit ?
Renvoyer tout l’historique à chaque tour peut produire une croissance quadratique du coût d’entrée cumulé, tant que la longueur moyenne des tours reste comparable et que rien n’est tronqué. Cette propriété concerne un scénario précis, pas toutes les conversations.
Si chaque échange ajoute une quantité similaire de texte, les entrées successives suivent approximativement la suite 1, 2, 3, puis davantage d’unités. Leur somme croît plus vite que le nombre de tours. Dès que l’application résume ou borne l’historique, ce calcul change. Les sorties et les traitements supplémentaires doivent être comptés séparément.
La grande fenêtre permet de repousser la troncature, mais ne rend pas les anciens messages gratuits. L’API Assistants annoncée au DevDay propose une gestion de l’historique ; il faut encore observer les usages et leur coût au lieu de supposer que chaque tour renvoie automatiquement toute la conversation.
Définissez une règle : conserver les éléments nécessaires, résumer les décisions anciennes et ouvrir une nouvelle session lorsque le sujet change. Vérifiez les pertes d’information avec des tests. L’observabilité des systèmes IA est conservée comme lecture complémentaire sur le suivi de ce parcours.
Comment trouver les appels qui expliquent la dépense ?
Les appels qui expliquent la dépense se repèrent en rapprochant leurs compteurs, leur tarif et leur fonctionnalité, puis en examinant volume, reprises et résultat utile. Triez les coûts cumulés par parcours et les coûts unitaires par appel. Quelques appels chers et de nombreux appels modestes demandent des corrections différentes.
Comment décider de ce qu’on envoie au modèle ?
Décider de ce qu’on envoie au modèle revient à fixer un budget de contexte par fonctionnalité, puis à le remplir par ordre de pertinence au lieu de remplir la fenêtre par ordre de disponibilité. La méthode tient en cinq étapes.
- Fixer un budget de jetons par fonctionnalité, à partir de ce que la tâche exige réellement et non de ce que la fenêtre permet.
- Classer les contenus candidats : consigne, extraits de documents, historique, exemples. Chacun reçoit une part du budget.
- Sélectionner les extraits par pertinence, avec un découpage des documents qui préserve le sens des passages.
- Mesurer la qualité à budget croissant sur un jeu de tests : si l’ajout d’extraits n’améliore pas les cas testés, cherchez ce qu’il apporte avant de le conserver.
- Réserver la fenêtre pleine aux tâches qui l’exigent, comme l’analyse d’un document entier ou la comparaison de passages éloignés.
Ce cadrage est ce qui manque le plus souvent aux prototypes qui ne passent pas en production, comme le montre l’anatomie d’un POC qui ne passe jamais. La grande fenêtre garde de vrais usages, déjà ouverts par les cent mille jetons de Claude 2 ; elle ne doit simplement pas devenir le réglage par défaut.
Que change vraiment la baisse des prix de GPT-4 Turbo ?
La baisse du tarif de GPT-4 Turbo peut améliorer l’économie d’un usage à fort volume, mais sa viabilité dépend aussi de la qualité, de la consommation et du coût humain. C’est le bon usage de cette annonce.
Des traitements par lot sur des dizaines de milliers de documents, une classification systématique du courrier entrant, un enrichissement de base documentaire : la baisse réduit leur poste d’inférence à consommation comparable, sans démontrer à elle seule leur rentabilité.
Mais ce basculement suppose que le coût par unité traitée soit connu. Une équipe qui ne mesure pas ne saura pas dire si le traitement par lot est rentable, et prendra la décision au jugé. La baisse annoncée ce jour n’autorise pas à prédire les tarifs futurs. Le prix de l’inférence s’effondre reste une lecture complémentaire, sans servir de preuve à ce constat de novembre 2023.
Un dernier point mérite d’être posé : la baisse ne s’applique pas uniformément. Le prix d’entrée est divisé par trois, celui de sortie par deux. Un système qui envoie beaucoup et produit peu, un classifieur ou un extracteur, profite pleinement de la première baisse ; un système qui produit de longs textes profite surtout de la seconde. Recalculez sur votre profil d’usage, en séparant l’entrée, la sortie et les reprises, pour éclairer la décision. Ce calcul fait d’ailleurs partie d’un audit de système d’IA sérieux.
Quelles questions vérifier avant de passer à GPT-4 Turbo ?
Faut-il utiliser toute la fenêtre disponible ?
Non. La fenêtre est une capacité ; les jetons effectivement envoyés et produits déterminent la facture. Gardez de la place pour la réponse et testez les extraits nécessaires. L’espace vide n’est pas une consommation.
Pourquoi une facture augmente-t-elle quand les prix baissent ?
Parce que la consommation par requête peut augmenter plus vite que le prix unitaire ne baisse. Une requête dix fois plus longue, envoyée parce que la fenêtre le permet, annule largement une division par trois du tarif d’entrée. La facture suit la consommation, pas le prix catalogue.
Quels sont les prix de GPT-4 Turbo ?
À l’annonce du 6 novembre 2023, OpenAI fixe le prix à 0,01 dollar pour mille jetons d’entrée et 0,03 dollar pour mille jetons de sortie. C’est trois fois moins cher que GPT-4 en entrée et deux fois moins cher en sortie. Le modèle est proposé en préversion.
Comment maîtriser le coût d’une conversation longue ?
Bornez ou résumez l’historique, puis testez la conservation des décisions importantes. La croissance quadratique concerne le renvoi intégral de tours de longueur comparable, avant troncature ; elle ne décrit pas automatiquement tous les parcours.
Quelle mesure mettre en place en priorité ?
Journalisez les compteurs, le tarif daté et le coût par fonctionnalité, avec les reprises et le résultat obtenu. Comparez coûts unitaires et volumes cumulés avant de conclure quel appel mérite une optimisation.
Une fenêtre de 128 000 jetons rend-elle la récupération de documents inutile ?
Non. Une grande fenêtre peut recevoir un dossier complet, mais une sélection pertinente peut réduire l’entrée et faciliter la vérification. Testez les deux approches : ni le coût final ni la précision ne sont garantis par la capacité.