Qu’est-ce que Mistral 7B démontre sur les petits modèles de langage ?
Mistral 7B obtient des résultats comparables à des modèles bien plus gros sur les tâches structurées, et il tient sur une seule carte graphique grand public. C’est cette combinaison, et non le score brut, qui a un effet immédiat sur les architectures d’entreprise.
Un petit modèle de langage désigne ici un modèle de quelques milliards de paramètres, les coefficients appris pendant l’entraînement, contre plusieurs dizaines ou centaines de milliards pour les modèles les plus puissants. Moins de paramètres signifie moins de mémoire, moins de calcul par réponse, donc un coût et une latence plus faibles. La question est de savoir sur quelles tâches cette économie ne se paie pas en qualité.
Jusqu’ici la logique dominante était simple : le plus gros modèle disponible pour tout. Elle était défendable tant que l’écart de qualité justifiait l’écart de prix. Elle cesse de l’être quand un modèle beaucoup moins cher fait aussi bien sur la majorité des appels.
Les tâches concernées sont celles qui composent l’essentiel du volume réel : classer une demande, extraire trois champs d’un document, reformuler un texte, détecter une langue, décider si une question relève du périmètre. Aucune ne demande un raisonnement élaboré.
Qu’est-ce que le routage de modèles, et pourquoi bat-il l’optimisation de prompt ?
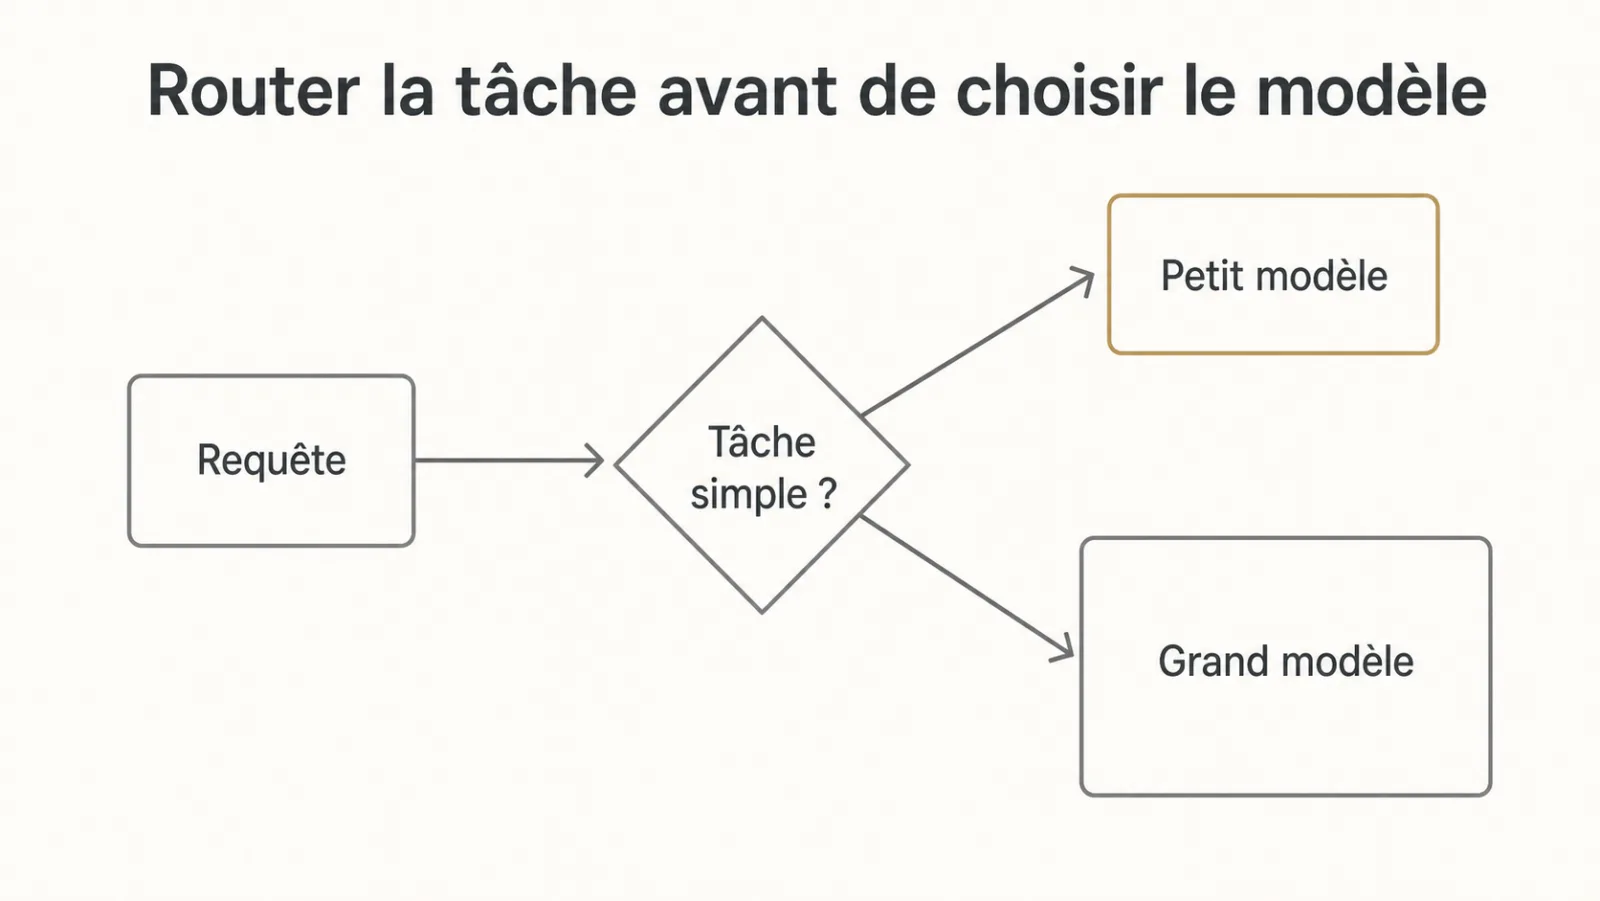
Le routage de modèles consiste à envoyer chaque type de tâche au plus petit modèle qui la traite correctement, et il réduit la facture bien plus fortement que l’optimisation de prompt. C’est le levier le plus rentable d’un système en production, et le moins utilisé.
La mise en œuvre est plus simple qu’attendu. On ne cherche pas à faire décider le modèle : on classe les tâches à l’avance, par type d’appel, dans le code. Une extraction de champs part toujours sur le petit modèle. Une analyse de cohérence contractuelle part toujours sur le grand.
Le cas intermédiaire, laisser un modèle décider de l’escalade, existe, mais il ajoute un appel et une source d’erreur. Je ne le recommande qu’après avoir épuisé le routage statique, qui capte déjà l’essentiel du gain. La couche d’abstraction rend ce routage trivial à mettre en place, ce qui est un argument de plus en sa faveur ; son rôle est décrit dans la couche qui rend le modèle remplaçable.
Quelles tâches confier à un petit modèle, et lesquelles garder pour un grand ?
Un petit modèle convient aux tâches courtes, structurées et vérifiables, tandis qu’un grand modèle reste nécessaire pour les synthèses longues et les raisonnements sur plusieurs documents. Le tableau donne une première répartition, à confirmer sur un jeu de tests propre à chaque organisation.
| Type de tâche | Exemple générique | Modèle de départ | Vérification |
|---|---|---|---|
| Classification | Orienter un courriel vers le bon service | Petit | Comparaison avec la catégorie attendue |
| Extraction de champs | Relever montant, date et fournisseur sur une facture | Petit | Contrôle champ par champ |
| Détection de périmètre | Décider si une question relève du système | Petit | Taux de faux positifs et de faux négatifs |
| Reformulation courte | Réécrire une réponse type dans un ton donné | Petit | Relecture par échantillon |
| Synthèse d’un dossier | Résumer vingt pages de pièces hétérogènes | Grand | Relecture experte |
| Analyse de cohérence | Repérer des contradictions entre deux contrats | Grand | Relecture experte, cas tests |
La colonne « modèle de départ » n’est qu’une hypothèse. La décision se prend sur les mesures, pas sur la catégorie.
Comment décider quelle tâche va vers quel modèle ?
- Constituer un jeu de cas par type de tâche, une trentaine suffit, avec la réponse attendue. Voir l’évaluation continue.
- Faire tourner les deux modèles sur ce jeu et comparer, non pas la préférence subjective, mais le taux d’erreur mesuré.
- Fixer un seuil acceptable par tâche. Une classification interne tolère quelques erreurs ; une extraction qui alimente une facture n’en tolère aucune.
- Rejouer la comparaison à chaque nouvelle version. Un petit modèle qui échouait il y a six mois peut passer le seuil aujourd’hui, et le gain se reprend sans effort.
L’ordre des opérations qui fonctionne
Faire marcher le système avec un grand modèle, mesurer les volumes par type de tâche pendant un mois, puis basculer sur le petit modèle les tâches qui passent le seuil. Optimiser avant de mesurer conduit systématiquement à optimiser le mauvais appel.
Pourquoi garder un seul grand modèle par confort coûte-t-il cher ?
Beaucoup d’équipes gardent un seul grand modèle pour ne pas gérer deux configurations, et paient cette simplicité très cher dès que le volume d’appels augmente. L’argument est recevable au démarrage, quand le volume est faible et que le temps d’ingénierie vaut plus que la facture.
Il cesse de l’être dès que le système traite des milliers d’appels par jour. À ce stade, la différence entre un routage et un modèle unique devient sensible sur la facture mensuelle, pour un effort d’ingénierie limité.
Le symptôme à surveiller est simple : si personne dans l’équipe ne sait dire combien coûte une fonctionnalité par mois, le routage n’a pas été instruit. La mesure du coût par appel, posée dans la couche d’abstraction, est le préalable à toute optimisation. Elle est développée dans le coût réel d’un système IA en production.
Que change un modèle de sept milliards de paramètres pour l’hébergement interne ?
Un modèle de sept milliards de paramètres tient sur du matériel accessible, ce qui rend l’auto-hébergement envisageable pour une équipe ordinaire. C’est la seconde conséquence, moins commentée et tout aussi structurante.
Héberger un grand modèle demande plusieurs cartes coûteuses et une compétence d’exploitation rare. Héberger un modèle de cette taille demande une machine, ce qui déplace la décision du comité d’investissement vers l’équipe technique.
La licence compte autant que la taille. Mistral 7B est publié sous licence Apache 2.0, qui autorise l’usage commercial sans les restrictions qu’on trouve dans d’autres licences de modèles ouverts ; la vérification reste néanmoins à faire pour chaque modèle, comme le rappelle la licence compte autant que le modèle.
Cela ouvre un scénario particulier, utile dans les secteurs contraints : traiter en interne tout ce qui touche à des données sensibles, et n’envoyer à une API externe que ce qui a été préalablement anonymisé ou qui ne relève pas du périmètre protégé. Le cadre de cette décision est posé dans confidentialité : ce qu’on a le droit de mettre dans un prompt.
Quelles erreurs éviter quand on adopte un petit modèle ?
Les erreurs les plus fréquentes avec un petit modèle consistent à le juger sur un classement public, à le tester sur des cas faciles et à oublier le coût d’exploitation de l’auto-hébergement. Chacune fausse l’arbitrage dans un sens différent.
- Se fier au classement public. Un score agrégé ne dit rien de votre tâche ; seul votre jeu de tests le dit.
- Tester sur les exemples de la démonstration. Les cas difficiles, documents mal numérisés, demandes ambiguës, sont ceux où l’écart entre modèles apparaît.
- Basculer toutes les tâches d’un coup. On bascule tâche par tâche, en gardant la possibilité de revenir au grand modèle.
- Sous-estimer l’exploitation. Héberger soi-même implique supervision, mises à jour et astreinte ; ce coût s’ajoute au matériel.
- Confondre prototype et production. Un petit modèle qui brille sur dix exemples peut échouer sur le volume réel, scénario détaillé dans l’anatomie d’un POC qui ne passe jamais.
Faire instruire cet arbitrage par un regard extérieur, dans le cadre d’un audit IA, permet de mesurer avant de choisir.
Questions fréquentes
Un petit modèle suffit-il pour un système documentaire ?
Pour la récupération et l’extraction, oui, dans la plupart des cas. Pour la synthèse d’un dossier complexe ou l’analyse contractuelle, non. Le routage par type de tâche permet d’utiliser chacun là où il est bon.
Comment mesurer si un petit modèle est assez bon ?
Sur un jeu de trente cas réels par type de tâche, avec la réponse attendue, en comparant le taux d’erreur au seuil acceptable pour cette tâche. La comparaison subjective ne suffit pas et donne des décisions instables.
Le routage complique-t-il beaucoup le système ?
Non, s’il est statique : chaque type d’appel part vers un modèle décidé à l’avance dans le code. C’est le routage dynamique, où un modèle décide de l’escalade, qui ajoute de la complexité et une source d’erreur.
Faut-il refaire le choix quand un nouveau modèle sort ?
Oui, et c’est peu coûteux si le jeu de tests existe. Un petit modèle qui échouait il y a six mois peut passer le seuil aujourd’hui, et le gain se reprend en rejouant simplement la comparaison.
Peut-on utiliser Mistral 7B dans un produit commercial ?
Sa licence Apache 2.0 l’autorise, ce qui le distingue de modèles ouverts publiés sous des licences plus restrictives. Il reste à vérifier les conditions propres à chaque version et à documenter ce choix pour les services juridiques et achats.
Faut-il héberger soi-même un petit modèle ?
C’est pertinent quand les données ne doivent pas quitter l’entreprise ou que le volume d’appels est élevé et stable. Sinon, une API externe évite les coûts d’exploitation. Le choix dépend de la sensibilité des données et de la capacité de l’équipe à exploiter un service en continu.