Qu’est-ce que le contexte envoyé à un modèle, et pourquoi une grande partie ne sert-elle à rien ?
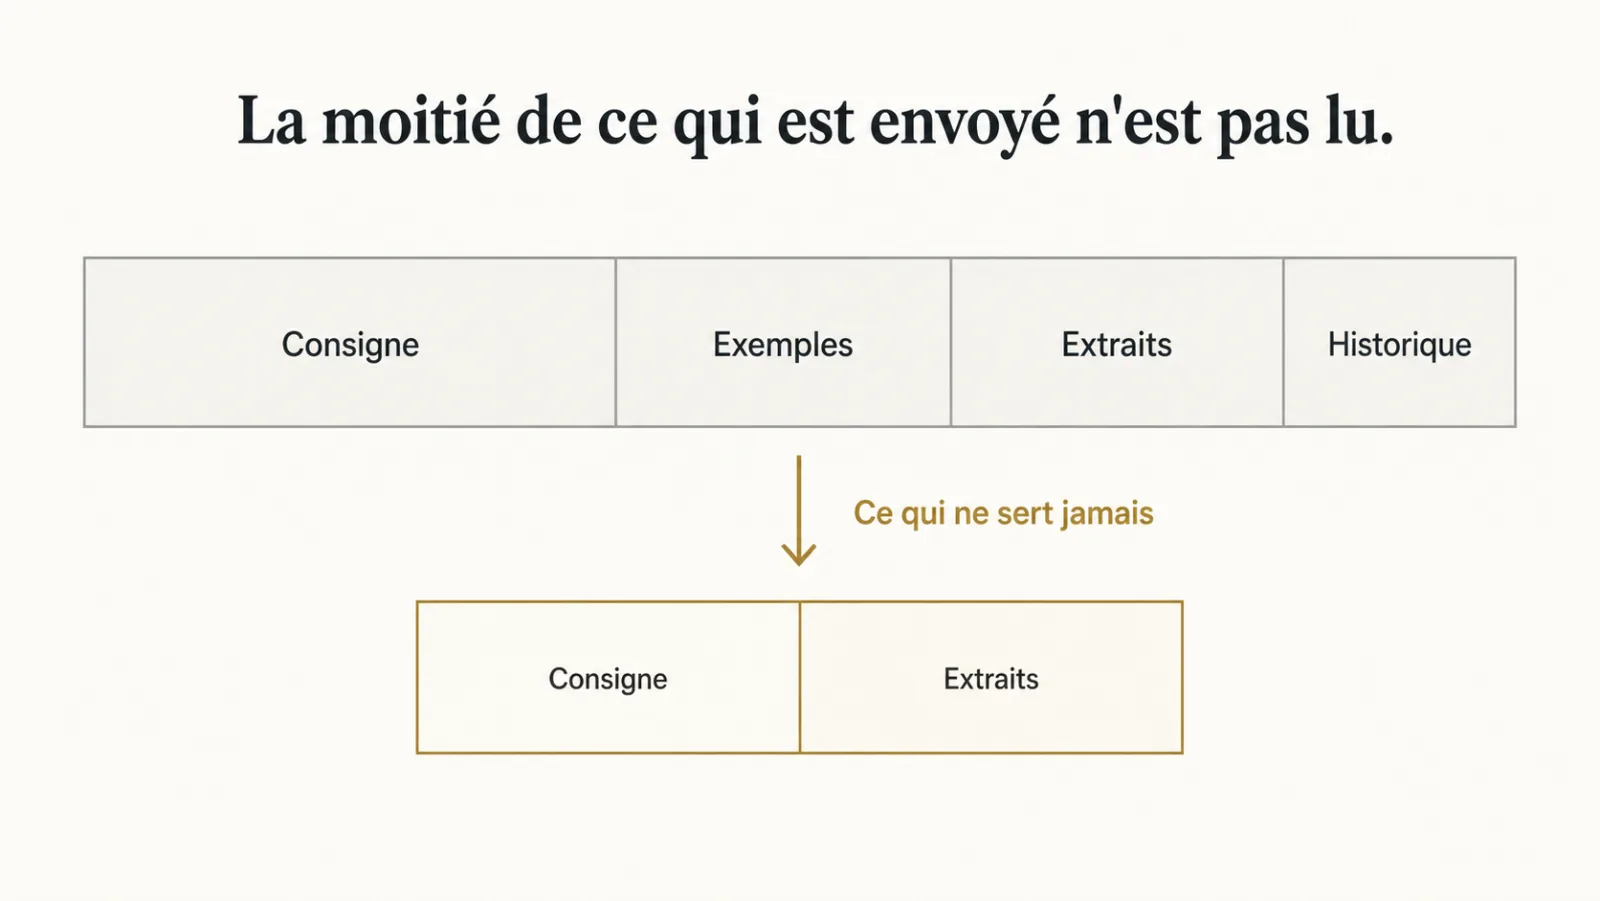
Le contexte envoyé à un modèle rassemble consignes, exemples, passages et historique, dont l’utilité doit être vérifiée par des retraits contrôlés avant de fixer un objectif de réduction. Diviser le volume par deux est une hypothèse d’optimisation, pas un résultat garanti.
Le contexte est facturé à chaque appel, en jetons d’entrée. Il se compose en général de quatre blocs : la consigne système, des exemples, les extraits récupérés, et l’historique de conversation. Chacun a été ajouté pour une bonne raison, et aucun n’a été revu depuis.
Les exemples sont le cas le plus net. Ajoutés au démarrage pour orienter le modèle, ils restent en place sans que leur utilité ait été revalidée après un changement de modèle. Ils coûtent à chaque appel, indéfiniment.
| Bloc | Pourquoi il a été ajouté | Pourquoi il grossit | Test de retrait |
|---|---|---|---|
| Consigne système | Cadrer le ton, le périmètre et le refus | Chaque incident ajoute une règle | La raccourcir et rejouer les tests |
| Exemples | Orienter un modèle plus ancien | Personne ne les retire après une migration | Les supprimer tous et mesurer |
| Extraits récupérés | Fournir les sources de la réponse | Le nombre d’extraits est monté « par sécurité » | Passer de dix à cinq et mesurer |
| Historique | Garder le fil de la conversation | Il s’allonge à chaque tour | Tronquer à cinq tours et mesurer |
Ces blocs peuvent grossir par décision ou par accumulation. Leur suivi permet de distinguer un besoin nouveau d’un ajout devenu inutile. C’est l’une des composantes les plus sous-estimées de ce que coûte réellement un système d’IA en production.
Comment identifier le contexte inutile en une journée ?
Retirer un bloc puis comparer les résultats sur des tests représentatifs permet d’évaluer son utilité dans ce périmètre, sans prouver qu’il est inutile pour toutes les requêtes. Elle est mécanique.
Je propose une première campagne sur quatre blocs, avec un ordre de retrait explicite :
- Relever la situation de départ : nombre moyen de jetons envoyés par requête et taux d’erreur sur le jeu de tests.
- Retirer les exemples, rejouer les tests, mesurer.
- Réduire le nombre d’extraits de dix à cinq, rejouer, mesurer.
- Tronquer l’historique à cinq tours, rejouer, mesurer.
- Raccourcir la consigne en supprimant les règles redondantes, rejouer, mesurer.
- Consigner chaque résultat, retenu ou rejeté, avec sa date.
À chaque étape, deux résultats possibles. Aucune régression détectée : le retrait peut être essayé sur un trafic limité, avec surveillance et retour arrière. Le taux d’erreur monte : on remet, et on sait désormais que ce bloc sert.
Cette démarche suppose évidemment un jeu de tests. Sans lui, chaque retrait devient un pari, et la prudence conduit à ne rien retirer, ce qui est exactement ce que je constate sur les systèmes sans mesure. Si ce jeu n’existe pas encore, il se construit vite, selon la méthode de construire un jeu de tests en une journée.
Quels blocs du contexte faut-il tester séparément ?
Les exemples, les passages récupérés, l’historique et certaines métadonnées doivent être testés séparément, afin de distinguer leur contribution à la réponse et leurs fonctions de contrôle ou de traçabilité.
- Les exemples dont l’utilité n’est plus démontrée, à retirer séparément et à tester sur les cas qu’ils étaient censés couvrir.
- Le nombre d’extraits récupérés, à adapter au rappel documentaire observé ; cinq et vingt sont ici des configurations d’essai, pas des seuils universels. Voir le RAG, la seule architecture qui tienne.
- L’historique de conversation, dont le coût croît de façon quadratique s’il n’est pas tronqué ou résumé.
- Les métadonnées non nécessaires à la réponse, après vérification : dates, identifiants et statut peuvent être indispensables à la provenance ou aux permissions.
Pourquoi réduire le contexte améliore-t-il souvent la qualité des réponses ?
Réduire des passages non pertinents peut améliorer la réponse, mais la qualité dépend de la sélection, de la position des informations et de leur disponibilité dans les cas testés. La recherche sur les contextes longs fournit un motif de test, pas une garantie.
Un modèle qui reçoit vingt extraits dont deux sont pertinents dispose de dix-huit occasions de se tromper de source. En réduisant à cinq extraits mieux choisis, on ne perd pas d’information utile et on retire du bruit.
S’y ajoute l’effet de position : l’information placée au milieu d’un long contexte est moins bien exploitée que celle placée aux extrémités. Le protocole doit donc faire varier longueur et position, puis mesurer les résultats du modèle choisi. C’est aussi pourquoi la taille maximale de la fenêtre n’est pas un objectif, comme l’explique quand la fenêtre de contexte cesse d’être un argument.
La conséquence pratique va contre le réflexe naturel. Face à une réponse insatisfaisante, la tentation est d’envoyer davantage. Je vérifie d’abord si la recherche retrouve le bon passage, puis si le contexte le transmet de manière exploitable. C’est le raisonnement de une grande fenêtre reste une facture.
Mieux sélectionner commence en amont de la requête : un découpage des documents qui produit des extraits autonomes permet d’en envoyer moins sans perdre le sens. Le sujet est traité dans découper un document, le choix qui décide de tout.
Dans quel ordre appliquer les optimisations de coût d’un système d’IA ?
Je recommande de tester la réduction du contexte avant le cache et le routage lorsque les entrées dominent la facture, puis de vérifier chaque gain sur le service complet. L’ordre dépend des coûts mesurés.
Diviser le contexte par deux réduit la partie facturée correspondante, sans diviser les sorties, les recherches, les reprises ou le temps de contrôle. Le cache réduit certains traitements répétés sous des conditions d’expiration et de droits d’accès ; ses tarifs dépendent du fournisseur, comme dans le contexte répété ne se paie qu’une fois.
| Levier | Gain à mesurer | Condition à vérifier |
|---|---|---|
| Réduction du contexte | Volume d’entrée et délai | Absence de régression sur les cas sensibles |
| Cache | Calcul ou appel évité | Fraîcheur, permissions, invalidation |
| Routage | Coût par résultat utile | Erreurs, escalades, charge de maintenance |
Le routage peut être prioritaire si un modèle coûteux traite des tâches simples ; il ne dispense pas de vérifier les informations envoyées. Je compare donc les gains observés plutôt que de présenter cet ordre comme une loi.
Quels indicateurs empêchent le contexte de grossir sans contrôle ?
Suivre les jetons d’entrée par requête utile, les erreurs critiques et les refus permet de détecter un contexte qui grossit sans bénéfice démontré et de décider une revue.
Le nombre moyen de jetons envoyés par requête, suivi dans le temps. Sans revue, le contexte peut regrossir : chaque incident produit une consigne supplémentaire, sans que les anciennes soient systématiquement réévaluées.
Que ne faut-il jamais retirer du contexte envoyé ?
Deux éléments ne doivent jamais être coupés lors d’une réduction de contexte : la consigne de refus et l’indication des sources. Ils coûtent peu et leur retrait dégrade fortement l’exploitation.
La consigne de refus définit ce que le système répond quand il ne sait pas. Elle représente quelques dizaines de jetons et conditionne le comportement le plus important en production. La retirer parce qu’elle « ne change rien sur le jeu de tests » est une erreur : le jeu de tests contient rarement assez de questions hors périmètre. Son rôle est développé dans le refus de répondre est une fonctionnalité.
L’indication des sources permet à l’utilisateur de vérifier. Elle coûte peu et constitue le principal facteur de confiance dans un système documentaire, comme le détaille un assistant documentaire avec sources et garde-fous.
J’ajoute donc au jeu de tests, avant toute campagne de réduction, une dizaine de questions hors périmètre. Sans elles, l’optimisation supprime précisément ce qui protège.
Quelles erreurs commet-on le plus souvent en réduisant le contexte ?
Les erreurs les plus fréquentes en réduisant le contexte viennent d’une coupe faite sans mesure, ou d’une mesure faite sur un jeu de tests qui ne couvre pas les cas qui comptent. Quatre reviennent régulièrement.
- Couper plusieurs blocs à la fois. Si le taux d’erreur monte, on ne sait plus lequel servait, et on remet tout.
- Réduire le nombre d’extraits sans regarder leur classement. Passer de dix à cinq n’aide que si les cinq premiers sont les bons ; sinon, il faut d’abord améliorer la recherche.
- Tronquer l’historique en perdant la question d’origine. Dans un assistant interne, par exemple, la demande initiale de l’utilisateur porte souvent le contexte utile ; mieux vaut la conserver et résumer les tours intermédiaires.
- Réduire une fois et ne plus mesurer. La consigne regrossit au rythme des incidents, et l’économie disparaît sans que personne ne le remarque.
Le critère de décision reste le même pour chaque coupe : un taux d’erreur inchangé sur un jeu de tests qui contient aussi des questions hors périmètre. Toute autre justification, « ça semble marcher » ou « les utilisateurs ne se plaignent pas », ne protège pas contre la dégradation silencieuse.
Quelles questions se poser avant de raccourcir le contexte ?
Comment savoir ce qui peut être retiré du contexte ?
Un retrait contrôlé sur des tests représentatifs permet d’évaluer un bloc ; une absence de régression sur cet échantillon doit encore être confirmée en usage surveillé.
Réduire le contexte dégrade-t-il les réponses ?
Réduire des passages inutiles peut améliorer les réponses, mais couper un passage nécessaire dégrade le résultat ; il faut mesurer rappel documentaire, erreurs et refus.
Dans quel ordre optimiser le coût d’un système d’IA ?
L’ordre dépend des postes dominants : je teste d’abord les entrées inutiles lorsqu’elles pèsent sur le coût, puis cache et routage sans perdre les contrôles.
Que ne faut-il jamais couper dans le contexte ?
La consigne de refus et l’indication des sources. Leur coût dépend de leur rédaction ; elles encadrent le refus attendu et la vérification des réponses, et doivent être maintenues dans les tests.
Les exemples dans le prompt sont-ils encore utiles ?
Parfois, mais beaucoup ont été ajoutés pour un modèle plus ancien et ne changent plus rien. Le seul moyen de le savoir est de les retirer et de rejouer le jeu de tests. S’ils ne servent pas, ils coûtent des jetons à chaque appel, indéfiniment.
Comment éviter que le contexte regrossisse après la réduction ?
En suivant dans le temps le nombre moyen de jetons envoyés par requête. Chaque incident tend à ajouter une règle à la consigne, et personne ne retire jamais rien sans indicateur. Une revue périodique de la consigne, qui supprime les règles devenues inutiles, garde l’acquis.