Qu’est-ce que la mise en cache du contexte ?
La mise en cache du contexte est un mécanisme proposé par les fournisseurs de modèles qui conserve temporairement le début identique d’une requête, pour le refacturer à tarif réduit lors des appels suivants.
Chaque appel à un modèle de langage envoie un texte complet : consigne système, règles, exemples, documents, puis la question. Sans cache, tout ce texte est retraité et refacturé à chaque requête, même quand il n’a pas changé d’un caractère.
Avec le cache, le fournisseur garde en mémoire le traitement de ce préfixe pendant une durée courte. Anthropic a ouvert cette fonction le 14 août 2024 : l’écriture du préfixe en cache est facturée 25 % plus cher que le tarif normal, chaque relecture coûte un dixième du tarif normal, et le cache expire après cinq minutes sans utilisation. D’autres fournisseurs proposent des mécanismes comparables, avec des règles de facturation différentes.
Pourquoi l’optimisation est-elle évidente dans un système documentaire ?
La mise en cache devient intéressante lorsque plusieurs requêtes réutilisent un préfixe suffisamment long et identique, ce qui doit être mesuré dans chaque système documentaire.
La consigne, les règles métier, les exemples et certaines descriptions d’outils peuvent former ce bloc stable. Les extraits récupérés et la question varient généralement davantage. Leur poids relatif n’a pas de proportion universelle.
Je relève les jetons par bloc et les répétitions effectives. Cette mesure remplace les raccourcis sur une consigne représentant trois quarts des entrées ou une question toujours négligeable.
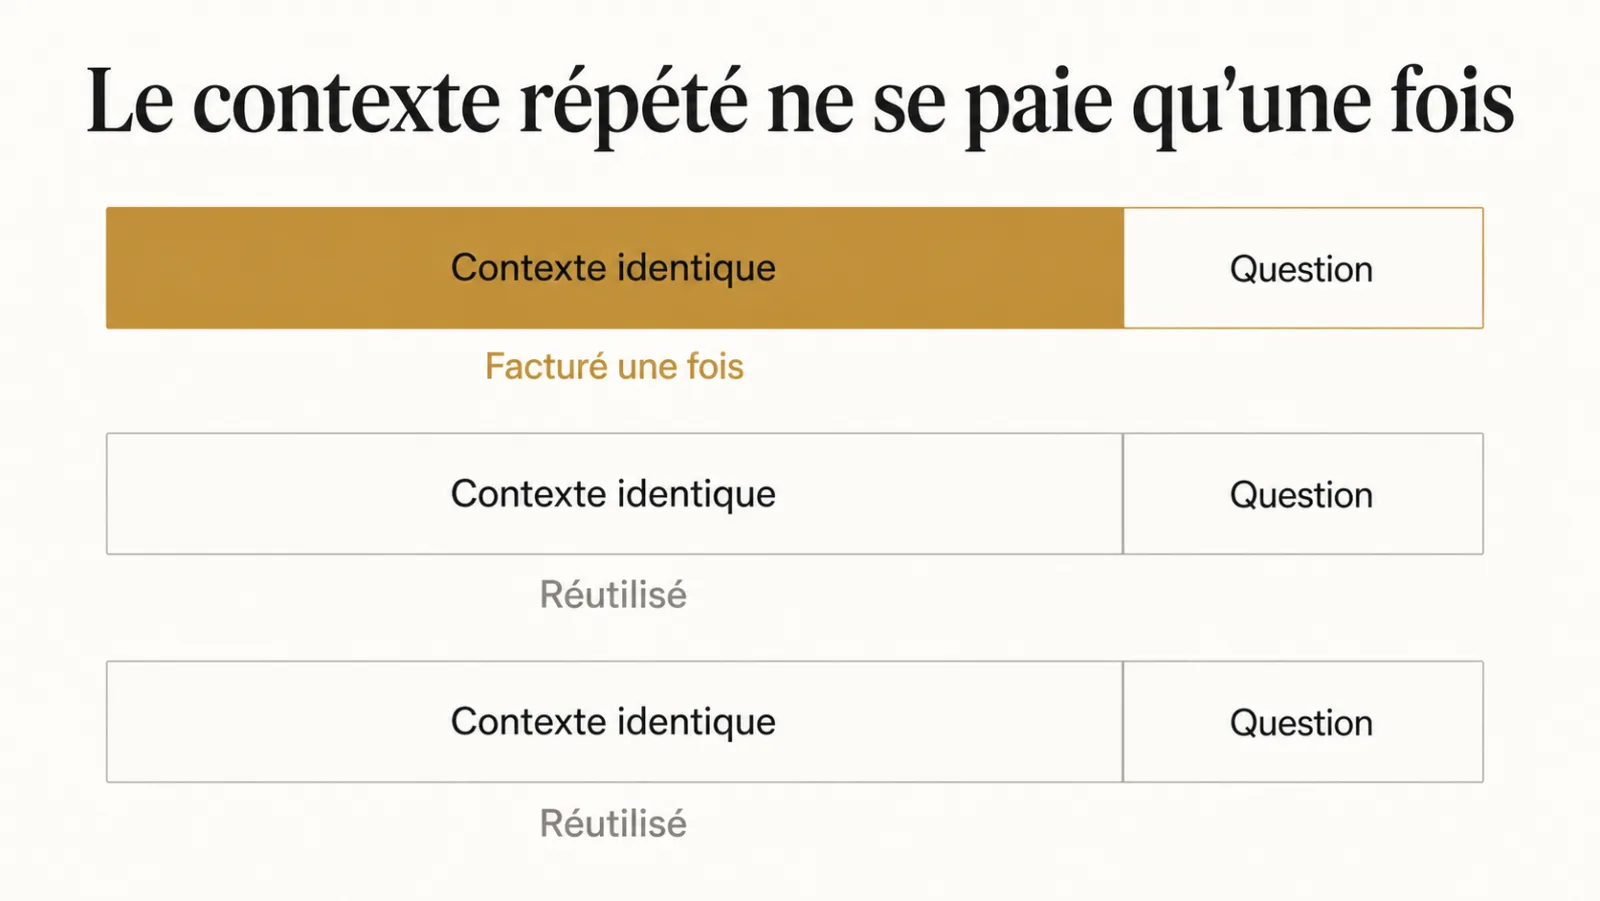
Le schéma résume la réutilisation. Côté facture, le préfixe reste payant : il faut compter l’écriture, les lectures à tarif réduit et toute nouvelle écriture après expiration ou modification.
Combien la mise en cache fait-elle économiser ?
L’économie de la mise en cache dépend de deux grandeurs propres à chaque système : la part du préfixe stable dans les jetons envoyés, et le nombre de requêtes qui réutilisent ce préfixe avant son expiration.
Le calcul se fait avec les règles tarifaires annoncées par Anthropic : écriture à 125 % du tarif d’entrée, lecture à 10 %. Pour un préfixe de taille P utilisé dans N requêtes, la première écrivant le cache et les suivantes le relisant avant expiration, le coût est 1,25 P + 0,10 P × (N − 1). Le tableau exprime des unités du tarif d’entrée et constitue un calcul, pas un résultat client :
| Nombre total de requêtes utilisant le préfixe | Coût du préfixe sans cache | Coût du préfixe avec cache | Rapport |
|---|---|---|---|
| 1 | 1 P | 1,25 P | Plus cher de 25 % |
| 2 | 2 P | 1,35 P | Environ un tiers d’économie |
| 10 | 10 P | 2,15 P | Environ quatre cinquièmes d’économie |
| 100 | 100 P | 11,15 P | Proche de neuf dixièmes d’économie |
Deux leçons s’en dégagent. Le cache coûte plus cher qu’il ne rapporte sur une requête isolée. Et l’économie tend vers le rabais de lecture dès que les requêtes s’enchaînent, ce qui en fait un levier puissant pour les usages continus. Ce raisonnement complète celui des modèles économiques par palier, comme dans choisir le palier, pas le modèle.
Qu’est-ce que le cache impose à la structure du prompt ?
Le cache fonctionne sur un préfixe exact : tout ce qui varie doit être placé après tout ce qui est stable. Il faut aussi respecter les modèles compatibles, la taille minimale et les points de cache prévus par le fournisseur.
L’erreur la plus commune consiste à insérer un élément variable au début : la date du jour, le nom de l’utilisateur, un identifiant de session. Cet élément réduit ou annule la portion réutilisable.
La restructuration à faire est mécanique. D’abord la consigne système, les règles, la description des outils, les exemples. Ensuite seulement le contexte variable : les extraits récupérés, l’historique, la question.
Ce rangement a un mérite indépendant du cache : il rend le prompt lisible et modifiable. Un prompt où le stable et le variable sont mêlés devient plus difficile à faire évoluer, ce qui est le sujet d’écrire un prompt système qui tient six mois.
Comment restructurer un prompt existant pour le cache, étape par étape ?
Restructurer un prompt existant pour la mise en cache se fait en six étapes mécaniques, de l’inventaire des blocs à la mesure du taux de réutilisation sur une semaine réelle.
- Découper le prompt actuel en blocs : consigne, règles, outils, exemples, documents, historique, question.
- Marquer chaque bloc stable ou variable. Un bloc est stable s’il est identique entre les appels autorisés que l’on veut comparer.
- Déplacer tout élément variable en fin de prompt, y compris la date, le nom de l’utilisateur et les identifiants de session.
- Vérifier la taille du préfixe stable. Un préfixe trop court n’est pas éligible ; le seuil se vérifie pour le modèle retenu.
- Activer le cache sur le dernier bloc stable, selon la syntaxe et les modèles pris en charge par le fournisseur.
- Mesurer le taux de réutilisation sur une semaine d’usage réel, et seulement ensuite annoncer une économie.
Si l’appel au modèle est isolé derrière une couche d’abstraction, comme décrit dans la couche qui rend le modèle remplaçable, cette restructuration se fait à un seul endroit pour tout le système.
Quels usages peuvent réutiliser un préfixe stable ?
Les consignes longues, les descriptions d’outils et les documents interrogés plusieurs fois offrent des préfixes réutilisables, à condition que les appels arrivent avant expiration.
- Les assistants à consigne longue, où les règles métier représentent des milliers de jetons répétés à chaque question.
- Les agents outillés, dont la description des outils est volumineuse et invariable. Voir le protocole qui rend les agents branchables.
- Les traitements par lot sur un même document, où l’on pose plusieurs questions sur le même contrat.
- Les conversations longues, où le début de l’échange devient un préfixe stable au fil des tours.
Quelles limites faut-il connaître avant de compter sur le cache ?
Un cache a une durée de vie courte et un seuil minimal de taille, ce qui le rend inutile sur les usages peu fréquents. Il faut donc vérifier que le profil d’usage s’y prête avant d’en faire une hypothèse budgétaire.
La durée de vie se compte en minutes. Un système consulté trois fois par jour ne bénéficiera d’aucune réutilisation : chaque nouvel envoi au cache paiera son écriture. Des appels fréquents améliorent les chances de réutilisation seulement si leur préfixe et leur périmètre de cache correspondent.
Le seuil de taille exclut les prompts courts. En dessous d’un certain nombre de jetons, le préfixe n’est pas mis en cache du tout.
La réutilisation d’un préfixe exact ne doit pas changer le contenu traité ; toute restructuration de la consigne demande toutefois une vérification des réponses. C’est une optimisation d’abord économique, et elle ne dispense pas de réduire le contexte envoyé. Le raisonnement de une grande fenêtre reste une facture reste entièrement valable.
Quelle vérification doit précéder l’annonce d’une économie ?
L’économie doit être calculée sur les écritures et lectures réellement facturées pendant une période représentative, car une démonstration enchaînée surestime souvent la réutilisation.
Mesurer le taux de réutilisation réel du cache sur une semaine, pas sur un test. Un système dont l’usage est irrégulier peut afficher un taux très bas, et l’économie annoncée en réunion n’arrivera jamais sur la facture.
Qu’est-ce que le cache change dans la conception d’un agent ?
Le cache peut réduire le coût répété d’exemples et de règles détaillées, mais chaque ajout conserve un coût et doit améliorer un comportement vérifié.
Une consigne plus longue peut expliciter les cas limites ou préciser un format, ce qui complète les sorties structurées. Elle peut aussi introduire des contradictions ou des passages inutiles.
Je compare les réponses avant et après ajout, à données et modèle constants. Si l’on déplace les blocs pour rendre le préfixe stable, il faut aussi vérifier que ce changement d’ordre n’a pas déplacé les priorités de la consigne.
Le cache n’est donc pas une autorisation d’allonger sans limite. L’écriture et les lectures restent facturées ; le contexte conserve des limites de taille, de pertinence et de maintenance.
Dans quel ordre appliquer les optimisations de coût ?
Réduire le contexte d’abord, mettre en cache ensuite, router en dernier : c’est mon ordre de travail pour éviter de conserver des envois inutiles. L’inverse, router d’abord, produit des systèmes complexes qui envoient encore trop.
La raison est arithmétique. Réduire de moitié le contexte envoyé divise la facture du contexte par deux sur tous les paliers à la fois. Mettre en cache un contexte déjà réduit économise sur une base plus petite mais reste très rentable. Router en dernier optimise ce qui reste, en envoyant les tâches simples vers les modèles économiques décrits dans les usages qui basculent quand le coût s’effondre.
L’ordre se réévalue selon les postes de coût mesurés ; le routage peut être prioritaire dans un autre profil d’usage. Voir une grande fenêtre reste une facture.
Quelles erreurs empêchent la mise en cache de fonctionner ?
Les erreurs qui empêchent la mise en cache de fonctionner sont presque toutes des erreurs de structure ou de mesure, rarement des erreurs de configuration du fournisseur.
- Un horodatage en tête de prompt. Il change à chaque appel et casse le préfixe.
- Des exemples tirés au hasard. Un ordre variable des exemples rend le préfixe différent à chaque requête.
- Des documents récupérés placés avant les règles. Ils varient d’une question à l’autre et invalident tout ce qui suit.
- Une estimation fondée sur un test. Dix requêtes enchaînées en démonstration ne reflètent pas l’usage d’une journée réelle.
- L’oubli du surcoût d’écriture. Sur un usage sporadique, le cache augmente la facture au lieu de la réduire.
Ces vérifications font partie d’un audit IA portant sur le coût d’exploitation d’un système.
Comment vérifier qu’un cache de contexte réduit réellement le coût ?
Comment structurer un prompt pour profiter du cache ?
Placez les blocs identiques avant les blocs variables, puis vérifiez les points de cache et les limites du modèle utilisé dans les compteurs de réponse.
Combien coûte la mise en cache chez Anthropic ?
À son lancement en août 2024, l’écriture en cache est facturée 25 % de plus que le tarif d’entrée et chaque relecture 10 % de ce tarif. Le cache expire après cinq minutes sans utilisation, ce qui réserve le gain aux usages fréquents.
Le cache réduit-il aussi la latence ?
Le cache peut réduire le traitement d’un préfixe répété, sans dispenser de mesurer la latence complète ni de tester les réponses après une restructuration.
Sur quels usages le gain est-il nul ?
Sur les systèmes peu consultés : la durée de vie d’un cache se compte en minutes, donc un service utilisé trois fois par jour paiera le plein tarif à chaque requête, voire le surcoût d’écriture.
Faut-il en profiter pour allonger la consigne système ?
Allonger la consigne n’est utile que si les exemples supplémentaires améliorent les réponses vérifiées, car le cache conserve des coûts de lecture, d’écriture et de maintenance.
Dans quel ordre optimiser le coût d’un système ?
Réduire le contexte envoyé, puis mettre en cache le préfixe stable, puis router les tâches simples vers des modèles plus petits. Cet ordre attaque d’abord le gaspillage principal, qui touche tous les modèles à la fois.