Qu’est-ce qu’un modèle multimodal natif comme Gemini 1.0 ?
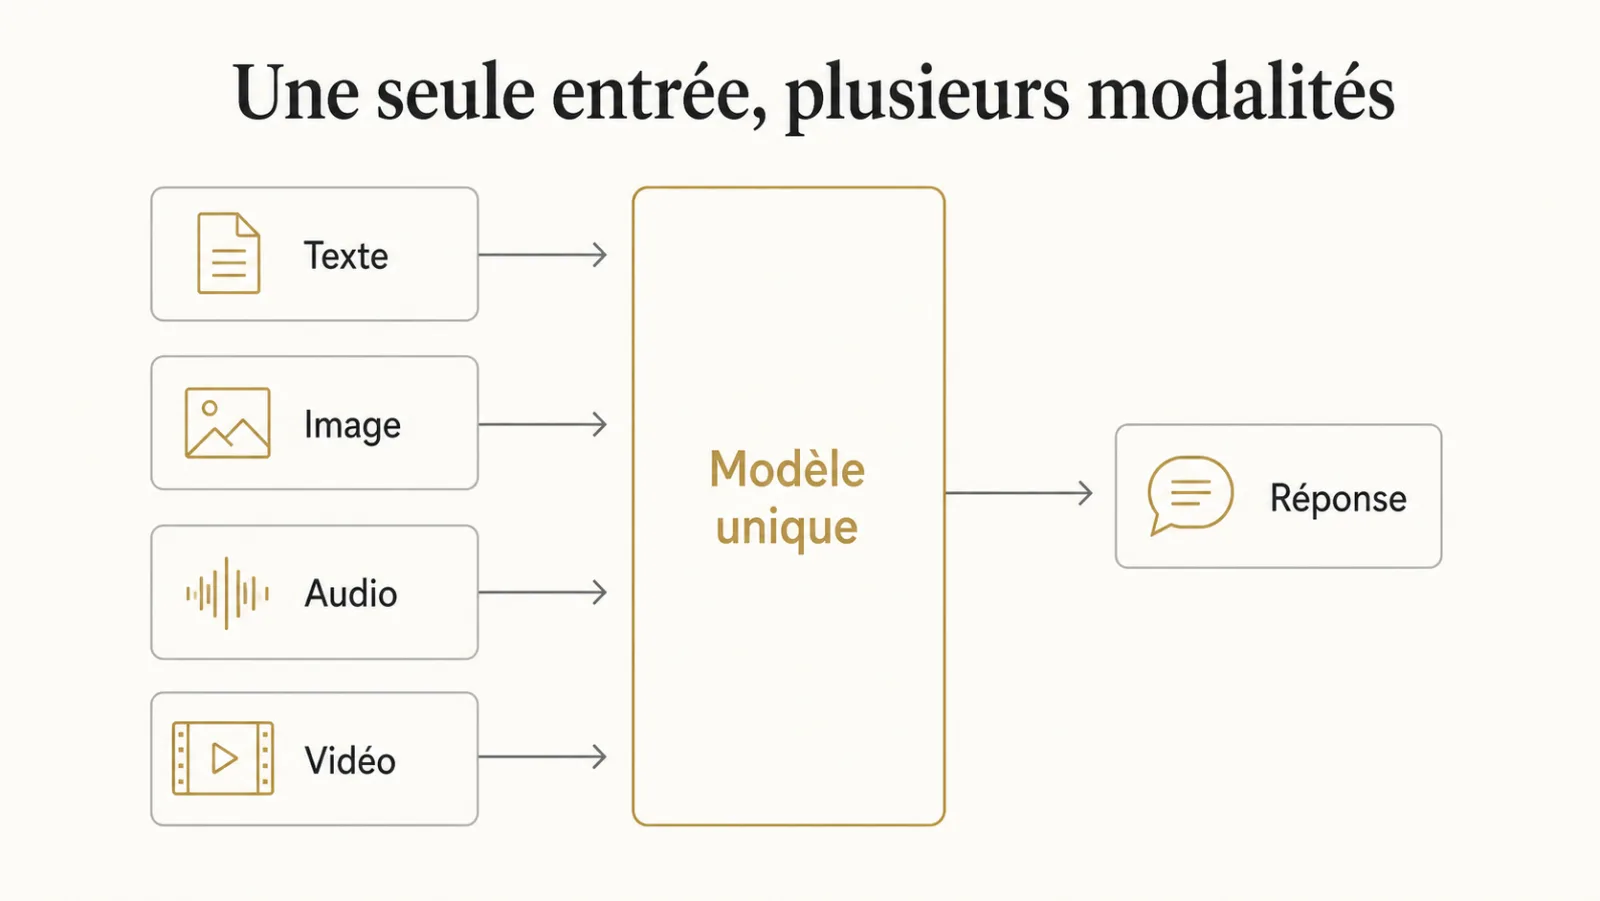
Un modèle multimodal natif comme Gemini 1.0 traite texte, image, audio et vidéo dans une seule architecture, au lieu d’enchaîner des modèles spécialisés qui se passent le relais. La différence n’est pas cosmétique : elle supprime les pertes de conversion entre étapes.
Google a présenté Gemini 1.0 en trois tailles, Ultra, Pro et Nano, avec un argument central : le modèle a été conçu dès l’origine pour plusieurs modalités, plutôt que d’ajouter la vision ou l’audio à un modèle de langue existant. Pour une direction, la définition opérationnelle tient en une phrase : on peut poser une question à une page scannée, à un schéma ou à un extrait de vidéo comme on la poserait à un texte.
Dans une chaîne classique, une vidéo passe par une transcription audio, une extraction d’images, une description de ces images, puis une synthèse textuelle. Chaque étape perd de l’information et ajoute une source d’erreur. Ce qui relie une phrase prononcée à ce qui était montré au même moment disparaît en général dès la première conversion.
Un traitement natif conserve cette relation. C’est ce qui rend possibles des questions du type « à quel moment le présentateur montre-t-il le tableau des tarifs », qu’une chaîne d’outils traite mal.
Quelle différence entre une chaîne d’outils et un traitement natif ?
La différence entre une chaîne d’outils et un traitement multimodal natif tient au nombre de conversions intermédiaires, chacune pouvant détruire une information que la suivante ne retrouvera jamais. Le tableau ci-dessous résume ce qui change concrètement pour une équipe qui exploite un corpus documentaire.
| Critère | Chaîne d’outils spécialisés | Traitement natif |
|---|---|---|
| Nombre de composants | Plusieurs (reconnaissance optique, transcription, description d’images, synthèse) | Un seul modèle |
| Relation entre modalités | Perdue dès la première conversion | Conservée (ce qui est dit et ce qui est montré) |
| Tableaux et mises en page complexes | Souvent détruits par l’extraction de texte | Lus comme une structure visuelle |
| Coût par document propre | Faible, outils éprouvés | Plus élevé, une page en image consomme davantage |
| Diagnostic d’une erreur | Possible étape par étape | Plus difficile, une seule boîte |
| Remplacement d’un composant | Pièce par pièce | Modèle entier |
Aucune colonne ne gagne partout. La chaîne d’outils reste moins chère et plus facile à diagnostiquer sur les documents propres ; le traitement natif l’emporte dès que la mise en page porte du sens. Le choix se fait donc document par document, pas une fois pour toutes, et il dépend autant de la façon de découper un document que du modèle retenu.
Quels sont les usages réels de la multimodalité en entreprise ?
Sur les corpus que je rencontre, le premier usage réel de la multimodalité en entreprise n’est pas la vidéo mais le document mal numérisé. Il est moins spectaculaire et beaucoup plus fréquent.
Un corpus d’entreprise contient toujours une proportion importante de documents non textuels : contrats scannés, formulaires remplis à la main, plans techniques, captures d’écran archivées, tableaux photographiés. Ces pièces étaient invisibles à la recherche documentaire, ou passaient par une reconnaissance optique qui produisait un texte inexploitable dès que la mise en page était complexe.
Le second usage est le tableau. Un tableau dans un PDF est une structure visuelle que l’extraction de texte détruit : les colonnes se mélangent, les cellules fusionnées disparaissent. Un modèle qui voit la page lit le tableau correctement. Un service achats qui interroge des grilles tarifaires fournisseurs, ou une direction financière qui retrouve un montant dans un rapport annuel numérisé, en tire un bénéfice immédiat.
Le troisième, plus loin derrière, est l’enregistrement de réunion. La valeur y est réelle mais le cadre juridique et social l’est aussi, et il vaut mieux le traiter avant l’outil.
Ces trois usages ont un point commun : ils alimentent un système de recherche documentaire existant plutôt qu’ils ne créent un produit nouveau. La multimodalité élargit ce qu’un système de récupération augmentée peut indexer ; elle ne remplace pas l’architecture.
Que faut-il arbitrer avant de traiter des images avec un modèle ?
- Le coût par page. Traiter une page comme image consomme beaucoup plus de jetons que la traiter comme texte, et la différence est visible dès quelques milliers de pages.
- Le moment du traitement. Extraire une fois à l’indexation coûte moins cher que réenvoyer l’image à chaque question. Voir le corpus est le projet.
- La vérifiabilité. Une donnée lue dans une image doit pouvoir être retracée jusqu’à la zone de la page dont elle provient, sans quoi aucune correction n’est possible.
- Le cadre juridique pour l’audio. Enregistrer et traiter une réunion engage le droit du travail et la protection des données, indépendamment de la capacité technique.
- La confidentialité des pièces. Un scan contient souvent plus que ce qu’on croit : signatures, numéros, annotations. Les règles valent pour l’image comme pour le texte, voir ce qu’on a le droit de mettre dans un prompt.
Comment tester un modèle multimodal sur son propre corpus ?
Tester un modèle multimodal sur son propre corpus consiste à mesurer ce qu’il extrait des pires documents, pas des meilleurs, avec une vérité de référence établie par les personnes qui connaissent ces pièces. Une démonstration sur des documents choisis ne dit rien de la qualité perçue en production.
La méthode tient en six étapes, réalisables en quelques jours :
- Inventorier les types de pièces. Lister les familles de documents non textuels du corpus : scans de contrats, formulaires manuscrits, plans, tableaux photographiés. Estimer grossièrement la part de chacune.
- Choisir les cas difficiles. Retenir, dans chaque famille, les documents les plus mal numérisés : pages penchées, tampons sur le texte, cellules fusionnées, écriture manuscrite.
- Écrire la réponse attendue. Pour chaque document, un expert métier note les trois ou quatre informations qu’on doit pouvoir en tirer. C’est la vérité de référence.
- Comparer avec la chaîne actuelle. Passer les mêmes documents dans la reconnaissance optique existante, pour savoir si le modèle apporte un gain ou seulement un coût.
- Vérifier la traçabilité. Pour chaque donnée extraite, contrôler qu’on peut désigner la zone de la page d’où elle vient.
- Calculer le coût à l’échelle. Multiplier le coût observé par page par le volume réel du corpus, réindexations comprises.
Ce protocole produit une décision chiffrée sur vos propres pièces, et non une impression laissée par une vidéo de lancement. C’est aussi le type d’essai qu’un audit IA place en tête, avant tout choix de fournisseur.
Pourquoi la multimodalité ne règle-t-elle pas le problème des versions ?
Un modèle qui lit une image ne sait pas laquelle des trois versions d’un plan fait autorité, et c’est ce problème-là qui bloque les projets. La capacité technique déplace la difficulté sans la supprimer.
Un corpus visuel a les mêmes défauts qu’un corpus textuel, souvent aggravés : plusieurs versions d’un même plan, aucune date lisible, aucune indication de validité, des annotations manuscrites contradictoires. Le modèle lira tout, fidèlement, y compris la version périmée.
La réponse n’est pas technique. Elle consiste à décider, en amont, quelle source fait foi et à ne charger que celle-là, ou à porter cette information dans les métadonnées pour que le système puisse trancher. C’est un travail d’organisation documentaire, pas d’ingénierie, et c’est celui que les projets sous-estiment le plus souvent, comme le montre anatomie d’un PoC qui ne passe jamais.
Le test qui vaut mieux qu’une démonstration
Prendre dix documents parmi les plus mal numérisés du corpus réel, pas les plus propres, et vérifier ce que le modèle en extrait. C’est ce dixième-là qui décidera de la qualité perçue du système, parce que c’est celui sur lequel les utilisateurs buteront.
Quelles erreurs faut-il éviter avec un modèle multimodal ?
Les erreurs les plus fréquentes avec un modèle multimodal viennent de l’enthousiasme pour la capacité, au détriment du coût, de la vérifiabilité et de l’organisation documentaire. Quatre reviennent avec régularité.
- Tout envoyer en image. Traiter comme une image un document qui possède déjà une couche texte propre multiplie la facture sans rien gagner. Le tri entre documents propres et documents difficiles doit précéder le modèle.
- Interroger l’image à chaque question. Réenvoyer la même page à chaque requête revient à payer l’extraction indéfiniment. Une grande fenêtre de contexte ne change pas ce calcul, comme le rappelle une grande fenêtre reste une facture.
- Accepter une valeur sans sa provenance. Un montant lu dans un tableau scanné, sans indication de la cellule d’origine, ne peut être ni vérifié ni corrigé.
- Évaluer sur des documents propres. Un essai sur les pièces les mieux numérisées donne un taux de réussite flatteur qui s’effondre au premier contact avec le corpus réel.
Que change la multimodalité pour la chaîne documentaire ?
La distinction entre document textuel et document image va cesser d’être structurante, et c’est la conséquence de fond de la multimodalité native pour les chaînes documentaires. Les chaînes de traitement construites autour de cette distinction devront être simplifiées.
Aujourd’hui, la plupart des architectures documentaires comportent une branche pour le texte et une branche pour l’image, avec des outils différents, des qualités différentes et des taux d’erreur différents. Cette dualité disparaîtra progressivement au profit d’un traitement unique.
Le conseil pratique qui en découle : ne pas investir lourdement dans une chaîne de reconnaissance optique en 2024, mais construire l’indexation de façon à pouvoir remplacer ce composant. C’est un cas particulier de la réversibilité, qui reste le principe le plus rentable sur ces systèmes, comme le rappelle la dette technique d’un système d’IA.
Cette recommandation vaut aussi pour l’inverse. Une organisation qui dispose déjà d’une chaîne de reconnaissance optique éprouvée n’a aucune raison de la jeter : elle est moins chère et souvent plus rapide sur les documents propres, qui constituent la majorité du volume. Le bon réglage consiste à la conserver pour le tout-venant et à n’envoyer au modèle multimodal que les pièces sur lesquelles elle échoue, ce qui se détecte automatiquement.
Questions fréquentes
La multimodalité remplace-t-elle la reconnaissance optique ?
Progressivement, oui, pour les documents à mise en page complexe où l’extraction de texte échoue. Pour un texte simple et propre, l’extraction classique reste beaucoup moins chère et tout aussi fiable. Le bon montage combine les deux et réserve le modèle aux pièces difficiles.
Faut-il traiter les images à l’indexation ou à la question ?
À l’indexation, dans la quasi-totalité des cas. Extraire une fois coûte beaucoup moins cher que réenvoyer l’image à chaque question, et le résultat devient interrogeable comme n’importe quel texte.
Peut-on traiter des enregistrements de réunion ?
Techniquement oui, juridiquement c’est un autre sujet : enregistrer et traiter une réunion engage le droit du travail et la protection des données. Le cadre doit être posé avant l’outil, pas après.
Que faire des plans en plusieurs versions ?
Décider en amont lequel fait autorité, ou porter cette information dans les métadonnées. Un modèle lit fidèlement toutes les versions, y compris la périmée : la hiérarchie des sources est une décision humaine.
Qu’est-ce que la multimodalité native change par rapport à un modèle de langue avec un module de vision ?
Un modèle natif traite les modalités ensemble dès sa conception, au lieu de convertir l’image ou le son en texte avant de raisonner. Il conserve donc des relations que la conversion détruit, comme le lien entre une phrase prononcée et ce qui est montré au même moment. Pour un tableau ou un plan, cela se traduit par une lecture de la structure plutôt que d’une suite de mots.
Comment savoir si un modèle multimodal vaut son coût sur mon corpus ?
En le comparant à la chaîne actuelle sur un échantillon de documents difficiles, avec une réponse attendue écrite par un expert métier. Si le gain n’apparaît que sur les pièces propres, la reconnaissance optique existante suffit. Le coût se calcule ensuite au volume réel, réindexations comprises.