Que change un modèle comme GPT-4o mini quand le coût par tâche s’effondre ?
Un modèle comme GPT-4o mini peut rendre certains traitements répétitifs plus accessibles lorsque le coût d’inférence diminue, à condition que la vérification et l’intégration restent économiquement acceptables. Le prix du jeton est un élément du calcul, pas la rentabilité complète.
L’annonce OpenAI du 18 juillet 2024 fixe le tarif de lancement à 0,15 dollar par million de jetons d’entrée et 0,60 dollar par million de jetons de sortie. Les deux unités doivent être comptées.
Dans un scénario fictif de 1 000 jetons d’entrée et 200 jetons de sortie, l’inférence revient arithmétiquement à 0,00027 dollar par appel, hors autres coûts. Cette hypothèse ne décrit pas vos documents : il faut mesurer leurs volumes, les reprises et la charge de contrôle.
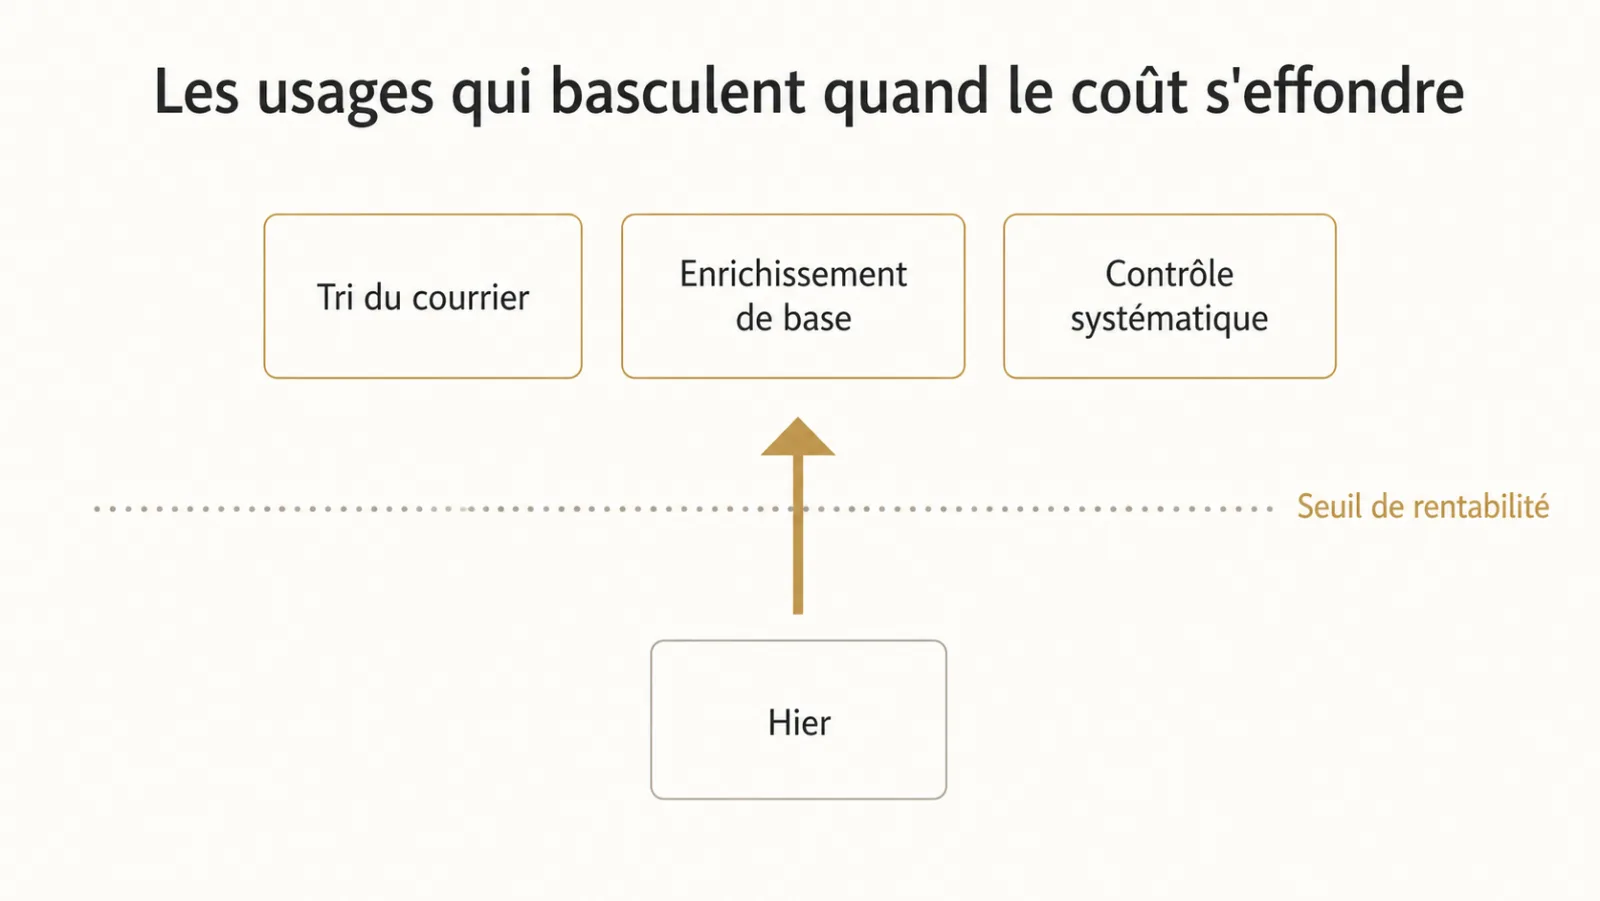
Le tri du courrier, l’enrichissement de fiches ou le contrôle de complétude deviennent des candidats à examiner. Ils restent à valider sur leurs erreurs et leur utilité réelle.
Qu’est-ce qu’un traitement de masse par IA générative ?
Un traitement de masse par IA générative applique un même jugement simple à des milliers d’éléments, sans interaction humaine à chaque appel, pour trier, enrichir ou contrôler un flux de documents. Il s’oppose à l’assistant conversationnel, où une personne pose une question et lit la réponse.
| Critère | Assistant conversationnel | Traitement de masse |
|---|---|---|
| Déclencheur | Une question posée par une personne | Un flux de documents ou de fiches |
| Volume | Quelques dizaines d’appels par utilisateur | Des milliers à des centaines de milliers d’unités |
| Visibilité | Forte, se montre en réunion | Faible, produit une absence de travail |
| Mesure du succès | Satisfaction, adoption | Taux d’erreur, temps économisé |
| Risque principal | Réponse fausse lue et crue | Dérive de coût, erreur répétée à grande échelle |
| Effet d’une baisse de prix | Marginal | Décisif |
Le tableau montre pourquoi la baisse de prix touche surtout la colonne de droite : quand le volume est multiplié par mille, une division du coût unitaire change la décision.
Comment repérer les usages qui basculent chez vous ?
Le critère fiable pour repérer un usage qui bascule est simple : chercher les traitements que quelqu’un fait à la main aujourd’hui, en série, sur des milliers d’unités. C’est un point de départ, à compléter par la faisabilité et le coût d’erreur.
Trois questions suffisent :
- Y a-t-il une personne qui, chaque semaine, applique le même jugement simple à des centaines d’éléments ?
- Ce jugement est-il énonçable en trois lignes ?
- Une erreur occasionnelle est-elle rattrapable ?
Si les trois réponses sont oui, le traitement est un candidat. Les exemples reviennent d’un secteur à l’autre : orienter une demande vers le bon service, repérer les pièces manquantes d’un dossier, détecter qu’un document est une facture plutôt qu’un bon de commande, signaler les fiches produit sans description.
Le piège à éviter est de viser trop haut. Pré-trier avant un jugement expert peut limiter l’impact des erreurs, mais doit aussi démontrer un bénéfice sur le flux réel. La distinction est développée dans combien de cas d’usage faut-il abandonner, et la limite est posée dans ce qu’on ne délègue jamais à un modèle.
Quels contrôles préparer avant de lancer un traitement de masse ?
Avant de lancer un traitement de masse, je prépare une simulation de coût, une catégorie de doute, des critères d’erreur et des traces permettant de corriger chaque unité traitée.
- Le coût total simulé sur le volume réel, pas sur un échantillon. Cent mille documents à un centième de centime restent une ligne budgétaire.
- Le comportement en cas de doute. Un traitement de masse doit produire une catégorie « à vérifier », faute de quoi il transforme l’incertitude en décision.
- Le taux d’erreur acceptable, fixé avant de lancer, et mesuré sur un échantillon relu à la main.
- La traçabilité : pouvoir remonter de chaque décision à son entrée, sans quoi aucune correction n’est possible. Voir l’observabilité des systèmes IA.
Comment lancer un traitement de masse sans mauvaise surprise ?
Un traitement de masse se lance en cinq étapes, de l’échantillon relu à la main jusqu’à la production surveillée, et aucune ne peut être sautée sans risque sur le coût ou la qualité. La méthode est la même quel que soit le secteur.
- Écrire la règle de décision en trois lignes, avec la liste fermée des catégories possibles, dont « à vérifier ».
- Constituer un échantillon de référence de quelques centaines d’éléments réels, classés à la main par la personne qui fait le travail aujourd’hui.
- Mesurer le taux d’erreur du modèle sur cet échantillon, et le comparer au seuil fixé à l’avance.
- Lancer sur mille unités, mesurer le coût réel et observer les cas difficiles.
- Passer en production avec plafond de dépense, suivi du taux de « à vérifier » et relecture périodique d’un échantillon, dans la logique de l’évaluation continue.
Comment éviter qu’un traitement par lot fasse exploser la facture ?
Un traitement par lot mal borné peut consommer un budget entier en une nuit, et une cause possible est : une boucle qui retraite ce qui a déjà été traité. Ce scénario mérite un test de panne et de reprise.
Le scénario type : le traitement échoue sur une pièce, redémarre depuis le début, échoue de nouveau, et recommence. Sans plafond, la facture croît jusqu’à ce que quelqu’un s’en aperçoive, c’est-à-dire au relevé.
Les parades sont simples et doivent être posées avant le premier lancement : un plafond de dépense par exécution appliqué par le système, un marquage des éléments déjà traités, une limite au nombre de reprises, et une alerte sur le volume traité par heure.
Vérifiez ces protections sur un échec simulé. Leur présence dans une configuration ne démontre pas que le budget et les reprises sont réellement bornés.
Comment dimensionner un pilote avant de traiter tout le volume ?
Un pilote de traitement de masse doit représenter les formats, les longueurs et les cas difficiles du flux, avec des limites de coût et des résultats examinés séparément. Mille unités peuvent constituer une proposition de pilote, pas un seuil de fiabilité.
Incluez explicitement les documents longs, illisibles et ambigus. Un tirage aléatoire peut manquer un défaut rare. Comparez les volumes facturés et le travail de correction, puis extrapolez en exposant les hypothèses.
Comment rendre visible la valeur d’un traitement de masse ?
La valeur d’un traitement de masse est réelle mais invisible, et seule une mesure faite avant le lancement permet de la démontrer lors de la première revue du projet. Il faut l’anticiper si l’on veut que le projet survive.
Un assistant conversationnel se montre en réunion. Un tri automatique du courrier entrant ne se montre pas : il produit une absence de travail, ce qui ne se photographie pas.
La parade consiste à mesurer avant, pour pouvoir comparer après. Le temps passé au tri manuel, le délai moyen de traitement d’une demande, le nombre de dossiers incomplets détectés tardivement. Ces chiffres relevés en amont transforment un gain invisible en résultat démontrable.
C’est le même principe que celui posé dans mesurer l’adoption, pas la satisfaction : une référence avant lancement rend la comparaison plus solide.
Comment choisir un projet d’IA quand l’appel ne coûte presque rien ?
La baisse du coût unitaire déplace le bon critère de sélection d’un projet d’IA : du cas d’usage le plus impressionnant vers le cas d’usage le plus répétitif. C’est un renversement complet par rapport aux deux années précédentes.
Quand chaque appel coûtait cher, la logique voulait qu’on réserve l’IA aux tâches à forte valeur unitaire : une analyse experte, une synthèse stratégique. Ces tâches sont rares, difficiles à évaluer, et leur automatisation déçoit souvent.
Quand l’appel ne coûte presque rien, la logique s’inverse : on vise le volume. Une tâche répétée à grand volume peut produire un gain, si les erreurs, la revue et l’intégration n’en absorbent pas la valeur. C’est aussi le type de projet qui aboutit le plus souvent, parce que le succès y est vérifiable.
Le choix du modèle suit la même logique que celle décrite pour choisir le palier plutôt que le modèle : le petit modèle pour le tri en volume, le grand pour les rares cas qui le justifient. Pour identifier ces traitements dans une organisation, un audit IA part de l’inventaire des tâches répétitives plutôt que des idées de chatbot.
Quelles erreurs éviter avec les modèles à bas coût ?
Les erreurs typiques avec les modèles à bas coût consistent à croire que le prix bas dispense de mesurer, à confier un jugement expert au tri automatique et à oublier que le volume multiplie aussi les erreurs. Le coût unitaire baisse, pas la responsabilité.
- Confondre bas coût et absence de budget. Le volume reconstitue une ligne budgétaire, comme le montrait déjà le coût d’une grande fenêtre de contexte.
- Supprimer la catégorie « à vérifier » pour afficher un taux d’automatisation flatteur.
- Ne plus relire d’échantillon une fois le traitement lancé, alors que les documents entrants évoluent.
Lectures complémentaires : combien de cas d’usage faut-il abandonner ; l’observabilité des systèmes IA ; mesurer l’adoption, pas la satisfaction. Ces liens complètent la navigation du site.
Quelles questions décident de l’intérêt d’un petit modèle pour un grand volume ?
L’intérêt d’un petit modèle pour un grand volume dépend du coût complet, des erreurs acceptables, des corrections nécessaires et de la valeur des tâches effectivement automatisées.
Questions fréquentes
Quels usages deviennent rentables quand le coût s’effondre ?
Les traitements systématiques sur de très grands volumes : tri du courrier entrant, enrichissement de base documentaire, contrôle exhaustif de complétude. Individuellement triviaux, massivement coûteux à la main.
Comment repérer un bon candidat au traitement de masse ?
Chercher un jugement simple, énonçable en trois lignes, appliqué à la main sur des centaines d’éléments chaque semaine, et dont l’erreur occasionnelle est rattrapable.
Comment éviter qu’un traitement par lot dérape ?
Par un plafond de dépense appliqué par le système, un marquage des éléments déjà traités, une limite au nombre de reprises et une alerte sur le volume horaire. Vérifiez leur effet sur des pannes simulées.
Pourquoi tester sur mille unités et pas sur dix ?
Mille unités sont un exemple de pilote, pas une règle. Le choix dépend des familles de documents et des erreurs recherchées ; les cas rares critiques demandent des scénarios dédiés.
Un petit modèle comme GPT-4o mini peut-il remplacer un grand modèle ?
Pour les tâches de tri, de classement et d’extraction simple, souvent oui, à condition de le vérifier sur un échantillon réel. Pour un jugement expert ou une synthèse délicate, le grand modèle reste préférable, et l’architecture la plus économique combine les deux.
Comment prouver la valeur d’un traitement automatique invisible ?
En mesurant avant le lancement le temps passé à la main, le délai de traitement et les erreurs détectées tardivement. Ces mesures de référence permettent ensuite de chiffrer le gain, qui ne se voit pas en démonstration.