Que change réellement une génération majeure comme GPT-5 dans un système en production ?
Remplacer le modèle d’un assistant documentaire peut améliorer ses réponses, mais ne met pas automatiquement à jour le corpus, la récupération, les consignes ni les permissions. C’est le rappel le plus utile à faire quand l’annonce tombe.
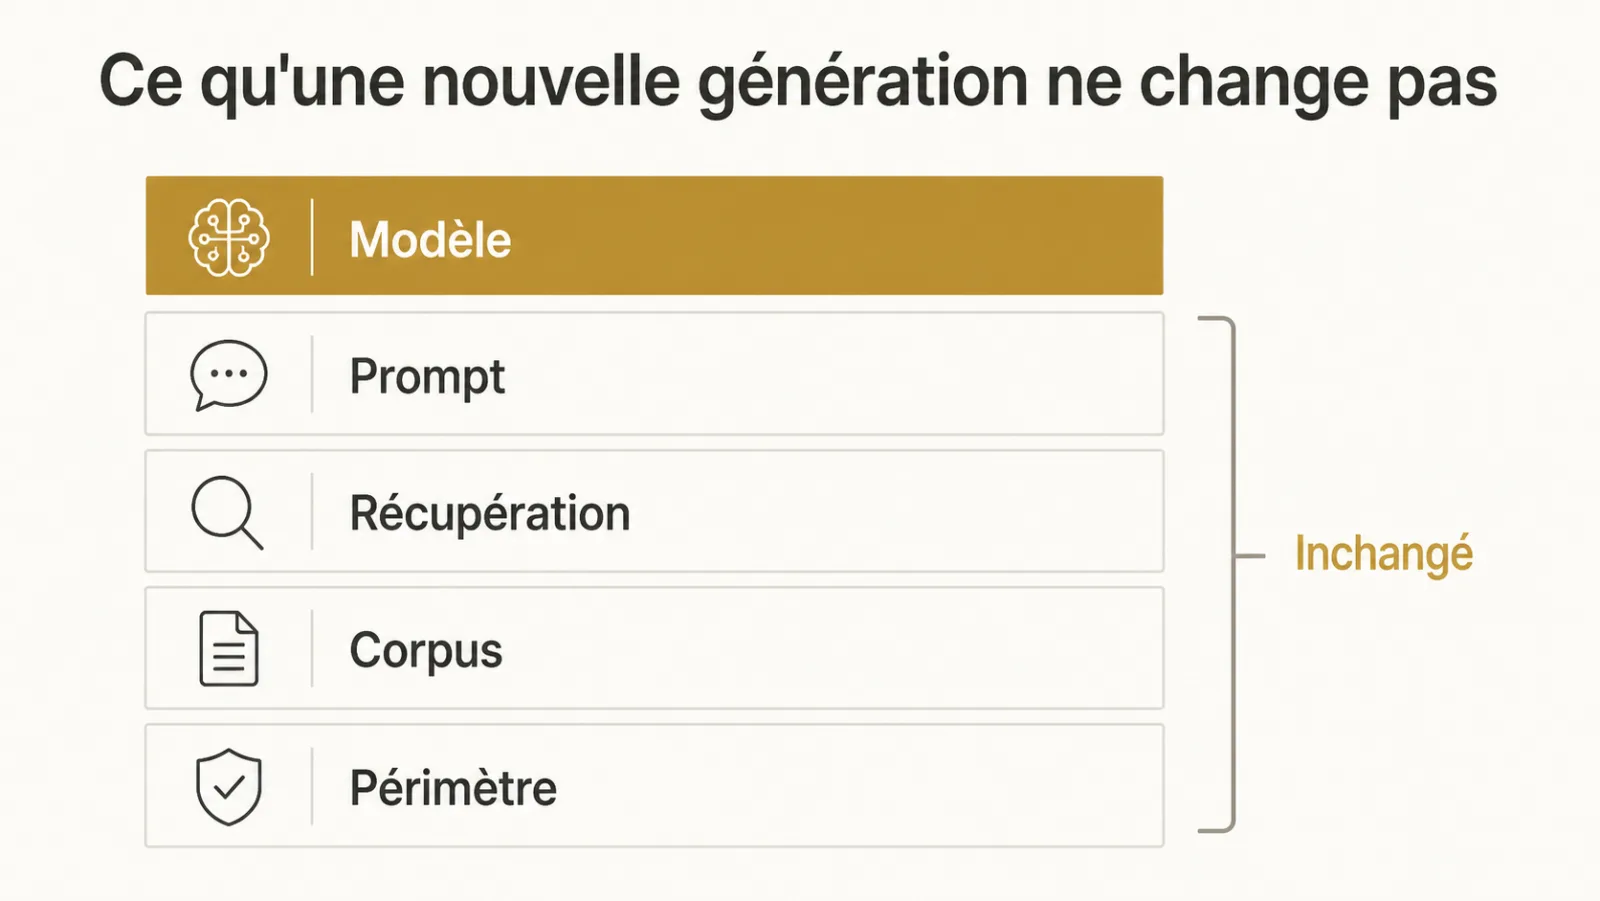
Pour analyser un assistant documentaire en production, j’utilise une grille de cinq couches : un corpus (les documents qui font foi), une chaîne de récupération (ce qui choisit les extraits envoyés au modèle), un prompt (les consignes permanentes), un périmètre d’action (ce que le système a le droit de faire et de répondre) et un modèle. Cette grille de diagnostic ne prétend pas décrire toutes les architectures d’IA.
Le 7 août 2025, OpenAI présente GPT-5 avec des progrès annoncés sur les instructions, le raisonnement et la réduction des hallucinations. Ce sont des résultats de l’éditeur, à confronter à nos tâches. Ils n’indiquent pas quelle version d’une procédure interne fait autorité.
| Couche | Ce qu’une nouvelle génération y change | Exemple de défaut qui persiste |
|---|---|---|
| Corpus | Pas de mise à jour automatique | Trois versions d’une même procédure, sans date |
| Récupération | À vérifier dans l’intégration | Le bon document ne remonte pas dans les extraits |
| Prompt | Peu, mais des réglages sont à revérifier | Une règle calée sur les manies de l’ancien modèle |
| Périmètre | Permissions à conserver et contrôler | Aucune consigne sur ce que le système ne fait pas |
| Modèle | Capacité, coût, tenue des formats | Les cas limites restent souvent fragiles |
Pourquoi attendre le prochain modèle pour corriger la qualité fait-il perdre des mois ?
Attendre un prochain modèle retarde inutilement la correction lorsqu’un défaut provient des documents, des accès ou de la récupération déjà observables dans le système actuel. Il faut diagnostiquer la cause avant de décider d’attendre.
Une réponse fondée sur une procédure périmée peut résulter du choix du document, mais aussi d’une instruction mal suivie. Un refus incorrect peut venir du modèle ou de la règle de périmètre. Ce sont des hypothèses à départager, pas des causes attribuées d’avance.
Je pars de quelques mauvaises réponses réelles. Pour chacune, je conserve la question, les extraits fournis, la version du prompt et les permissions. Si la source interne indispensable était absente, un changement de modèle ne suffit pas à démontrer une réponse fondée sur cette source.
Le diagnostic renvoie alors au travail décrit dans le corpus est le projet, sans conclure qu’un défaut documentaire serait la cause de toutes les erreurs.
Quels bénéfices faut-il vérifier lors d’un changement de génération ?
Les bénéfices à vérifier portent sur la qualité, les formats, le raisonnement, le coût et les cas limites, avec les mêmes contraintes que le système actuel.
- Un rapport qualité-prix potentiellement meilleur, qui peut permettre de descendre de palier après vérification. Voir quand le palier intermédiaire dépasse l’ancien haut.
- Une tenue des formats de sortie à tester, en contrôlant les erreurs de chaîne automatisée.
- Un raisonnement plus solide sur les tâches à contraintes multiples, si ces tâches font partie de l’usage réel.
- Une amélioration possible sur certains cas limites, qui sont pourtant ceux qui produisent les incidents.
Comment savoir si une mauvaise réponse vient du modèle ou du reste du système ?
Pour attribuer une mauvaise réponse, il faut examiner les documents disponibles, les extraits transmis, les consignes et les permissions avant de comparer le comportement des modèles. Le diagnostic se fait réponse par réponse, sans durée garantie.
La grille est simple. Pour chaque mauvaise réponse, on pose trois questions, dans l’ordre :
- Le bon document existe-t-il dans le corpus, à jour et sans doublon contradictoire ? Sinon, le défaut est dans le corpus.
- Le bon extrait figurait-il dans ce qui a été envoyé au modèle ? Sinon, le défaut est dans la récupération, souvent dans le découpage des documents.
- Le système avait-il le droit de répondre à cette question ? Sinon, le défaut est dans le périmètre.
Si ces trois points sont corrects, il reste à vérifier le prompt, le format et le traitement de la sortie. Le modèle devient un candidat à la correction, sans être nécessairement la seule cause. Cette grille s’applique d’autant mieux que le système affiche ses sources, comme le décrit un chatbot documentaire avec sources et garde-fous.
Que faire quand une nouvelle génération de modèle est annoncée ?
Quand une nouvelle génération de modèle est annoncée, il faut l’ajouter comme option, relancer le jeu de tests, comparer taux d’erreur et coût, puis décider avec des critères explicites et un effort adapté au risque. La première étape est une comparaison limitée.
Une incompatibilité ou un besoin réel peut justifier un chantier. L’annonce seule ne prouve pas son intérêt : il faut compter l’intégration, la recette et les contraintes contractuelles. Les chiffres de l’annonce elle-même se lisent avec précaution, comme l’explique comment lire une annonce de benchmark.
La décision qui suit la mesure est en général l’une des trois suivantes. Basculer, si le bénéfice mesuré et les contraintes le justifient. Descendre de palier, si le nouveau modèle intermédiaire égale l’ancien supérieur. Ou ne rien faire, si le gain ne justifie pas la revérification des réglages.
Cette troisième option reste une option légitime sur un système stable et bien réglé. Elle suppose un jeu de tests rejouable, que l’on peut construire en une journée.
Quel effet de bord une bascule vers un nouveau modèle provoque-t-elle ?
Une bascule peut modifier les réponses, les refus et l’usage des outils, ce qui oblige à revérifier les réglages et les contrats de sortie existants. C’est le coût caché d’une bascule, et il est réel.
Un système en production a été ajusté : le prompt tient compte des tendances du modèle, les seuils sont calés sur son comportement, les cas limites ont été traités un par un. Un nouveau modèle défait une partie de ces ajustements, souvent en mieux, parfois en moins bien.
Le symptôme typique : les réponses deviennent plus longues, ou le modèle refuse moins souvent, ou il reformule au lieu de citer. Un changement devient une régression s’il viole une exigence : longueur, citation fidèle, refus attendu ou format. Une variation de style peut donc avoir une conséquence fonctionnelle.
D’où l’intérêt du basculement par paliers avec surveillance du taux de correction humaine, approfondi dans la lecture complémentaire migrer un agent sans régression. Le même phénomène se produit d’ailleurs sans migration volontaire, quand le modèle change sans prévenir.
Quelle question poser avant de lancer une migration de modèle ?
Avant de lancer une migration, je demande quel problème observé elle doit résoudre, comment le bénéfice sera mesuré et quelles régressions doivent être évitées.
« Quel problème constaté cette bascule est-elle censée résoudre ? » Si la réponse est « on aura un meilleur modèle », ce n’est pas un problème constaté, et la bascule peut attendre le rendez-vous trimestriel.
Où porter l’effort plutôt que de changer de modèle ?
L’effort doit porter d’abord sur les défauts identifiés du corpus, de la récupération ou du périmètre, puis sur le modèle lorsque les tests le justifient. C’est le message que je répète le plus souvent en mission.
Sur le corpus : désigner la version qui fait autorité, retirer les documents périmés, porter les dates dans les métadonnées. Le résultat attendu est une référence identifiable, avec une règle pour les versions concurrentes.
Sur la récupération : vérifier que les bons documents remontent, ajuster le découpage, filtrer les droits avant la recherche. Quelques questions réelles amorcent le diagnostic ; les familles de cas et les droits doivent aussi être couverts.
Sur le périmètre : écrire ce que le système ne fait pas, et ce qu’il répond quand il ne sait pas. Voir le refus de répondre est une fonctionnalité.
Ces corrections restent utiles au-delà du modèle choisi, mais doivent être entretenues quand les documents ou les usages changent. Lorsqu’il est difficile de savoir par où commencer, un audit IA passe précisément ces couches en revue avant de parler de modèle.
Quelles erreurs fréquentes commet-on à chaque nouvelle génération de modèle ?
Les erreurs fréquentes à chaque nouvelle génération sont de migrer sur la foi de l’annonce, d’attendre le modèle suivant pour corriger le corpus, de comparer sans jeu de tests et d’oublier le coût de revérification. Elles reviennent à chaque sortie, quel que soit le fournisseur.
- Migrer parce que c’est nouveau. Sans problème constaté à résoudre, la bascule n’a pas d’objectif mesurable.
- Geler les chantiers en attendant. Le corpus et la récupération ne s’améliorent pas en attendant un modèle.
- Comparer à l’impression. Quelques essais réussis en démonstration ne disent rien du comportement sur les cas limites.
- Basculer d’un coup. Sans paliers ni surveillance, un changement de style passe pour une régression, ou l’inverse.
- Ignorer le coût. Une meilleure qualité à un coût supérieur n’est pas toujours un bon échange, surtout quand le prix de l’inférence baisse aussi sur les modèles existants.
Quelles questions trancher avant une migration vers GPT-5 ?
Faut-il migrer dès qu’une nouvelle génération comme GPT-5 sort ?
Non ; Il faut mesurer : ajouter le modèle comme option, relancer le jeu de tests, comparer taux d’erreur et coût. Ne rien faire est une décision légitime sur un système stable et bien réglé.
Une nouvelle génération corrige-t-elle les mauvaises réponses ?
Une nouvelle génération peut améliorer certaines réponses, mais elle ne met pas automatiquement à jour les sources internes ni les droits ; le diagnostic doit distinguer les causes de chaque erreur.
Quel est le coût caché d’une bascule de modèle ?
La revérification des réglages : le prompt, les seuils et le traitement des cas limites ont été calés sur le comportement du modèle précédent. Un nouveau modèle en défait une partie, et le style des réponses change.
Où porter l’effort plutôt que sur le modèle ?
L’effort doit suivre les défauts mesurés : documents, récupération, permissions ou consignes d’abord si ces éléments sont en cause, puis comparaison des modèles lorsque le besoin est établi.
Combien de temps faut-il pour évaluer un nouveau modèle ?
La durée dépend du jeu de tests, des interfaces et du risque : une comparaison initiale peut être limitée, tandis qu’une migration exige aussi recette, surveillance et retour arrière.
Quelles sont les couches d’un système d’IA en production ?
Pour un assistant documentaire, je distingue corpus, récupération, prompt, périmètre d’action et modèle ; cette grille sert au diagnostic et ne décrit pas toutes les architectures d’IA.