Qu’est-ce qu’un palier de modèle, et pourquoi la génération compte-t-elle ?
Un palier de modèle est l’un des niveaux de taille, de capacité et de prix qu’un fournisseur propose dans une même génération, du plus rapide et économique au plus capable et coûteux.
Chez Anthropic, la génération Claude 3, sortie en mars 2024, compte trois paliers : Haiku, Sonnet et Opus. Les autres fournisseurs suivent la même logique sous d’autres noms. Une organisation répartit alors ses tâches entre paliers : le plus économique pour le tri, l’intermédiaire pour la rédaction, le supérieur pour l’analyse difficile.
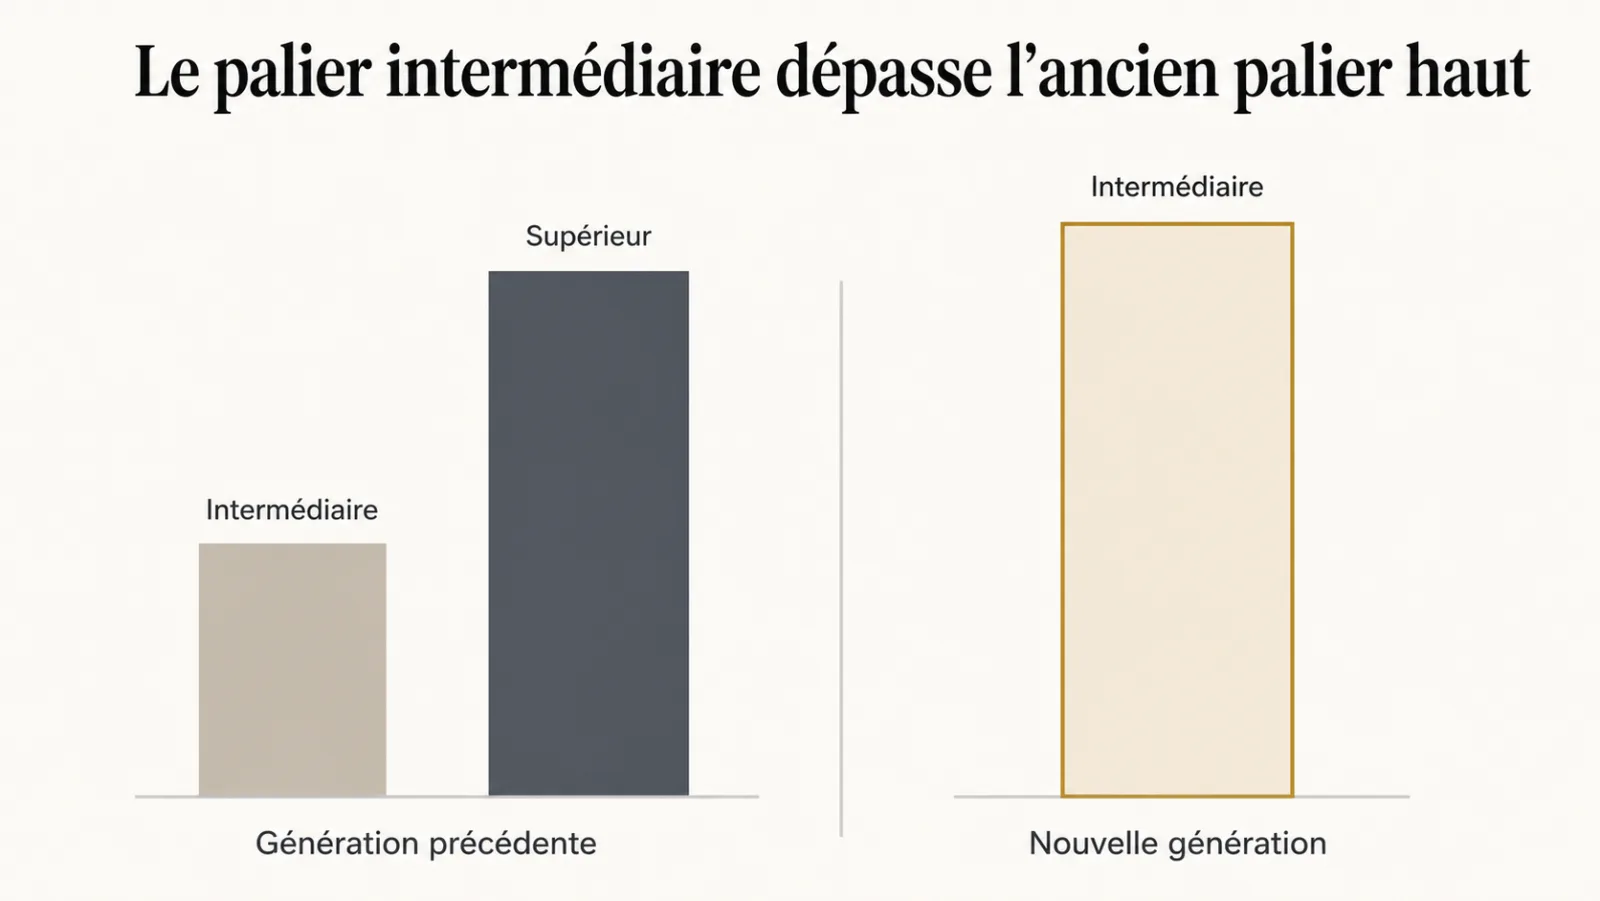
Le 20 juin 2024, Anthropic a publié Claude 3.5 Sonnet, premier modèle de la génération suivante, au tarif de l’ancien palier intermédiaire. C’est ce recouvrement entre générations, et non le modèle lui-même, qui fait l’objet de cet article.
Qu’est-ce que la nouvelle génération déplace ?
Claude 3.5 Sonnet annonce de meilleurs résultats que Claude 3 Opus sur plusieurs évaluations, avec le tarif du palier intermédiaire, ce qui justifie de rejouer la comparaison. Cette annonce du 20 juin 2024, également documentée par AWS ce jour-là, ne démontre pas une supériorité sur toutes les tâches.
Une affectation au palier supérieur peut continuer sans réexamen. Si le nouveau modèle satisfait les mêmes critères sur cette tâche, un écart de prix devient une économie possible. La qualité identique doit être démontrée, et pas déduite de l’annonce.
C’est le coût le plus discret d’un système d’IA en production : non pas une erreur, mais une décision correcte qui a cessé de l’être. Elle ne produit aucun incident, aucune plainte, aucune alerte : seulement une facture qui aurait pu être divisée.
| Modèle | Génération | Prix public par million de jetons (entrée / sortie) |
|---|---|---|
| Claude 3 Haiku | Claude 3 | 0,25 $ / 1,25 $ |
| Claude 3 Sonnet | Claude 3 | 3 $ / 15 $ |
| Claude 3 Opus | Claude 3 | 15 $ / 75 $ |
| Claude 3.5 Sonnet | Claude 3.5 | 3 $ / 15 $ |
Le tableau rend l’écart lisible : à capacités annoncées supérieures, le nouveau palier intermédiaire coûte le cinquième de l’ancien palier supérieur. La logique de choix par palier avait été posée au lancement de Claude 3 dans choisir le palier, pas le modèle.
Pourquoi personne ne reprend la décision de répartition ?
Rejouer la répartition demande un jeu de tests ; sans lui, la reprise devient un projet, et un projet ne se lance pas pour une économie qu’on ne sait pas chiffrer. C’est le vrai blocage, et il est organisationnel.
La séquence est toujours la même. Quelqu’un lit l’annonce, propose de tester, et se heurte à trois questions : tester sur quoi, comparer à quoi, décider selon quel critère. Faute de réponse, la proposition s’éteint.
Avec un jeu de tests, la reprise devient plus accessible : on change l’identifiant du modèle, on relance, on compare les taux d’erreur, on décide. Le coût d’entrée est celui du jeu de tests, construit une fois. C’est ce qui fait de l’évaluation continue un point d’appui pour reprendre des décisions avec les mêmes critères.
Comment organiser une reprise de répartition entre les modèles ?
Une reprise de répartition compare les paliers sur les tâches concernées, vérifie les erreurs critiques puis prépare une bascule réversible avec les éléments qui justifient la décision.
- Relancer le jeu de tests sur le nouveau palier intermédiaire, pour chaque type de tâche actuellement servi par le palier supérieur.
- Comparer au seuil d’erreur fixé pour cette tâche, pas au modèle précédent. Le critère est absolu, pas relatif.
- Basculer par paliers : une part limitée du trafic adaptée au risque, mesure des corrections puis élargissement. Voir migrer un agent sans régression.
- Consigner la décision avec sa date et ses chiffres, pour que la reprise suivante parte d’un état connu.
Comment décider, tâche par tâche, de basculer vers le nouveau palier ?
La décision de basculer une tâche vers le nouveau palier se prend sur trois critères mesurables : le respect du seuil d’erreur de la tâche, le comportement sur les cas limites, et l’effet sur la latence perçue.
- Lister les tâches servies par le palier supérieur. Pour chacune, noter le volume mensuel et le seuil d’erreur accepté.
- Rejouer le jeu de tests de chaque tâche sur le nouveau palier, sans modifier les consignes dans un premier temps.
- Lire séparément les résultats sur les cas limites. Un taux global identique peut cacher une dégradation sur les questions ambiguës.
- Vérifier la latence. Un palier plus rapide peut changer l’usage, comme l’a montré la latence devenue critère de conception.
- Basculer progressivement et consigner. Une part limitée choisie pour le système, puis élargissement avec les mesures et une possibilité de retour.
| Résultat de la comparaison | Décision |
|---|---|
| Seuil respecté, cas limites stables | Bascule progressive |
| Seuil respecté, cas limites dégradés | Bascule partielle, cas limites routés vers l’ancien palier |
| Seuil non respecté | Maintien, nouvelle comparaison à la revue suivante |
| Résultats instables d’une exécution à l’autre | Enrichir le jeu de tests avant de décider |
Pourquoi les cas limites résistent-ils aux nouvelles générations ?
Une amélioration moyenne dans une évaluation ne prouve pas que les cas limites de votre système sont corrigés, ce qui impose de les examiner séparément avant une bascule.
Une question ambiguë, un passage contradictoire ou une contrainte de format peuvent rester problématiques. Ils peuvent aussi s’améliorer ; seule une comparaison sur les mêmes cas permet de conclure.
Je distingue le jeu représentatif, qui décrit les demandes courantes, du jeu ciblé sur les erreurs critiques. Leur composition doit correspondre au service, sans imposer une proportion universelle de cas difficiles.
Un exemple générique : un résumé plus fluide peut omettre une réserve contractuelle que l’ancien modèle conservait. La préférence rédactionnelle ne doit pas compenser cette régression. Il faut définir ce qui bloque la bascule et conserver la sortie qui révèle le problème.
Quand faut-il reprendre la comparaison des paliers ?
La comparaison des paliers doit être reprise lors d’un changement pertinent de modèle, de tâche ou de coût, avec une revue programmée adaptée au rythme d’exploitation.
Je recommande de prévoir ce rendez-vous et un responsable plutôt que de compter sur la lecture occasionnelle d’une annonce. La revue peut conclure au maintien : elle n’a pas besoin de produire une migration pour être utile.
Qu’est-ce que ce rythme change dans la relation au fournisseur ?
L’arrivée d’une nouvelle génération rappelle que le choix d’un modèle doit être réexaminable, avec une intégration qui permet de comparer des variantes sans reconstruire tout le système. La séparation des responsabilités facilite cette reprise.
Une équipe qui a codé contre un modèle particulier subit chaque génération comme une perturbation. Une équipe qui a isolé l’appel peut comparer une variante sans reprendre toute l’application. Il reste un travail de recette, de compatibilité et de surveillance.
Ce cadre est développé dans la couche qui rend le modèle remplaçable, et il devient d’autant plus rentable que le rythme s’accélère. Il protège aussi contre l’inverse : un modèle qui évolue sans annonce, situation décrite dans le jour où le modèle a changé sans prévenir.
Quelles erreurs commettent les équipes à chaque nouvelle génération ?
Les erreurs les plus fréquentes face à une nouvelle génération de modèles consistent soit à ne rien reprendre, soit à tout basculer sur la foi d’une annonce, sans mesure sur ses propres tâches.
- Croire le classement public sur parole. Les bancs d’essai mesurent des tâches génériques ; seul le jeu de tests de l’organisation mesure les siennes.
- Basculer d’un bloc. Sans trafic partiel, une régression sur une catégorie de questions se découvre par les plaintes.
- Changer modèle et consignes en même temps. On ne sait plus ce qui a produit l’amélioration ou la dégradation.
- Ne jamais redescendre. On pense à monter de palier quand la qualité manque, rarement à redescendre quand un palier inférieur suffit.
- Oublier de dater la décision. Sans date, personne ne sait quand la répartition a été vérifiée pour la dernière fois.
Ces erreurs se retrouvent parmi les verrous décrits dans sortir du prototype. Un audit IA commence souvent par cette question simple : quelle tâche est servie par quel palier, et depuis quand.
Quel signal doit alerter sur une répartition dépassée ?
Une répartition sans justification datée ni comparaison récente signale un arbitrage à examiner, tandis qu’une facture stable ne suffit pas à démontrer une économie manquée.
Le trafic, la longueur des réponses et les tarifs peuvent produire la même facture avec des comportements très différents. Je regarde les tâches, les paliers appelés, les volumes et les corrections.
La question de revue devient : sur quelle preuve chaque affectation repose-t-elle encore ? Une décision peut rester correcte longtemps. Une autre peut perdre son intérêt après un changement de tâche ou de catalogue.
Le jour où un modèle change rappelle aussi l’importance des versions identifiées. Pour déclencher une reprise, mieux vaut un changement documenté ou un défaut mesuré qu’un diagnostic automatique tiré de la facture.
Quelles questions fréquentes se poser avant une bascule de palier ?
Faut-il changer de modèle à chaque nouvelle génération ?
Pas systématiquement, mais il faut rejouer la comparaison; Le palier intermédiaire d’une nouvelle génération dépasse souvent le palier supérieur de la précédente, ce qui divise le coût à qualité constante.
Claude 3.5 Sonnet est-il meilleur que Claude 3 Opus ?
Les annonces de lancement décrivent de meilleurs résultats de Claude 3.5 Sonnet sur plusieurs évaluations, sans établir sa supériorité sur chaque tâche de votre système ou corpus. Une comparaison interne reste nécessaire.
Comment savoir si une bascule est sans risque ?
Une bascule se prépare en comparant les critères métier et les cas critiques, puis en limitant le déploiement avec une surveillance et une possibilité de retour. Aucun jeu limité ne prouve un risque nul.
Pourquoi les cas limites résistent-ils aux nouvelles générations ?
Les scores moyens ne décrivent pas chaque ambiguïté ni chaque contrainte de votre processus, ce qui demande une lecture séparée des cas critiques et des erreurs observées. Certains peuvent progresser et d’autres régresser.
À quelle fréquence reprendre la répartition ?
La fréquence de reprise doit suivre les changements pertinents de modèle et d’usage, avec un rendez-vous planifié pour éviter les décisions sans justification durablement conservées. Elle dépend de l’exploitation.
Comment éviter de dépendre d’un modèle précis ?
En isolant l’appel au modèle derrière une couche d’abstraction, pour que changer de modèle revienne à changer un identifiant; Combinée à un jeu de tests, cette couche transforme chaque nouvelle génération en amélioration plutôt qu’en perturbation.