Qu’est-ce qu’Amazon Bedrock et pourquoi est-ce un choix d’architecture ?
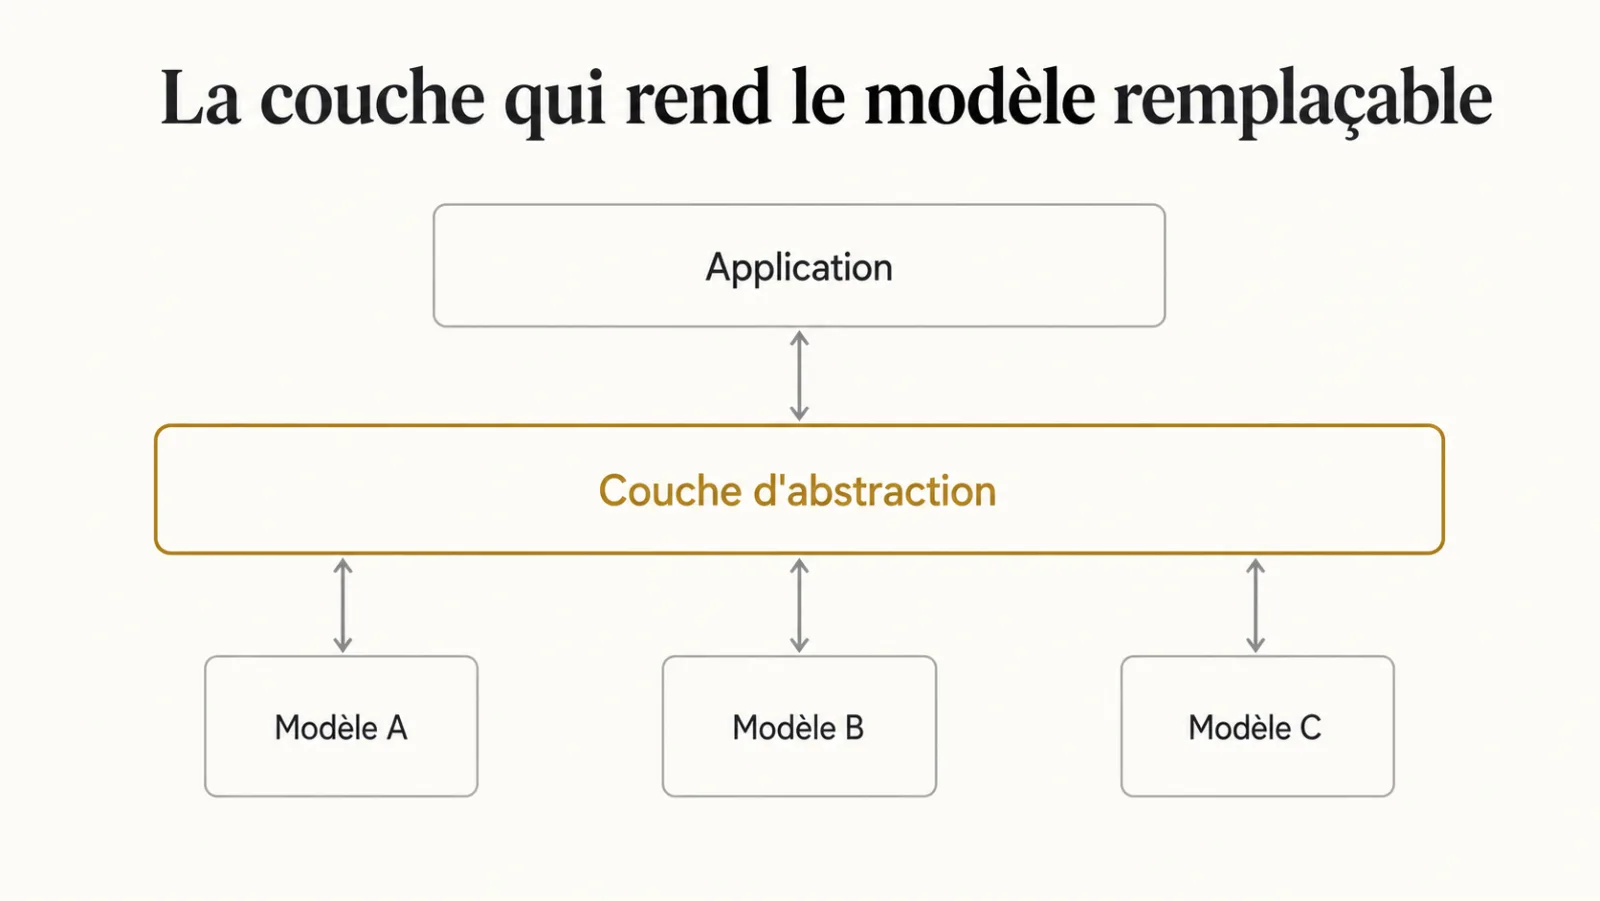
Amazon Bedrock, annoncé par AWS le 13 avril 2023 en préversion limitée, donne accès à plusieurs modèles de fondation derrière une seule interface, et suggère une architecture : isoler les appels au modèle dans une couche dédiée. Présenté comme un catalogue, c’est d’abord une couche d’abstraction.
Le catalogue annoncé réunit les modèles Jurassic-2 d’AI21 Labs, Claude d’Anthropic, Stable Diffusion de Stability AI et la famille Titan d’Amazon. Le service n’est ouvert qu’à un nombre restreint de clients, et ses conditions définitives ne sont pas encore connues. L’intérêt de l’annonce est ailleurs : elle rend visible une idée que beaucoup d’équipes n’ont pas encore appliquée.
Une couche d’abstraction, dans ce contexte, est le module unique par lequel passent tous les appels à un modèle de langage. Le reste de l’application lui adresse une demande dans un format stable, et c’est elle seule qui sait quel fournisseur appeler, comment formuler l’appel et comment interpréter la réponse.
L’intérêt n’est pas conceptuel, il est comptable. Ce qui coûte cher n’est pas le remplacement d’un modèle : c’est la réécriture qu’il impose quand rien ne l’a anticipé.
Pourquoi faut-il pouvoir remplacer son modèle ?
Isoler les appels facilite le remplacement d’un modèle lorsque les besoins, les conditions du fournisseur ou les résultats changent, sans supposer que tous les modèles sont interchangeables. La réversibilité doit se préparer avant d’en avoir besoin.
Le début de 2023 montre déjà plusieurs possibilités : l’API de ChatGPT est annoncée le 1er mars, puis GPT-4 le 14 mars. Cela ne donne ni une fréquence universelle de migration ni une durée de maintien garantie. Le bon critère est votre jeu de tests, avec le coût et les conditions d’usage.
Dans les systèmes que je reprends, disperser le nom du modèle et ses formats de réponse multiplie les endroits à modifier. Centraliser ces dépendances réduit le travail mécanique ; la qualification métier reste nécessaire.
Le fournisseur engage aussi ce qu’on lui transmet. Cette question sera développée dans ce qu’on a le droit de mettre dans un prompt, conservé ici comme lecture complémentaire.
Que doit isoler une couche d’abstraction entre l’application et le modèle ?
Une couche d’abstraction doit masquer trois choses, le format d’appel, le format de réponse et le comportement en erreur, et je lui ajoute systématiquement une quatrième : la comptabilisation des jetons et du coût. C’est moins évident qu’il n’y paraît, parce que les comportements d’échec doivent être testés en plus des formats documentés.
Un fournisseur renvoie une erreur structurée, un autre une réponse vide, un troisième un texte d’excuse en langue naturelle qui ressemble à une réponse valide. Une couche qui ne distingue pas ces cas peut laisser passer les différences : dans le traitement automatique de la sortie, où une réponse vide traitée comme un succès produit une donnée fausse.
La comptabilisation est le quatrième élément. Le nombre de jetons consommés et le coût par appel doivent être mesurés au même endroit, quel que soit le fournisseur. Sans cela, personne ne sait ce que coûte réellement une fonctionnalité, et l’arbitrage décrit dans le coût réel d’un système IA en production devient impossible à instruire.
| Élément isolé | Ce qui varie d’un fournisseur à l’autre | Ce que la couche garantit |
|---|---|---|
| Format d’appel | Structure des messages, noms des paramètres, limites de longueur | Une seule forme de demande pour toute l’application |
| Format de réponse | Emplacement du texte, métadonnées, motif d’arrêt | Une réponse au même format, quel que soit le modèle |
| Comportement en erreur | Erreur structurée, réponse vide, texte d’excuse | Une erreur explicite, jamais un faux succès |
| Comptabilisation | Mode de comptage des jetons, tarifs | Jetons et coût journalisés au même endroit |
Quels usages la réversibilité permet-elle de tester ?
La réversibilité permet de comparer des modèles, de router certaines tâches et de préparer une migration, à condition que les décisions reposent sur une recette commune et traçable.
- Comparer les sorties sur les mêmes cas, avec des consignes adaptées lorsque les interfaces diffèrent. L’évaluation continue constitue une lecture complémentaire sur cette discipline.
- Router par tâche, si un modèle moins coûteux réussit les cas concernés. Comptez aussi les erreurs et les reprises.
- Basculer progressivement, selon un palier choisi pour le risque de l’usage, puis vérifier les corrections humaines. Voir en complément migrer sans régression.
- Préparer le retrait d’une version, en conservant un adaptateur et une solution de repli testés. Une ligne de configuration ne remplace pas la validation.
Comment construire une première couche d’abstraction ?
Une première couche d’abstraction doit appeler le fournisseur, normaliser les sorties, qualifier les échecs et compter les usages, avec un périmètre limité aux besoins effectivement testés. La sobriété du premier jet est ce qui la rend maintenable.
- Définir le format interne d’une demande : la consigne, le contenu, la longueur maximale de réponse et l’identifiant de la fonctionnalité appelante.
- Écrire un adaptateur par fournisseur, qui traduit ce format vers l’appel propre au fournisseur, et rien d’autre.
- Normaliser la réponse vers un format unique : le texte produit, le motif d’arrêt, les compteurs disponibles, sans inventer une ventilation que le fournisseur ne publie pas.
- Qualifier chaque résultat, en distinguant erreur technique, sortie vide, refus et succès métier ; un refus peut être le comportement attendu.
- Journaliser chaque appel avec le modèle, les compteurs, le tarif daté, le coût estimé et la fonctionnalité. Indiquez si une donnée manque.
- Placer le nom du modèle dans la configuration, jamais dans le code applicatif.
Une fois en place, cette couche devient aussi le point naturel où brancher les contrôles futurs : un plafond de jetons, un filtre sur ce qui sort de l’organisation, ou la vérification qu’un modèle n’exécute pas d’action non prévue, question que les plugins de ChatGPT rendent déjà concrète.
Quel est le piège d’une abstraction trop ambitieuse ?
Une couche d’abstraction qui prétend masquer toutes les différences entre modèles finit par empêcher d’utiliser ce que chacun a de mieux, et c’est l’erreur symétrique de l’absence de couche. Je l’ai vue coûter cher.
Certaines capacités ne sont pas portables : une fenêtre de contexte plus longue chez un fournisseur, un rôle système dédié chez un autre, des paramètres de génération propres, la possibilité de personnaliser un modèle sur ses données, ou la génération d’images que seuls certains modèles du catalogue proposent. Vouloir les uniformiser produit un plus petit dénominateur commun médiocre, où l’on paie le prix d’un grand modèle pour n’en utiliser qu’une fraction.
La bonne mesure : la couche normalise l’appel, la réponse, l’erreur et le coût. Elle laisse passer les capacités spécifiques par une porte explicite, utilisée en connaissance de cause, et couverte par le jeu de tests. Ce qui compte est que le recours à une capacité non portable soit visible dans le code, pas dissimulé au fond d’une fonction utilitaire.
La taille de la fenêtre illustre bien ce point : une application qui suppose huit mille jetons disponibles doit savoir ce qu’elle fait quand le modèle de remplacement en accepte moins, ou davantage. Les conséquences de cette limite sont détaillées dans la fenêtre de 8 000 jetons de GPT-4.
Quand faut-il prévoir la couche d’abstraction ?
Je recommande de prévoir la couche dès le cadrage pour rendre les dépendances visibles, puis d’estimer son effort selon les fournisseurs, les formats et la recette nécessaires. Une formation à l’IA peut aider l’équipe à distinguer remplacement technique et validation de l’usage.
Comment choisir entre une plateforme multi-modèles et une couche maison ?
Une plateforme multi-modèles comme Bedrock et une couche d’abstraction maison ne répondent pas au même risque : la première simplifie l’accès à un catalogue, la seconde rend explicites les dépendances, y compris envers la plateforme. Les deux peuvent se combiner.
Un point d’accès commun ne couvre que le catalogue annoncé, ni tous les fournisseurs ni toutes les capacités. GPT-4, par exemple, ne figure pas parmi les modèles annoncés dans Bedrock.
| Approche | Ce qu’elle apporte | Ce qu’elle ne règle pas |
|---|---|---|
| Appel direct au SDK d’un fournisseur | Rapidité de démarrage | Dépendances à identifier avant une migration |
| Plateforme multi-modèles | Un seul point d’accès, un cadre contractuel cloud déjà connu | Dépendance à la plateforme et à son catalogue |
| Couche maison | Dépendances isolées, comptabilisation centralisée | Adaptateurs à maintenir soi-même |
| Couche maison au-dessus d’une plateforme | Accès commun et adaptateurs explicites | Un niveau d’indirection de plus à tester |
Le point important n’est pas le choix entre ces options, c’est qu’une couche existe. Dans un audit de système d’IA, je vérifie où sont déclarés le modèle, ses paramètres et ses formats.
Que change la couche d’abstraction pour l’hébergement interne ?
Une couche d’abstraction facilite l’étude d’un passage entre API et hébergement interne, mais elle ne supprime ni les différences de capacités ni le travail d’exploitation et de validation. On peut commencer par une API pour établir la valeur d’usage, mesurer le volume sur une période représentative, puis rejouer le calcul avec des chiffres constatés au lieu d’hypothèses.
C’est une séquence que je recommande pour instruire deux risques : investir dans du matériel pour un usage qui ne décollera pas, et rester sur une facturation à l’usage qui devient déraisonnable quand il décolle. La discussion pourra être prolongée par cette lecture complémentaire, modèles ouverts et souveraineté.
Dans les deux cas, le déclencheur du basculement doit être écrit à l’avance : au-delà de tel volume mensuel, on rejoue l’arbitrage. Sans ce seuil posé au départ, la question ne se repose jamais, et l’organisation risque de payer pendant longtemps un tarif qui n’était justifié qu’au démarrage.
Quelles questions vérifier avant de choisir cette architecture ?
Faut-il passer par une plateforme comme Bedrock ou écrire sa propre couche ?
Une plateforme simplifie l’accès à son catalogue ; une couche dédiée isole les appels et les différences nécessaires. Elles peuvent se combiner. Le choix dépend des fournisseurs visés, de la recette et des contraintes contractuelles.
Quels modèles Amazon Bedrock propose-t-il à son lancement ?
L’annonce du 13 avril 2023 cite les modèles Jurassic-2 d’AI21 Labs, Claude d’Anthropic, Stable Diffusion de Stability AI et la famille Titan d’Amazon. Le service est en préversion limitée, réservée à un nombre restreint de clients. Le catalogue et les conditions définitives restent à confirmer.
L’abstraction fait-elle perdre en performance ?
Elle peut modifier la qualité si elle reformule mal les messages, tronque un contexte ou interprète incorrectement une sortie. Testez les adaptateurs et gardez visibles les capacités spécifiques nécessaires, avec leur coût et leurs limites.
À quelle fréquence change-t-on de modèle en pratique ?
Il n’existe pas de fréquence universelle. Un changement se justifie par des résultats, des conditions d’usage ou la disponibilité du service. Préparez le remplacement, mais ne migrez pas seulement parce qu’une annonce apparaît.
Peut-on mélanger plusieurs fournisseurs en production ?
Oui, si les conditions d’usage, la protection des données et la recette le permettent. Le routage doit être évalué par tâche, avec les erreurs et les reprises ; plusieurs fournisseurs ne garantissent pas une économie.
Combien de temps faut-il pour écrire une couche d’abstraction ?
La durée dépend des interfaces, des formats de sortie et des contrôles à maintenir. Estimez une première version limitée, puis testez chaque adaptateur. Un délai fixe annoncé sans connaître ce périmètre n’est pas défendable.