Une migration de modèle réussie conserve le contrat de sortie du système et permet de revenir à la version précédente. Une réponse convaincante dans une démonstration ne suffit pas : le nouveau modèle peut modifier le format, utiliser un outil différemment ou répondre dans un cas où l'application attendait un refus.
Sonnet 5.5, annoncé le 28 septembre 2026, fournit un cas concret pour construire cette recette. L'objectif de cet article est technique : isoler ce qui change, comparer les sorties et décider avec des preuves. Le protocole proposé n'est pas un compte rendu de tests réalisés sur Sonnet 5.5.
Quelle hypothèse faut-il tester ?
L'hypothèse doit porter sur une tâche définie, avec une qualité et un coût mesurables. Anthropic présente Sonnet 5.5 comme plus rapide et moins coûteux par tâche que Sonnet 5 dans ses évaluations, tout en conservant les mêmes tarifs unitaires. Ce positionnement donne une raison de tester ; il ne donne pas le résultat de votre migration. Annonce officielle.
Écrivez par exemple : « Le nouveau modèle prépare une synthèse conforme sans augmenter les reprises manuelles. » Cette phrase se vérifie. « Il est plus intelligent » ne fournit aucun seuil de décision. Le jeu de tests métier doit traduire l'hypothèse en cas acceptables et en défauts bloquants.
Comment figer le système de référence ?
La référence doit inclure le prompt, les outils, le corpus, les paramètres et les règles de validation. Changer le modèle et améliorer en même temps le prompt empêche d'attribuer une différence. Conservez une configuration datée, une empreinte des ressources et les entrées utilisées pour chaque essai.
Le corpus documentaire peut bouger pendant la migration. Pour le test, préparez une copie contrôlée ou un identifiant de version. Les permissions doivent également être représentées : deux utilisateurs ne doivent pas voir les mêmes documents par commodité expérimentale. Le protocole sur les droits d'accès d'un RAG traite cette frontière.
Consignez les défauts déjà connus de l'ancien système. Une erreur présente dans les deux versions demeure un défaut, mais ce n'est pas une régression. Une amélioration sur un groupe de cas ne doit pas effacer une dégradation sur une tâche critique. Le rapport final conserve les résultats par famille.
Quels cas doivent entrer dans la recette ?
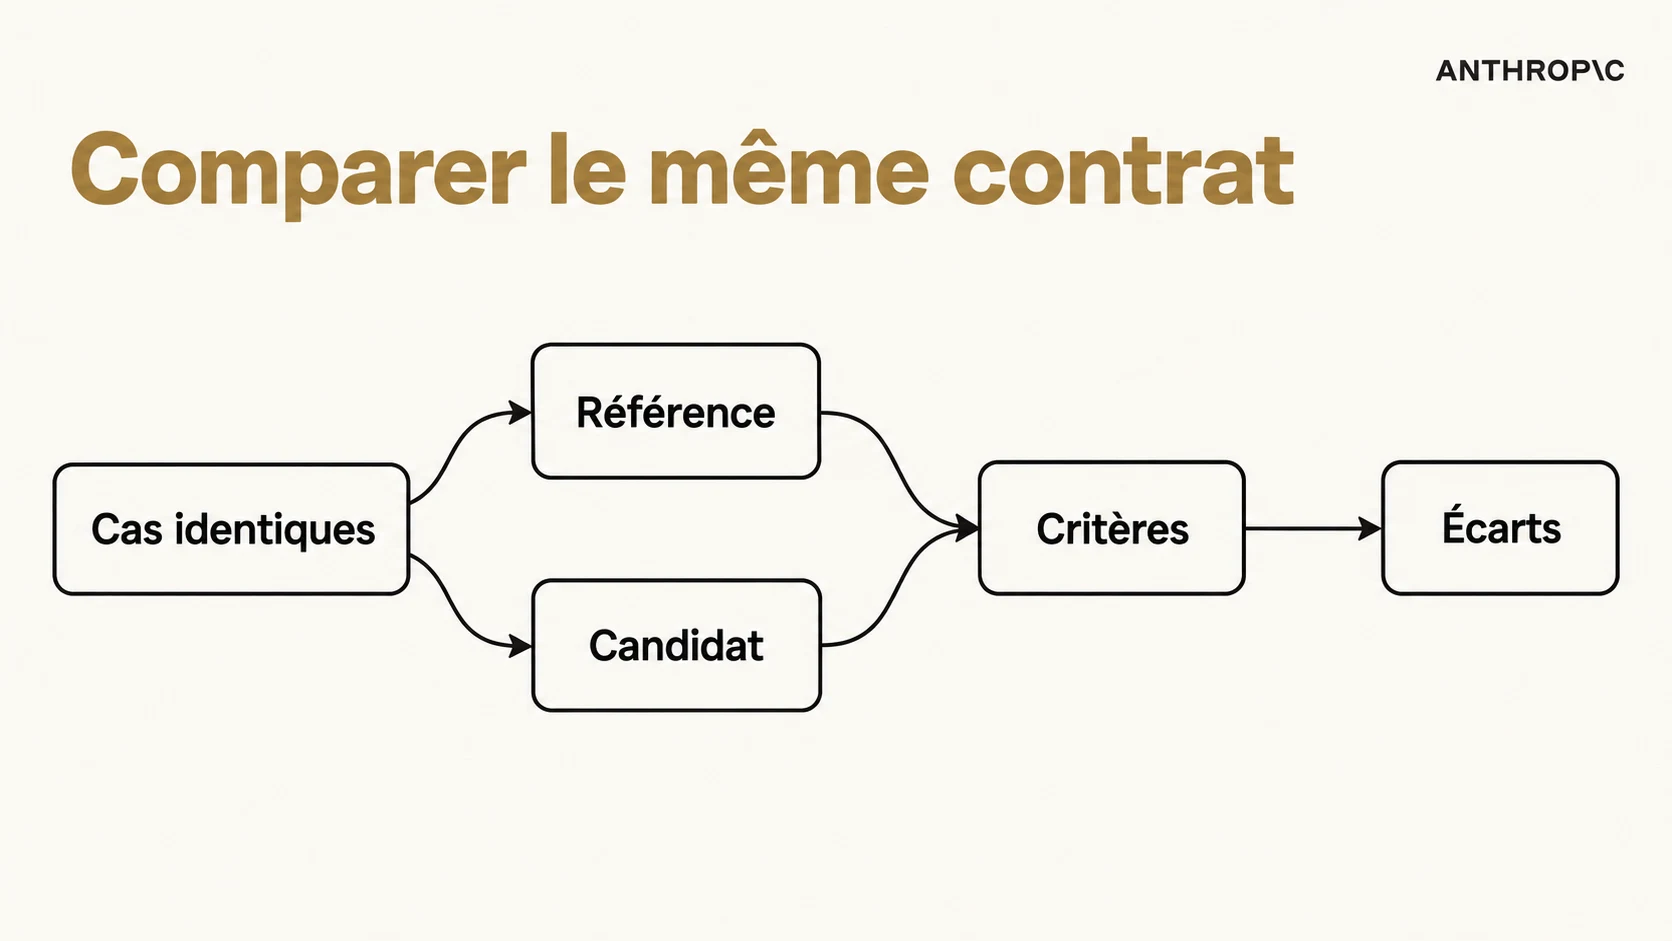
La recette doit couvrir les contrats que l'application promet réellement de respecter. Incluez les réponses ordinaires, les entrées incomplètes, les documents contradictoires, les demandes interdites et les erreurs d'outils. Il faut également des cas où le système doit s'arrêter plutôt qu'inventer.
Pour chaque entrée, définissez ce qui doit être présent, ce qui peut varier et ce qui ne doit jamais arriver. Un résumé peut changer de formulation tout en restant correct. Un montant, une unité ou une identité autorisée ne peut pas varier librement. La validation doit respecter cette différence.
Anthropic recommande des critères spécifiques et mesurables avant la construction des évaluations. Documentation des évaluations. À cette base, ajoutez une grille propre à votre application : exactitude, références utilisables, schéma de sortie, choix d'outil, autorisation et délai. Évitez une note globale qui compense un accès indu par une meilleure rédaction.
Comment tester les actions sans les exécuter ?
Les actions doivent d'abord être évaluées dans un environnement où leurs effets sont simulés. Le modèle propose un appel ; le dispositif de test enregistre la commande et retourne un résultat maîtrisé. Une demande de suppression ou de publication ne touche ainsi aucun compte réel.
La documentation Claude Code expose des permissions fines pour contrôler les opérations autorisées. Permissions. Le test doit vérifier la politique effectivement configurée, pas seulement constater que le produit propose cette fonctionnalité. Une permission large dans le banc d'essai peut masquer le défaut qui apparaîtra en production.
Ajoutez des résultats d'outils difficiles : délai dépassé, réponse vide, résultat contradictoire et action déjà exécutée. Vérifiez si le candidat recommence une action ou passe la main. La recette d'injection indirecte apporte des cas où un document essaie de commander l'agent.
Comment comparer les coûts sans tromper le décideur ?
Le coût doit être rapporté au résultat accepté et à la distribution des échecs. Enregistrez les jetons, les outils, les tentatives supplémentaires et le temps de revue. Une moyenne isolée ne dit pas combien coûtent les cas qui dépassent le délai utile.
Distinguez le coût fournisseur du coût de traitement. Un test peut montrer une baisse de dépense API sans permettre de conclure sur la charge humaine. Publiez le détail des cas repris et la raison de chaque reprise. Dans un exemple fictif, un résumé rapide omet une clause ; son économie de jetons ne compense pas automatiquement la vérification supplémentaire.
Le niveau d'effort doit être consigné. Un candidat évalué avec un raisonnement plus long et une référence réglée pour aller vite ne mesure pas uniquement le changement de modèle. La décision doit mentionner la configuration retenue et les alternatives qui ont été comparées.
Quel critère autorise la bascule ?
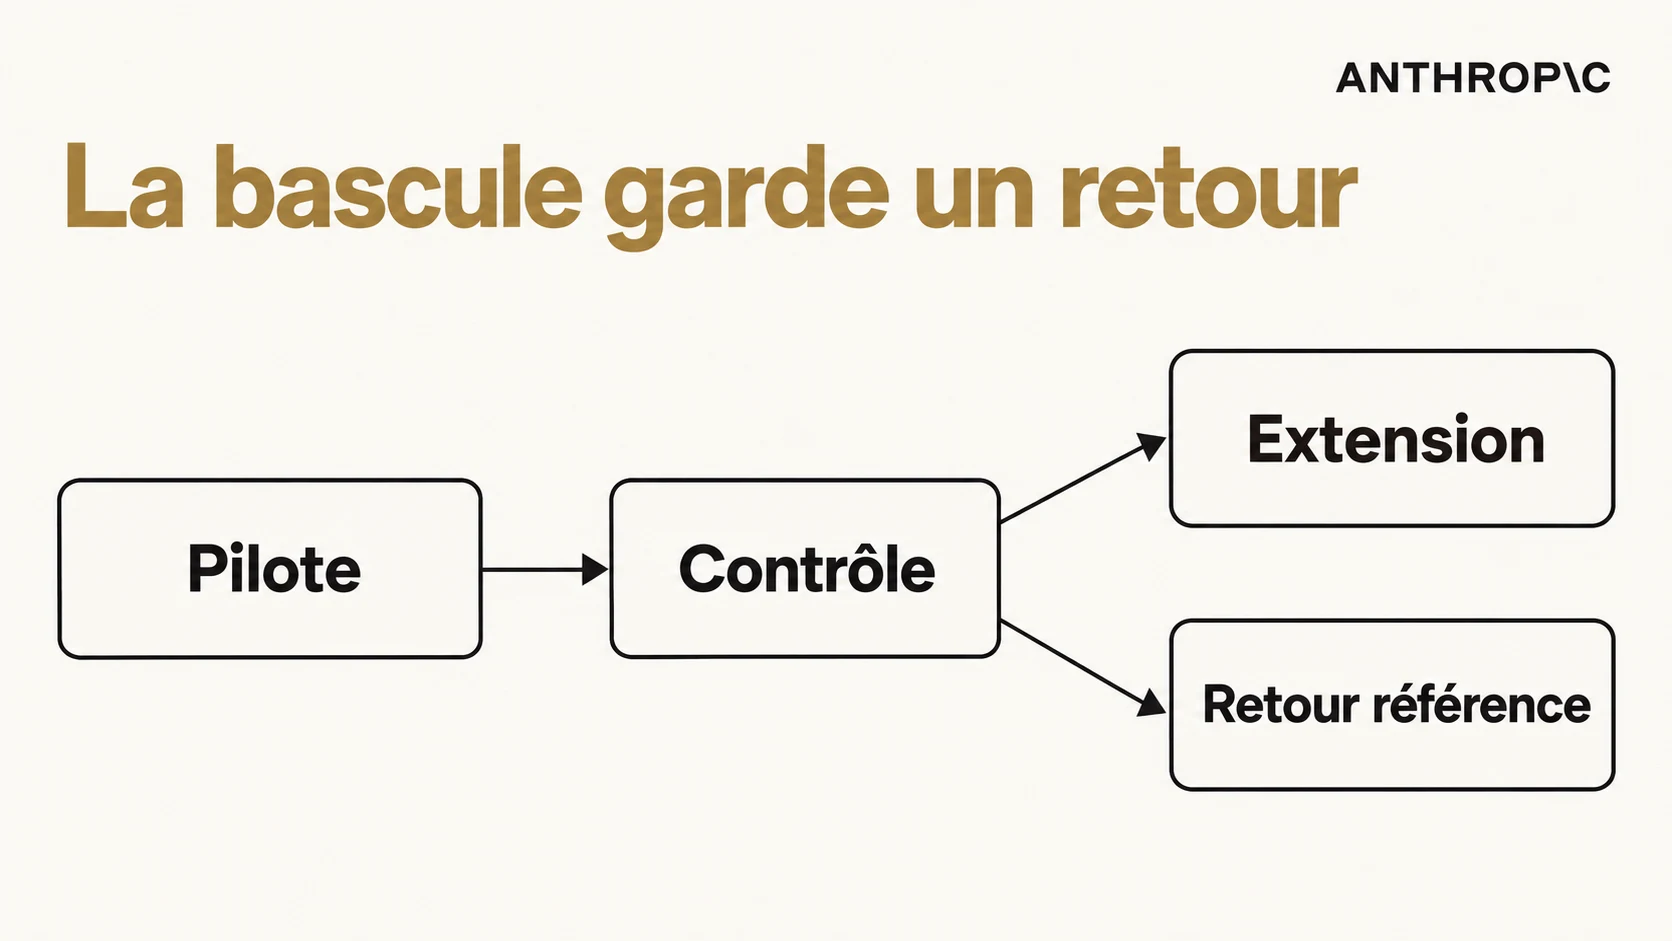
La bascule nécessite des critères écrits avant l'examen des résultats. Le responsable métier choisit les défauts bloquants et le niveau de qualité utile ; l'équipe technique vérifie que le système peut revenir en arrière. Aucune valeur universelle ne remplace cette décision.
Commencez par un mode parallèle sans effet externe, puis par un périmètre réduit. Vérifiez la cohérence des logs, le traitement des demandes hors périmètre et le comportement des outils. Le retour à la référence doit être essayé, pas seulement décrit dans une procédure.
Conservez le rapport de comparaison avec ses limites : date, corpus, critères, paramètres et cas exclus. Une recette valide sur une extraction documentaire ne démontre pas la sûreté d'un agent autonome. Un audit IA peut préciser les contrats à vérifier avant d'élargir le périmètre.
Questions fréquentes
Faut-il comparer les réponses mot à mot ?
Une comparaison exacte convient aux formats rigides, aux codes et à certains champs. Pour une synthèse, elle rejetterait des formulations différentes mais correctes. Le test doit porter sur les faits, les références et les contraintes attendues. Les variations de style restent séparées des erreurs métier.
Un meilleur benchmark autorise-t-il la migration ?
Un benchmark public renseigne sur un protocole et un ensemble de tâches. Il ne contient pas vos permissions, vos outils ni vos cas limites. Il peut justifier une évaluation, mais la bascule dépend des résultats obtenus sur le contrat de votre application et de leur revue.
Peut-on garder l'ancien prompt ?
Garder le prompt constitue une première comparaison utile, car le modèle devient la variable principale. Une seconde campagne peut ensuite tester une adaptation du prompt. Les deux résultats doivent rester distincts afin de comprendre ce qui apporte le gain et ce qui crée une régression.
Que livrer au terme de la recette ?
Le livrable final doit contenir les cas, les résultats, les anomalies et la décision de bascule. Les mêmes éléments serviront à la prochaine migration. Pour l'affectation économique des tâches entre modèles, l'analyse Sonnet 5.5 côté Noolya complète ce protocole.