Qu’est-ce que l’écart entre démonstration et production en IA générative ?
L’écart entre démonstration et production désigne la différence de comportement d’un système d’IA générative entre les exemples choisis pour le montrer et les cas réels qu’il reçoit une fois en service. Une démonstration illustre une capacité ; elle ne constitue pas une recette du service.
Le corpus réel apporte des contrats mal scannés, des procédures contradictoires et des tableaux incomplets. GPT-4 peut répondre avec assurance sur ces bases incertaines. OpenAI indique dès son annonce de mars 2023 que le modèle demeure sujet aux hallucinations et doit être utilisé avec des contrôles adaptés.
Je regarde donc le modèle et les conditions dans lesquelles il reçoit l’information. Les quatre écarts examinés ici concernent données, définition du succès, intégration et entretien.
Pourquoi les données de démonstration trompent-elles autant ?
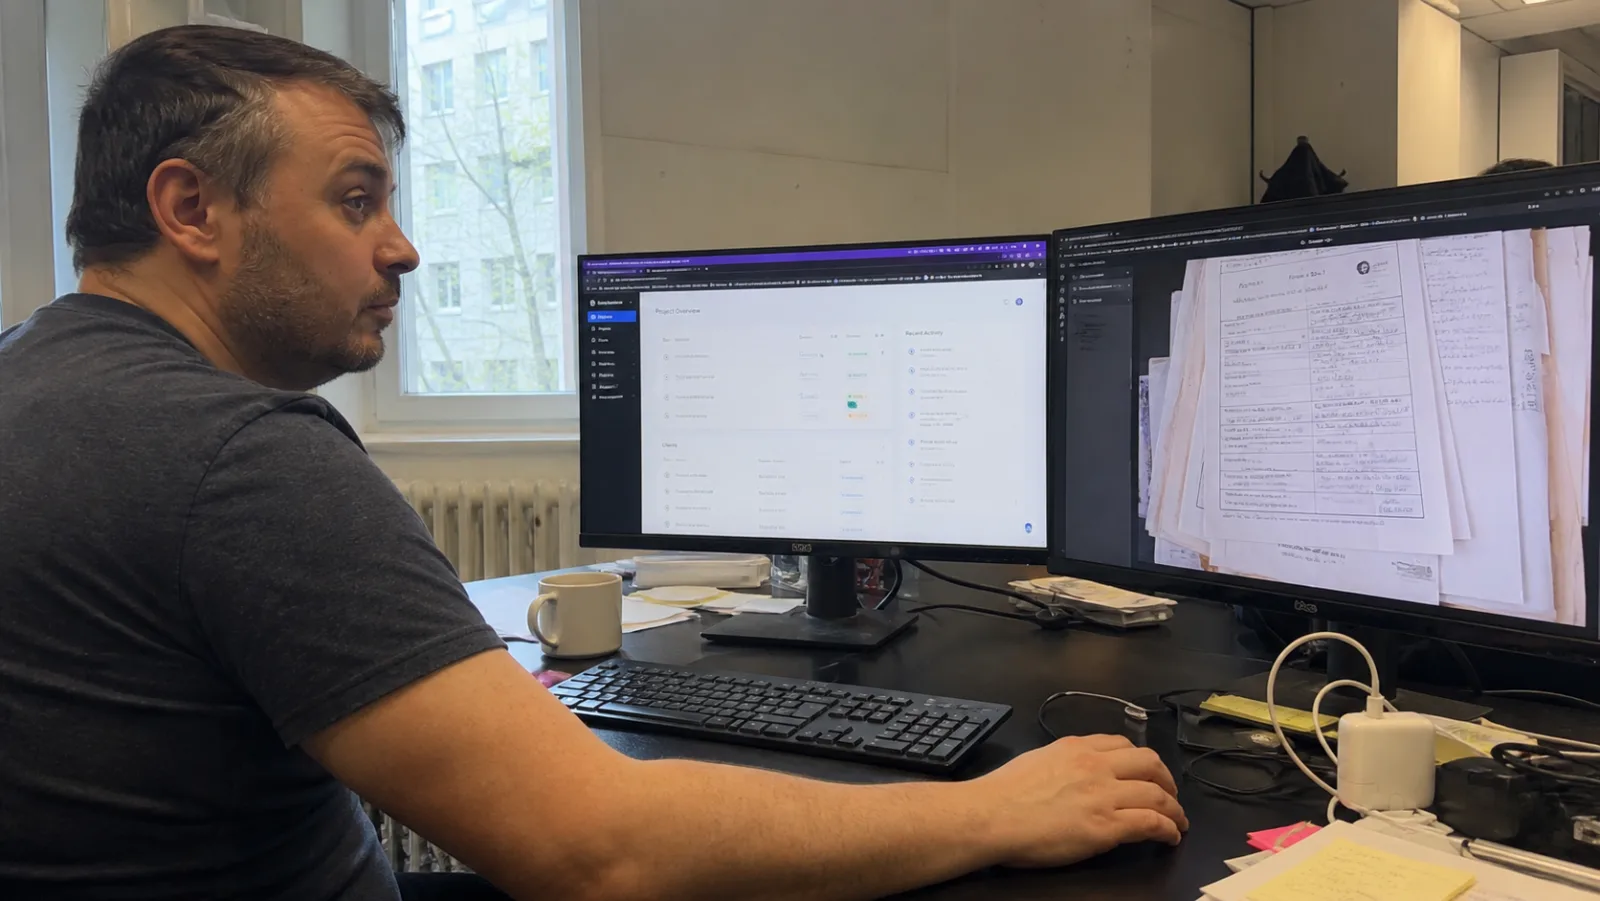
Les données de démonstration peuvent tromper lorsqu’elles sont homogènes et choisies pour réussir, alors que le corpus de production mélange formats, versions, niveaux d’autorité et questions incomplètes. Ce décalage mérite d’être testé avant de changer le prompt.
Dans un exemple fictif, une direction des achats teste dix contrats récents en PDF natif. Le service réel reçoit aussi des avenants scannés et des annexes en tableur. Il peut retrouver une version périmée ou perdre l’information nécessaire lors du découpage.
Un document difficile ne constitue pas une raison de le retirer du test s’il fait partie du travail prévu. La fenêtre de 8 000 jetons de GPT-4 impose déjà de sélectionner les passages transmis et de vérifier que cette sélection ne supprime pas une réserve essentielle.
Que vérifier dans le corpus avant d’écrire la première ligne ?
Avant le premier développement, je vérifie l’autorité des documents, leurs formats, leurs mises à jour, les droits d’accès et le coût métier d’une erreur.
- L’âge du document le plus ancien qui sera indexé, et s’il fait encore autorité.
- Le nombre de formats réellement présents, y compris les images de texte scannées.
- Qui met à jour, à quelle fréquence, et ce qui se passe quand personne ne le fait.
- Les droits d’accès : si un document est réservé à trois personnes, la réponse qui le cite doit l’être aussi.
- Le coût d’une erreur, exprimé par le métier et non par la technique.
Comment définir le succès d’un projet d’IA générative avant de commencer ?
Le succès d’un projet d’IA générative se définit avant le premier développement, par un critère mesurable sur des cas réels et par le nom de la personne métier qui juge une bonne réponse. Sans ce critère, c’est le deuxième écart : personne ne sait quand le projet a réussi.
Je demande systématiquement, avant de commencer : à quoi ressemble une bonne réponse, et qui en juge.
Si la réponse est « on verra bien », le projet n’a pas de critère d’arrêt. L’absence de critère empêche de décider si le prototype répond au besoin ou doit être arrêté.
Dans un exemple fictif, un critère pourrait être formulé ainsi : sur trente dossiers représentatifs, un juriste senior valide la réponse sans correction dans au moins vingt cas, et les dix autres sont corrigibles en moins de deux minutes. Ce n’est pas élégant, mais c’est mesurable, et surtout, c’est vérifiable à chaque changement de modèle.
Un bon critère réunit trois éléments : un échantillon tiré de la production et non choisi, un juge identifié qui connaît le métier, et un seuil chiffré fixé avant de voir les résultats. S’il en manque un, le critère redevient une impression.
Pourquoi l’ajustement du prompt ne suffit-il pas à corriger un corpus défaillant ?
L’ajustement du prompt peut améliorer une consigne, mais ne remplace pas la récupération d’une information manquante, le respect des droits et une mesure du résultat.
« On affinera les prompts après. » L’ajustement de prompt corrige une formulation, pas une architecture. Si le système ne retrouve pas le bon document, aucun prompt ne le sauvera. Il rendra simplement une erreur mieux écrite.
Pourquoi l’intégration et le coût font-ils tomber un prototype qui marchait ?
Un prototype d’IA générative qui marchait tombe à l’intégration parce qu’il ignorait les droits d’accès, les outils réels et le coût par requête, trois contraintes absentes de toute démonstration. C’est le troisième écart, souvent découvert au moment de brancher le système sur le poste de travail.
En démonstration, une seule personne interroge le système, avec tous les droits, dans une fenêtre dédiée. En production, des centaines d’utilisateurs aux habilitations différentes l’interrogent depuis leurs outils habituels. Trois questions surgissent alors.
- Qui a le droit de voir quoi ? Une réponse qui cite un document confidentiel à quelqu’un qui n’y a pas accès est une fuite, même si elle est juste. Les règles sur ce qu’on a le droit de mettre dans un prompt s’appliquent dès le cadrage.
- Où la réponse s’insère-t-elle ? Un parcours qui impose des copies manuelles peut diminuer le bénéfice et créer des erreurs ; il se teste avec les utilisateurs.
- Combien coûte une réponse ? Le prix d’un appel à GPT-4 est négligeable sur dix questions de démonstration ; il devient une ligne budgétaire sur des milliers de requêtes quotidiennes avec de longs contextes.
Le coût se traite en dernier, mais s’estime dès le début, sur le volume réel attendu.
Quel écart n’apparaît qu’une fois le système en exploitation ?
Le vieillissement du corpus est l’écart qui n’apparaît qu’en exploitation : un système indexé une fois peut continuer à répondre avec assurance sur des documents devenus périmés. La cohérence d’une réponse ne démontre pas l’autorité de sa source.
Désignez une référence pour chaque famille documentaire. Lorsqu’une procédure change, retirez la version remplacée et vérifiez les réponses qui en dépendaient. L’entretien doit être prévu dès le prototype, avec un responsable et une règle de mise à jour.
Une alerte utilisateur peut révéler un document périmé ; elle ne remplace pas ce contrôle régulier.
Comment reconnaître lequel des quatre écarts fait échouer votre essai ?
Chacun des quatre écarts qui font échouer un essai d’IA générative laisse un symptôme reconnaissable, ce qui permet de diagnostiquer la cause avant de toucher au prompt ou au modèle. Le tableau suivant relie les symptômes observés aux causes probables.
| Écart | Symptôme observé | Vérification rapide | Correction prioritaire |
|---|---|---|---|
| Données | Réponses justes en démonstration, fausses sur les dossiers réels | Tester cinquante dossiers tirés au hasard | Nettoyer et structurer le corpus |
| Définition du succès | Débats sans fin sur la qualité, pas de décision | Demander qui valide une réponse et selon quel seuil | Écrire le critère et constituer le jeu de tests |
| Intégration et coût | Usage qui s’effondre après le lancement, facture imprévue | Mesurer le parcours réel et le coût par requête | Brancher dans l’outil existant, gérer les droits |
| Vieillissement | Réponses cohérentes mais périmées | Comparer la date des sources citées à la version en vigueur | Réindexation planifiée et retrait des versions |
Comment construire un prototype qui prédit vraiment la production ?
Un prototype d’IA générative renseigne sur la production lorsqu’il utilise un échantillon représentatif des dossiers et des demandes, comprenant les défauts et les situations sensibles de l’usage prévu. Il doit montrer ce qui résiste, pas seulement ce qui réussit.
Je pars d’un échantillon non choisi pour impressionner, puis j’ajoute explicitement les cas rares à fort impact. Le tirage aléatoire seul peut les manquer. Des documents représentatifs permettent aux utilisateurs de contester les réponses et de préciser les attentes.
La récupération documentaire sert à fournir les éléments nécessaires à une réponse. Elle ne garantit ni leur qualité ni la justesse du modèle.
Pourquoi construire le jeu de tests avant la première réponse correcte ?
Le jeu de tests d’un système d’IA générative doit exister avant que le système ne fonctionne, parce qu’il définit ce que « bon » veut dire au lieu d’entériner ce que le système fait déjà. C’est contre-intuitif et c’est ce qui distingue les projets qui avancent.
Sa constitution prend une journée et la méthode est décrite dans construire un jeu de tests en une journée. C’est le premier livrable que je demande, avant toute ligne de code.
Dans quel ordre traiter les quatre écarts ?
Le corpus d’abord, la définition du succès ensuite, l’intégration en troisième, le coût en dernier : cet ordre de traitement des écarts évite de corriger un symptôme dont la cause est ailleurs. Il est rarement suivi.
Le réflexe habituel consiste à ouvrir le prompt, parce qu’il est visible et modifiable. C’est la troisième chose à regarder, jamais la première, et le détour retarde le diagnostic.
La vérification commence sur un échantillon de mauvaises réponses : l’information correcte figurait-elle dans les extraits fournis au modèle ? Si elle n’y était pas, aucun travail sur le prompt ne changera quoi que ce soit.
Cette méthode de diagnostic est développée dans reprendre un système d’IA construit par quelqu’un d’autre, et elle s’applique aussi bien à un premier essai qu’à un système hérité. Pour un regard extérieur sur un essai qui stagne, un audit IA applique la même grille aux quatre écarts.
Quelles erreurs éviter lors d’un premier essai avec GPT-4 ?
Les erreurs coûteuses d’un premier essai avec GPT-4 consistent à juger une démonstration, à différer la définition du succès et à oublier les utilisateurs qui doivent vérifier les réponses. Une formation IA peut préparer cette lecture critique.
La couche d’accès aux modèles présentée avec Bedrock aide à examiner l’intégration et la remplaçabilité ; elle ne prouve pas la fiabilité de l’application.
Lectures complémentaires : pourquoi le RAG reste la seule architecture qui tienne ; ce qui occupe l’équipe la deuxième année ; construire un jeu de tests en une journée ; reprendre un système d’IA construit par quelqu’un d’autre. Ces liens complètent la navigation du site.
Quelles questions clarifient un premier essai de GPT-4 en production ?
Un premier essai de GPT-4 doit distinguer la qualité des données, la définition du succès, les contraintes d’intégration et l’entretien du corpus avant de conclure.
Questions fréquentes
Pourquoi une démonstration réussie ne prédit-elle rien de la production ?
Parce qu’elle choisit ses exemples : des documents propres, des questions bien formulées. La production apporte les documents mal numérisés et les questions incomplètes, qui font partie des cas à tester. Un échantillon représentatif, complété par les situations critiques, donne une mesure plus utile.
Quel est l’écart le plus fréquent entre prototype et production ?
Celui des données. Le prototype tourne sur un échantillon choisi ; la production tourne sur le corpus réel, avec ses versions multiples, ses documents périmés et ses formats hétérogènes.
Quand faut-il construire le jeu de tests d’un projet d’IA ?
Avant que le système ne fonctionne. Construit après, il entérine ce que le système fait déjà et perd toute valeur d’arbitrage ; construit avant, il définit ce que « bon » veut dire.
Quel écart n’apparaît qu’en exploitation ?
Le vieillissement du corpus. Une source peut devenir périmée sans empêcher le modèle de répondre. Vérifiez sa version et son autorité, plutôt que d’attendre un délai supposé de vieillissement.
Faut-il améliorer le prompt quand les réponses sont fausses ?
Pas en premier. Il faut d’abord vérifier que l’information correcte figurait dans les extraits fournis au modèle. Si elle n’y était pas, le problème est dans la recherche documentaire, et aucun prompt ne le corrigera.
GPT-4 suffit-il à faire réussir un projet qui échouait avec un modèle précédent ?
Rarement. Un modèle plus puissant améliore le raisonnement sur ce qu’on lui donne, mais ne corrige ni un corpus mal préparé, ni un critère de succès absent, ni une intégration mal pensée. Ce sont ces écarts qu’il faut traiter d’abord.