Qu’est-ce qui change pour l’équipe d’un système d’IA la deuxième année ?
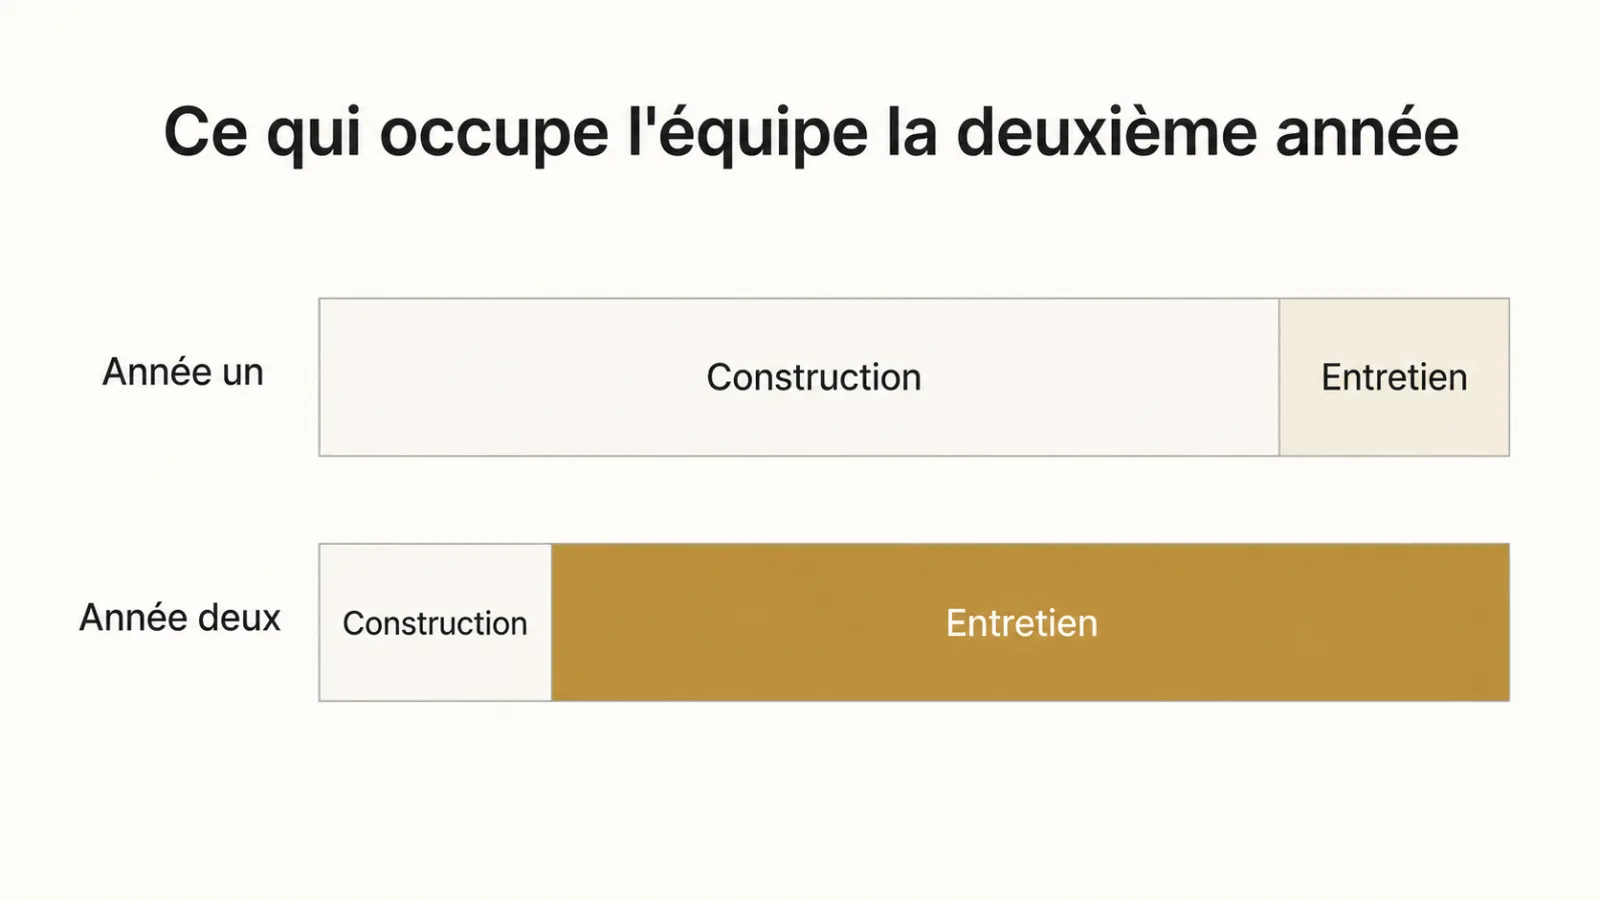
Après la mise en service d’un système d’IA, l’équipe doit entretenir corpus, versions, tests et usages, avec une charge à prévoir dès le budget initial. La deuxième année rend cette charge particulièrement visible.
La maintenance d’un système d’IA désigne tout ce qu’il faut faire pour qu’un système déjà en service continue de répondre juste : tenir le corpus à jour, suivre les changements de modèle, diagnostiquer les incidents, ajuster le périmètre. Elle ressemble peu à la maintenance d’un logiciel classique, parce qu’un système d’IA peut se dégrader sans qu’une seule ligne de son code ait changé.
Le budget initial couvre le développement, l’intégration et la mise en service. Il s’arrête là. La deuxième année ne fait l’objet d’aucune ligne, alors qu’elle mobilise une charge continue.
Cette charge n’est pas de la correction de défauts : elle vient de l’environnement du système, qui bouge. Le corpus évolue, les modèles sont remplacés, les usages se déplacent, les obligations changent.
| Dimension | Première année | Deuxième année |
|---|---|---|
| Nature du travail | Construire, intégrer, mettre en service | Entretenir, vérifier, ajuster |
| Origine des tâches | Le cahier des charges | L’environnement : corpus, modèles, usages, obligations |
| Visibilité | Forte, chaque livraison se voit | Faible, une dégradation ne se voit pas |
| Budget | Construction et exploitation à prévoir | Exploitation à réestimer sur les charges constatées |
| Compétence clé | Concevoir | Diagnostiquer et décider |
Cette inversion explique une part importante de la dette technique d’un système d’IA : elle peut être créée pendant la construction puis aggravée par un entretien insuffisant.
Pourquoi le corpus qui vieillit est-il la charge la plus lourde ?
Un corpus non rafraîchi peut conserver des versions périmées et produire des réponses cohérentes mais inapplicables, ce qui impose un suivi des modifications et du statut documentaire. Son poids dépend du rythme de changement.
Le mécanisme est lent. Une procédure est mise à jour, l’ancienne version reste dans l’index. Un référentiel produit évolue, l’index conserve les références retirées. Six mois plus tard, une part des réponses porte sur un état qui n’existe plus.
Ce type d’erreur peut rester non signalé si l’utilisateur ne connaît pas la version en vigueur : la réponse est cohérente, sourcée, et fausse.
La parade est un processus, pas un outil : décider qui signale une mise à jour documentaire, et à quelle fréquence l’index est rafraîchi. Concrètement, cela tient en trois décisions écrites : la liste des sources suivies, le nom de la personne qui signale chaque modification dans chacune, et le délai maximal entre une modification et sa prise en compte dans l’index. C’est un travail d’organisation, prolongement direct de le corpus est le projet.
Quelles tâches d’entretien faut-il prévoir au-delà du corpus ?
Au-delà du corpus, il faut prévoir les changements de modèle, le diagnostic des incidents, la revue des usages et l’enrichissement des tests, chacun avec un responsable identifié.
- Les migrations de modèle, selon les besoins du service et les annonces de retrait des fournisseurs, sans cadence annuelle universelle, avec revérification des réglages. Voir ce qu’une génération majeure ne change pas.
- Le diagnostic d’incidents, qui suppose des journaux exploitables et quelqu’un qui sait les lire.
- La dérive des usages : les utilisateurs posent d’autres questions qu’au départ, et le périmètre doit suivre.
- Et une charge de fond : le jeu de tests, qu’il faut alimenter avec les échecs réels sous peine de péremption.
Comment absorber une migration de modèle sans dégrader le système ?
Une migration de modèle se traite comme une mise en production à part entière, avec un jeu de tests rejoué avant la bascule, parce qu’un nouveau modèle change le comportement même quand le code ne bouge pas. C’est la charge la plus prévisible de la deuxième année.
Les fournisseurs retirent leurs anciennes versions selon leur propre calendrier, et parfois un modèle désigné par un alias change sous le même nom. Le scénario est décrit dans le jour où le modèle a changé sans prévenir. L’équipe ne choisit donc pas toujours le moment, mais elle peut choisir la méthode :
- Figer la version du modèle utilisée en production, pour que tout changement soit une décision.
- Rejouer le jeu de tests sur le modèle candidat et comparer le taux d’erreur, le taux de refus et le coût par requête.
- Revérifier les réglages qui dépendaient de l’ancien modèle : consigne système, exemples, nombre d’extraits, format de sortie.
- Basculer une fraction du trafic, observer, puis généraliser.
- Consigner la décision et ses résultats dans la fiche du système.
La méthode complète, appliquée aux agents, figure dans migrer un agent sans régression. Sans jeu de tests, l’étape 2 est impossible, et la migration devient un pari dont on découvre le résultat par les utilisateurs.
Comment traiter la dérive des usages d’un système d’IA ?
Les questions posées après la mise en service peuvent évoluer vers des tâches nouvelles, ce qui demande de réexaminer le périmètre, les risques et les critères de réponse. Elle est la plus intéressante à traiter.
Un système conçu pour retrouver des procédures reçoit progressivement des questions d’interprétation : non plus « que dit la procédure » mais « est-ce que ma situation entre dedans ». C’est une autre tâche, avec un autre risque.
Deux réponses sont possibles et toutes deux légitimes. Élargir le périmètre en connaissance de cause, ce qui suppose de reprendre l’analyse de risque et la fiche du système. Ou refuser explicitement ce type de question et le dire à l’utilisateur.
La mauvaise réponse est de laisser faire. Le système répond alors à une question pour laquelle il n’a été ni conçu, ni testé, ni documenté. C’est la dérive décrite dans écrire la fiche d’un système d’IA.
Je propose une revue périodique des questions réelles, dont la fréquence dépend du risque et du volume ; les incidents restent traités sans attendre. Encore faut-il que ces questions soient journalisées et consultables, ce qui renvoie à l’observabilité des systèmes d’IA.
Comment rendre l’entretien d’un système d’IA supportable ?
Une revue régulière du corpus, des modèles, des usages et des tests organise l’entretien d’un système documentaire, sans remplacer la surveillance continue ni le traitement immédiat des incidents. Je propose un rendez-vous trimestriel comme point de départ à adapter.
L’ordre du jour est stable :
- Rafraîchissement du corpus et vérification des documents modifiés depuis le dernier rendez-vous.
- Rejeu du jeu de tests sur les modèles disponibles, avec décision de bascule ou de maintien.
- Lecture d’un échantillon de questions réelles pour détecter la dérive des usages.
- Relecture de la fiche du système et mise à jour de ce qui a changé.
Ce rituel a une propriété utile : il produit une trace datée des décisions, qui sert à la fois à la conformité et à la personne qui reprendra le système.
Son absence produit le scénario que je rencontre le plus souvent en reprise : un système qui fonctionnait, dont personne ne sait quand il a cessé de fonctionner correctement, et dont plus personne ne connaît les réglages. Ce que coûte cette situation est détaillé dans reprendre un système d’IA construit par quelqu’un d’autre.
Tenir ces rendez-vous suppose aussi que l’équipe sache quoi y regarder. C’est l’objet d’une formation à l’IA centrée sur l’exploitation plutôt que sur l’usage, dans l’esprit de former à tenir un système, pas à utiliser un outil.
Comment interpréter une variation du taux de refus d’un assistant ?
Une variation du taux de refus doit être interprétée avec les questions reçues et les erreurs observées, car elle peut signaler un progrès, une dérive ou un changement d’usage.
Le taux de réponses « je ne sais pas », suivi dans le temps. Une baisse soudaine signale souvent que le système s’est mis à répondre là où il refusait, ce qui demande de vérifier les sources et les cas hors périmètre avant de conclure.
Que faut-il provisionner dès le premier dossier d’investissement ?
Tout dossier d’investissement dans un système d’IA doit contenir une ligne d’exploitation annuelle, distincte du coût de construction, avec le nom de la personne qui l’assure. C’est le geste qui évite le décrochage de la deuxième année.
Je chiffre cette ligne à partir des tâches, des responsabilités et des événements prévisibles, sans appliquer un pourcentage universel au coût de construction.
Un dossier qui ne mentionne pas cette ligne présente un investissement dont le coût réel sur trois ans est très supérieur à celui annoncé. Il sera arbitré sur un chiffre faux, et la déception arrivera au deuxième exercice. La répartition réelle des dépenses est développée dans où part réellement un budget d’IA.
Mentionner cette ligne a un effet secondaire appréciable : elle oblige à nommer qui assurera l’entretien. Un système sans personne désignée est un système qui se dégradera, quelle que soit sa qualité initiale.
Quelles erreurs fragilisent un système d’IA la deuxième année ?
Les erreurs qui fragilisent un système d’IA la deuxième année ont un point commun : elles traitent l’exploitation comme une fin de projet alors qu’elle en est la phase la plus longue. Quatre reviennent souvent.
- Dissoudre l’équipe à la mise en service. Les connaissances sur les réglages partent avec elle, et le premier incident devient une enquête.
- Ne plus enrichir le jeu de tests. Il reflète alors les questions de la première année, pas celles qu’on pose aujourd’hui.
- Rafraîchir l’index sans retirer les documents périmés. Ajouter la nouvelle version d’une procédure sans supprimer l’ancienne laisse le système choisir entre les deux.
- Juger la santé du système à l’absence de plaintes. Les erreurs les plus graves, cohérentes et sourcées, ne déclenchent aucune plainte.
Pour un système déjà en service dont personne ne sait plus vraiment s’il répond juste, un audit IA permet de rétablir un état des lieux daté avant de décider ce qu’on entretient, ce qu’on reprend et ce qu’on arrête.
Quelles questions se poser sur la maintenance d’un système d’IA ?
Qu’est-ce qui occupe l’équipe d’un système d’IA la deuxième année ?
Le rafraîchissement du corpus, les migrations de modèle, le diagnostic d’incidents et la dérive des usages, plus l’alimentation du jeu de tests. Aucune de ces charges n’est de la correction de défauts : elles viennent de l’environnement du système, qui bouge.
Pourquoi le corpus qui vieillit est-il si problématique ?
Une ancienne version peut soutenir une réponse cohérente mais devenue inapplicable ; vérifier les dates et le statut documentaire permet de repérer cette erreur avant généralisation.
Comment traiter la dérive des usages ?
En lisant un échantillon de questions réelles chaque trimestre. Puis soit élargir le périmètre en reprenant l’analyse de risque, soit refuser explicitement le nouveau type de question. Laisser faire est la mauvaise réponse.
Que provisionner dans un dossier d’investissement en IA ?
Une ligne d’exploitation annuelle distincte du coût de construction. Sans cette ligne, le budget omet des charges possibles de la durée d’exploitation, et l’arbitrage repose sur un périmètre incomplet.
À quelle fréquence faut-il revoir un système d’IA en exploitation ?
Je propose une revue trimestrielle à adapter au risque et au rythme de changement, avec surveillance continue et prise en charge des incidents sans attendre ce rendez-vous.
Quel indicateur signale une dégradation avant les utilisateurs ?
Le taux de refus constitue un signal à comparer aux cas reçus et aux réponses erronées ; sa baisse ne prouve ni progrès ni dégradation à elle seule.