PaLM 2 suffit-il pour répondre dans plusieurs langues ?
PaLM 2 met en avant la génération multilingue, mais un assistant documentaire doit aussi retrouver les bonnes sources lorsque la question et le document utilisent des langues différentes.
Google présente PaLM 2 le 10 mai 2023 avec un entraînement multilingue et plusieurs tailles de modèles. Cette annonce intéresse une organisation qui rédige sa documentation en français et reçoit des demandes en anglais, en espagnol ou en allemand. Elle ne résout pas, à elle seule, son problème de recherche.
Je distingue deux composants : celui qui retrouve les passages et celui qui rédige la réponse. Le second peut parler la langue de l’utilisateur sans que le premier ait retrouvé le document utile. Le résultat est alors une réponse fluide, construite sur une information insuffisante.
Le sujet rejoint la récupération imposée par une fenêtre limitée : donner accès à un corpus ne signifie pas que le modèle le connaît. Dans un système multilingue, cette distinction devient une condition de recette.
Pourquoi une question française peut-elle manquer un document anglais ?
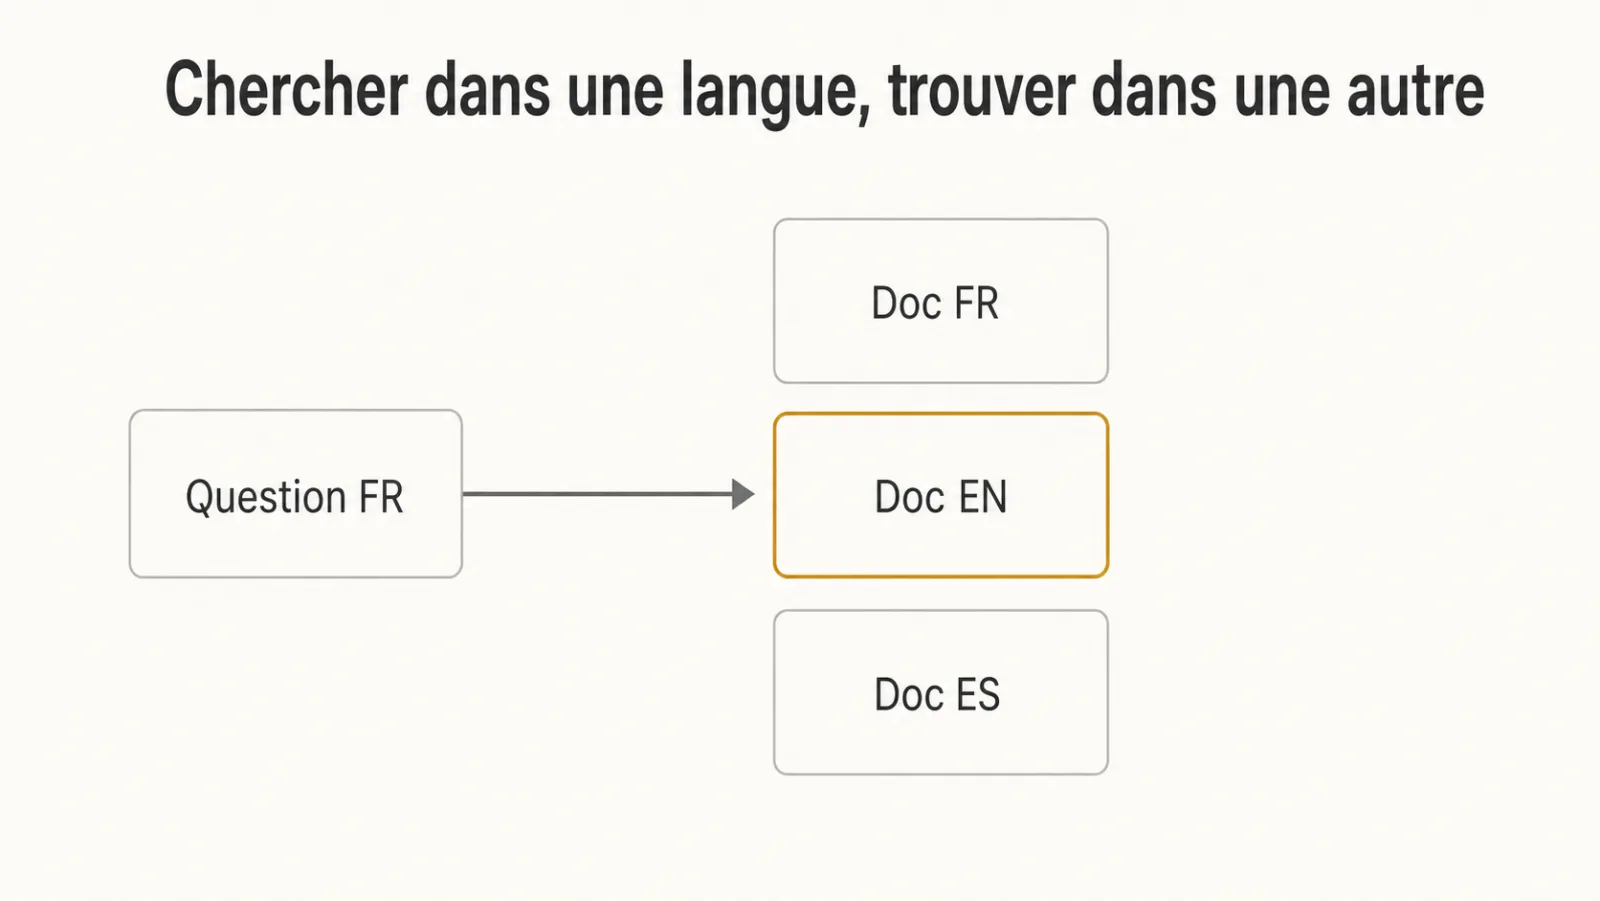
Une question française peut manquer un document anglais lorsque le système de recherche ne rapproche pas suffisamment leurs formulations, même si elles décrivent le même problème métier.
Un embedding est une représentation numérique qui permet de comparer des textes. La recherche vectorielle rapproche une question des passages représentés dans le même espace. Encore faut-il que cet espace encode correctement la correspondance entre langues.
Un index performant sur une langue ne démontre pas cette propriété. Il peut retrouver une procédure française avec une question française, puis échouer avec une question anglaise équivalente. Le résultat dépend du modèle d’embeddings, de son entraînement et du contenu réel ; l’échec n’est pas une fatalité universelle des modèles monolingues.
Les travaux de Reimers et Gurevych publiés en 2020 proposent précisément de rapprocher les représentations de phrases traduites. Ils donnent un fondement technique à cette distinction, sans garantir le comportement sur votre référentiel. Je commence donc par observer les passages retrouvés, avant de toucher au prompt de génération.
Comment tester la recherche multilingue avant la mise en service ?
La recherche multilingue se teste en posant des questions équivalentes dans chaque langue d’usage, puis en vérifiant les documents retrouvés avant la qualité de rédaction.
- Recenser les langues des questions et celles des documents, y compris les annexes techniques.
- Choisir des situations métier avec un passage de référence et un résultat attendu explicite.
- Faire reformuler les questions par une personne compétente dans chaque langue, sans changer leur intention.
- Examiner les passages retrouvés, leur version et les droits qui autorisent leur consultation.
- Tester la réponse finale : exactitude, terminologie et conservation des réserves de la source.
- Conserver les échecs pour comparer les variantes d’index sur les mêmes cas.
Un exemple générique : une équipe demande en français la température autorisée d’un équipement dont la notice est anglaise. La réponse doit retrouver la bonne référence, conserver l’unité et distinguer la température de fonctionnement de celle de stockage. Une belle traduction ne suffit pas.
Cette recette prolonge le diagnostic de premiers essais avec GPT-4 : séparer les causes évite de corriger le mauvais composant.
Faut-il choisir un index multilingue ou une traduction pivot ?
Le choix entre index multilingue et traduction pivot dépend des langues, de la stabilité du corpus et de la capacité à maintenir des versions cohérentes.
| Option | Intérêt | Point de vigilance | Vérification nécessaire |
|---|---|---|---|
| Index multilingue | Recherche croisée sans traduire tout le corpus | Correspondances inégales selon les langues | Paires question et source réelles |
| Traduction des questions | Conservation du corpus original | Termes techniques déformés | Question traduite comparée à l’intention |
| Traduction du corpus vers une langue pivot | Recherche dans une représentation commune | Synchronisation des traductions | Version et provenance de chaque passage |
| Index par langue avec coordination | Contrôle fin des collections | Recherche sur plusieurs ensembles | Couverture et fusion des résultats |
Je recommande de comparer les options avec le même jeu de cas. La traduction du corpus peut convenir à un référentiel stable ; elle crée une maintenance supplémentaire lorsque les sources changent. Elle ne supprime pas toute difficulté linguistique, car un terme mal traduit peut encore empêcher la récupération.
La décision gagne à être prise au cadrage. Changer ensuite de représentation peut imposer une réindexation et une nouvelle recette. Il faut prévoir cette charge sans lui attribuer un délai universel.
Quelle version doit faire autorité quand les traductions divergent ?
Lorsque des versions linguistiques divergent, l’organisation doit désigner la source faisant autorité et les règles de traduction avant de laisser l’assistant produire une réponse.
Une procédure peut être corrigée en français sans que sa traduction anglaise ait été mise à jour. L’index retrouve alors deux passages plausibles et contradictoires. Ce n’est pas un problème que le modèle doit arbitrer sur son style préféré.
Chaque document doit porter sa langue, son statut, sa date de validité et son lien avec les autres versions. La règle d’autorité peut varier selon le domaine. Elle doit être décidée par la personne qui connaît le référentiel, puis appliquée avant ou pendant la sélection des passages.
J’affiche aussi la langue de la source avec la réponse. L’utilisateur peut ainsi distinguer une formulation traduite d’un texte original et remonter au passage. Si la traduction exige une validation spécialisée, cette limite doit être visible.
Dans un jumeau numérique, la même discipline concerne les notices et les paramètres : une unité ou une consigne mal traduite peut modifier l’interprétation du système.
Comment protéger les informations dans un assistant multilingue ?
Un assistant multilingue doit appliquer les mêmes droits d’accès dans toutes les langues, y compris lors de la traduction et avant l’envoi des passages au modèle.
Une question anglaise ne doit pas contourner les droits qui bloqueraient la même demande en français. Si les collections sont séparées par langue, les permissions doivent rester cohérentes. Si un prestataire traduit les questions ou les documents, son accès aux données fait partie du traitement à examiner.
La confidentialité des prompts reste donc un sujet distinct de la qualité linguistique. Une bonne réponse n’autorise pas une transmission de documents sensibles.
Je vérifie aussi ce qui est enregistré : question originale, éventuelle traduction, passages sélectionnés et version du modèle. Les traces nécessaires au diagnostic ne justifient pas une conservation sans limite.
Un audit IA peut cartographier ces étapes. Le livrable utile est une chaîne compréhensible : où la traduction intervient, qui reçoit quoi et quelle version fonde la réponse.
Quelles erreurs faut-il éviter dans la recette par langue ?
La recette par langue échoue lorsqu’elle mesure seulement la fluidité de la réponse, oublie les références exactes ou confond une traduction correcte avec une source pertinente.
Je garde des questions ambiguës, des termes métier, des sigles et des références proches. Un test uniquement composé de phrases simples surestime la couverture. Les noms de produits et les unités demandent parfois un traitement différent du texte courant.
Autre erreur : conclure qu’un système est multilingue parce que ses réponses sont rédigées dans plusieurs langues. Il faut inspecter les sources retrouvées et vérifier leur adéquation. Un refus explicite vaut mieux qu’une réponse appuyée sur le mauvais document.
La formation IA des utilisateurs doit leur apprendre à lire cette provenance. Elle ne remplace pas la recette technique ; elle aide à reconnaître une traduction incertaine ou une source périmée.
Enfin, je compare les résultats langue par langue. Une moyenne globale peut masquer une langue mal servie. Le périmètre accepté doit être annoncé et revu lorsque de nouvelles langues entrent dans le service.
Quelles questions fréquentes faut-il trancher sur le multilingue ?
Un modèle de génération multilingue suffit-il ?
Un modèle de génération multilingue ne suffit pas lorsque l’index ne retrouve pas les documents pertinents dans une autre langue ou sélectionne une version incorrecte. Il faut tester les deux composants séparément.
Faut-il traduire tous les documents ?
Traduire tous les documents est une option à comparer avec la traduction des questions et un index multilingue, selon la stabilité du corpus et les usages. La synchronisation des versions reste nécessaire.
Une organisation francophone est-elle concernée ?
Une organisation francophone peut être concernée dès que son corpus contient des notices, des annexes ou des références étrangères utilisées pour répondre à des questions françaises. La langue de travail ne décrit pas tout le corpus.
Comment choisir la langue de référence ?
La langue de référence doit être décidée par le responsable du référentiel, en tenant compte du statut des documents et des règles propres au domaine. Le modèle ne tranche pas ce choix organisationnel.
Comment savoir si l’index fonctionne ?
Pour savoir si l’index fonctionne, comparez les passages retrouvés pour des questions équivalentes dans les langues prévues, avec des références attendues et des critères écrits. Examinez ensuite la réponse produite.
Que faire si une langue échoue à la recette ?
Lorsqu’une langue échoue à la recette, il faut limiter le service annoncé, diagnostiquer la récupération et vérifier les traductions avant d’élargir le périmètre. Une moyenne satisfaisante ne suffit pas.
Lectures complémentaires : les embeddings expliqués à une direction, l’évaluation continue et la dette technique d’un système d’IA.