GPT-6.1 Sol est un modèle d’OpenAI destiné aux travaux complexes ; sa migration en entreprise consiste à vérifier la qualité, les outils et le coût sur des tâches définies. Le prix du jeton constitue une donnée d’entrée. La décision repose sur ce que le système livre correctement, avec les droits et les délais attendus.
OpenAI a annoncé GPT-6.1 Sol le 29 septembre 2026. Cette analyse, rédigée le 19 octobre 2026, examine l’annonce et la documentation officielle pour construire une recette avant adoption. Elle ne présente aucun résultat de migration chez un client ni aucune mesure de performance issue d’un essai local.
Qu’apporte GPT-6.1 Sol aux entreprises ?
OpenAI présente GPT-6.1 Sol comme un compromis entre capacité et coût pour le code, l’usage des applications et les travaux professionnels complexes. La proximité annoncée avec GPT-6 Astra provient des évaluations de l’éditeur. Elle doit être confrontée aux tâches de l’entreprise avant de justifier un changement de modèle.
À son lancement, l’annonce indique un accès dans ChatGPT Work et Codex pour les offres Plus, Pro, Business, Enterprise et Edu, ainsi qu’un accès API. Elle précise alors une absence dans Chat. Ce constat daté ne garantit pas les droits d’un compte particulier : l’équipe doit vérifier la surface effectivement disponible dans son organisation.
Pour une direction, la bonne question consiste à identifier les activités dont le niveau de qualité peut être maintenu avec une configuration moins coûteuse. Le candidat peut être pertinent pour une famille de tâches et insuffisant pour une autre. Cette décision par usage évite de transformer une annonce de modèle en migration générale. Elle prolonge la méthode pour tenir la cadence des sorties sans tout casser.
Quel prix API faut-il comparer avant la migration ?
Le prix API doit être comparé dans un même mode de service, en distinguant entrée, cache, sortie et longueur du contexte réellement envoyé. La page tarifaire officielle, vérifiée le 19 octobre 2026, publie les montants Standard suivants, en dollars américains par million de jetons.
| Poste GPT-6.1 Sol | Contexte court | Contexte long |
|---|---|---|
| Entrée non mise en cache | 2 $ | 4 $ |
| Lecture du cache | 0,10 $ | 0,20 $ |
| Écriture du cache | 2,50 $ | 5 $ |
| Sortie | 10 $ | 15 $ |
La fiche du modèle situe le changement de tarif au-delà de 272 000 jetons d’entrée, pour la requête entière. Un contexte plus grand ne constitue donc pas seulement une capacité supplémentaire. Il modifie aussi le régime de facturation à prendre en compte.
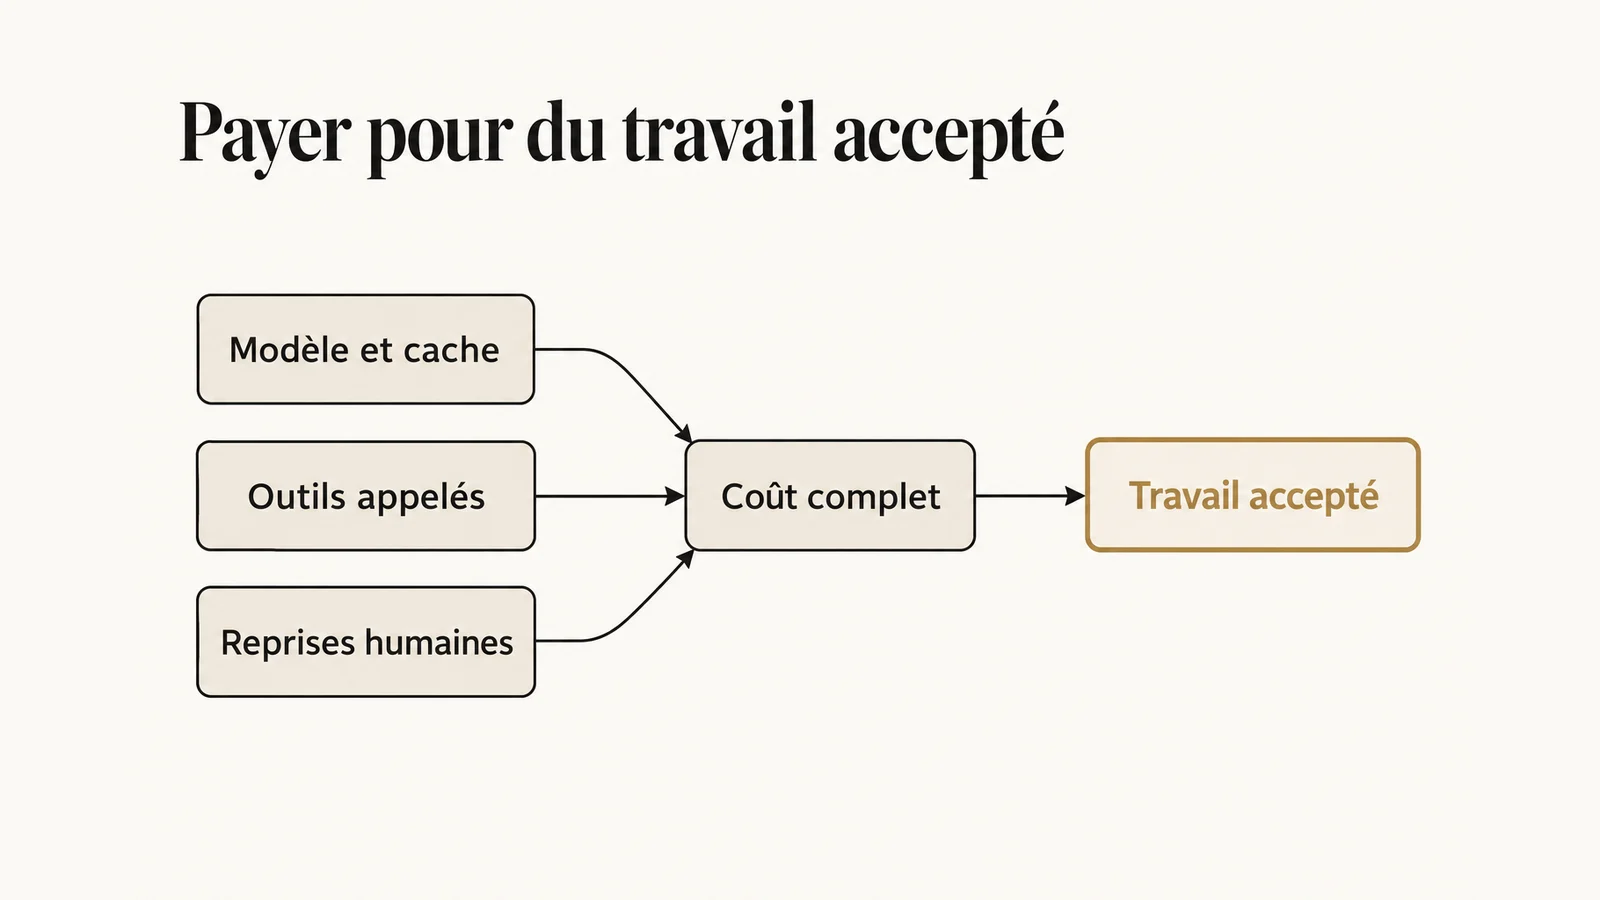
Les modes accélérés, les traitements différés et les conditions régionales appellent une lecture de leurs tarifs propres. Comparez ensuite la dépense complète : appels au modèle, outils, nouvelles tentatives et travail humain. Une tâche peu chère qui doit être refaite reste une charge. La méthode du coût réel d’un système IA permet de relier la facture au service effectivement rendu.
Le cache peut-il faire baisser le coût d’un agent ?
Le cache peut réduire le coût des entrées réutilisées, mais son intérêt doit être mesuré sur les requêtes facturées et les résultats acceptés. Le tarif de lecture ne suffit pas à décrire la dépense d’une conversation, qui peut aussi comporter des entrées nouvelles, des écritures de cache et des sorties importantes.
Lors du pilote, distinguez les éléments stables de la demande et ceux qui changent avec chaque dossier. Conservez les informations de consommation nécessaires au rapprochement avec la facture. Examinez séparément une première exécution et une reprise, puis recherchez ce qui a effectivement été réutilisé. L’analyse de la mise en cache du contexte aide à préparer cette observation.
Ne retirez pas une instruction de sécurité ou une pièce indispensable pour améliorer artificiellement ce résultat. Le but consiste à garder le même service métier avec une dépense mieux comprise. Une économie qui repose sur des documents moins récents, des vérifications supprimées ou des réponses plus vagues dégrade la comparaison. Le dossier de décision doit rendre ces compromis visibles.
Comparez aussi une journée de travail composée de demandes différentes avec une série de reprises du même dossier. Ces situations peuvent être définies comme scénarios de test, sans leur attribuer une économie présumée. Séparez les consommations observées et expliquez leur origine. La direction saura ainsi sur quelles habitudes de travail repose l’estimation et quelles variations pourraient remettre son intérêt en cause.
Quels changements techniques faut-il vérifier avec gpt-6.1-sol ?
La migration doit vérifier l’identifiant du modèle, les réglages de raisonnement et le chemin d’appel des outils avant de comparer les réponses métier. La documentation nomme le modèle gpt-6.1-sol et prévoit les efforts low, medium, high, xhigh et max. Les réglages none et minimal ne sont pas pris en charge.
La fiche officielle demande l’API Responses pour les appels d’outils ; Chat Completions est pris en charge sans ces appels. Une intégration existante ne doit donc pas être réputée compatible au seul motif qu’une réponse textuelle fonctionne. Il faut exercer les opérations nécessaires au service, les résultats structurés et la gestion des erreurs.
Consignez la version du code, les instructions, les outils exposés et les paramètres utilisés. Vérifiez les délais d’expiration, les reprises et le comportement lorsqu’un résultat arrive incomplet. Un changement de réglage peut modifier le travail du système ; il doit apparaître dans la comparaison. Pour une DSI, ce relevé constitue le minimum permettant de migrer un agent sans régression et de reproduire un échec après la bascule.
Pour chaque opération préparée, distinguez la proposition, la demande d’exécution et la confirmation de son effet. Une réponse du modèle ne doit pas tenir lieu de preuve d’écriture dans un logiciel. Pendant le pilote, faites vérifier l’état résultant par un contrôle indépendant. Ce relevé permet également de savoir ce qu’il faut reprendre après une coupure sans rejouer aveuglément une action déjà accomplie.
Comment comparer la qualité sans masquer les régressions ?
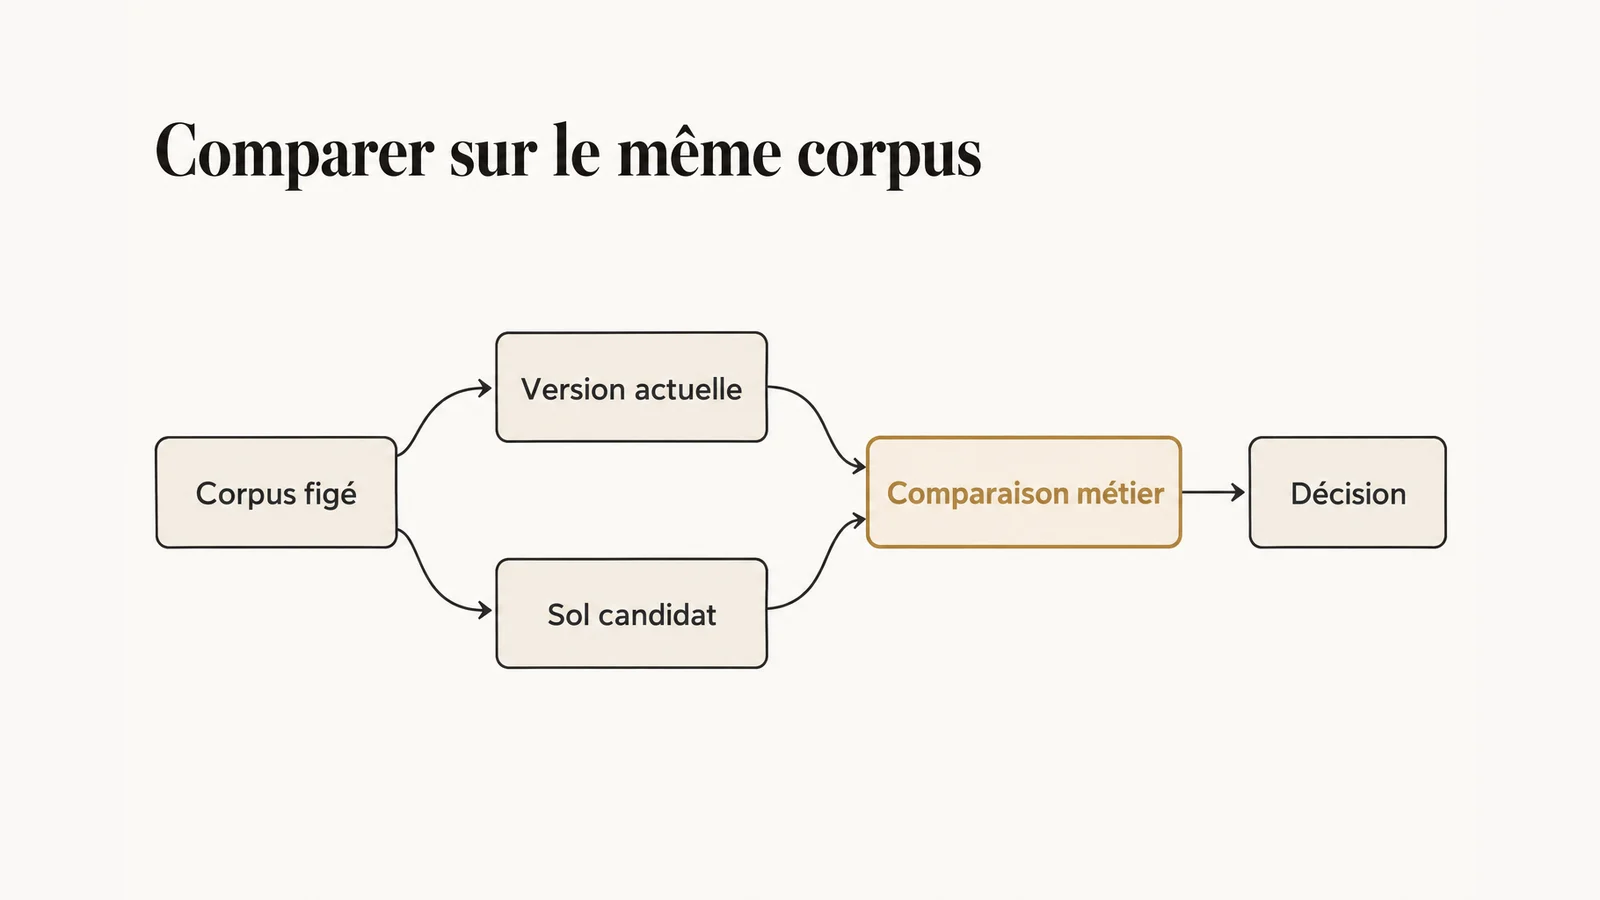
La comparaison doit rejouer les mêmes tâches avec des critères définis à l’avance, puis examiner les échecs individuellement avant de calculer un résultat global. Les bonnes pratiques d’évaluation d’OpenAI recommandent de fixer les objectifs, constituer un jeu de données, choisir les mesures, comparer et évaluer à chaque changement.
Voici un protocole proposé, à exécuter sur des données autorisées et dans un environnement qui protège les applications métier :
- Sélectionner des tâches habituelles, des cas difficiles et des demandes qui doivent être refusées.
- Définir les faits indispensables, les erreurs bloquantes et le livrable attendu pour chaque cas.
- Figer les documents et conserver la configuration actuellement utilisée comme référence.
- Exécuter le candidat avec les mêmes droits et relever consommation, durée et effets observés.
- Faire relire les résultats selon une grille commune, sans privilégier une réponse simplement plus élégante.
- Classer les écarts par cause et rejouer les cas touchés après chaque correction.
Le guide pour construire un jeu de tests peut servir de point de départ. Gardez les cas de contrôle distincts de ceux utilisés pour corriger les instructions. Une amélioration sur les exemples déjà ajustés ne suffit pas à établir une progression sur les dossiers à venir.
Pour un document, examinez les références et les omissions. Pour du code, contrôlez le comportement livré. Pour un agent, vérifiez l’état final des applications. Le critère doit correspondre au travail demandé, puis rester identique entre les configurations comparées.
Les progrès de sûreté autorisent-ils davantage d’autonomie ?
Les progrès de sûreté annoncés par l’éditeur ne remplacent pas les limites techniques qui contrôlent les droits, les effets externes et l’arrêt des opérations. L’addendum de sûreté de GPT-6.1 Sol, publié le 29 septembre 2026, décrit plusieurs évaluations distinctes. Le respect d’un refus automatisé et la réaction à un avertissement n’y constituent pas la même épreuve.
Le document précise aussi les conditions de ses tests. Les résultats sur des situations difficiles ne doivent pas devenir un taux d’incident attendu dans votre entreprise. Pour préparer une recette, retenez plutôt les questions qu’ils soulèvent : l’assistant signale-t-il un outil indisponible ? Respecte-t-il un refus ? Cherche-t-il une autre voie pour obtenir un résultat interdit ?
Faites échouer une recherche dans l’environnement de test et contrôlez que la réponse ne présente pas une vérification imaginaire. Bloquez une opération puis observez les éventuelles nouvelles tentatives. Les droits effectifs doivent empêcher un effet non autorisé, même si le modèle le propose. La journalisation décrite dans le guide sur l’observabilité des systèmes IA doit permettre de retrouver l’événement et son traitement.
Le responsable du pilote doit aussi définir la réponse attendue face à une consigne contradictoire découverte dans un document. Préparez un cas où cette consigne demande une action étrangère à la mission. L’acceptation exige de poursuivre seulement le travail autorisé, ou de s’arrêter avec une explication exploitable lorsque le conflit ne peut pas être résolu.
Comment décider du déploiement et revenir en arrière ?
La décision doit préciser quelles tâches passent sur GPT-6.1 Sol, quelles exceptions restent exclues et comment revenir à la configuration précédente sans perdre les dossiers. La comparaison peut conclure à un usage limité, à un essai supplémentaire ou à un maintien du système actuel.
Avant une bascule, nommez un responsable métier, un responsable technique et les erreurs qui déclenchent une suspension. Préparez une procédure pour les travaux déjà commencés : qui les reprend, comment éviter les doublons et quelles actions doivent être vérifiées manuellement ? Un retour de configuration ne répare pas automatiquement les effets déjà produits dans une application.
Suivez le coût et la qualité par famille de tâches après l’ouverture du périmètre autorisé. Le simulateur de coût IA aide à cadrer les postes du budget ; ses estimations doivent ensuite être remplacées par les observations du pilote. Un audit IA peut organiser cette décision autour d’un jeu de tests, d’un plan de correction et de responsabilités explicites.
Le changement de modèle devient alors une modification contrôlée du service. Son intérêt se démontre par les livrables acceptés et les incidents évités ou correctement traités, sans déduire un gain métier d’une simple différence de prix unitaire.
Questions fréquentes
Quand OpenAI a-t-il annoncé GPT-6.1 Sol ?
GPT-6.1 Sol a été annoncé le 29 septembre 2026, date également portée par son addendum officiel de sûreté et retenue comme date du sujet. L’analyse et la vérification documentaire de cet article datent du 19 octobre 2026.
Le tarif de sortie est-il toujours de 10 dollars ?
Le tarif de sortie à 10 dollars par million de jetons correspond au mode Standard en contexte court et ne couvre pas toutes les configurations. Le tableau distingue le contexte long ; les autres modes exigent une vérification de leur tarification.
Peut-on remplacer directement le modèle d’un agent existant ?
Le remplacement doit être précédé d’une vérification des paramètres, des appels d’outils, des résultats structurés et des erreurs sur les tâches du système existant. Une réponse textuelle réussie ne constitue pas une recette complète.
Quel indicateur économique faut-il présenter à la direction ?
La direction doit disposer d’un coût complet par travail accepté qui inclut les appels, les outils, les reprises et la validation humaine nécessaire. La comparaison conserve le même périmètre de calcul et les mêmes exigences de qualité.
Une meilleure évaluation de sûreté permet-elle de supprimer les validations ?
Une évaluation de sûreté ne dispense pas de contrôler les autorisations et les effets externes sur les opérations que l’entreprise juge sensibles ou engageantes. Les résultats de l’éditeur éclairent les tests à mener ; ils ne remplacent pas leur exécution.
Cet article garantit-il une économie après migration ?
Cet article ne garantit aucune économie et ne rapporte aucune migration mesurée ; il propose un protocole pour établir le compromis sur les tâches retenues. Le gain éventuel dépend des résultats acceptés et de la dépense effectivement constatée.
Sources
- OpenAI, annonce de GPT-6.1 Sol, 29 septembre 2026.
- OpenAI, fiche API GPT-6.1 Sol, vérifiée le 19 octobre 2026.
- OpenAI, tarification API, vérifiée le 19 octobre 2026.
- OpenAI Deployment Safety Hub, addendum GPT-6.1 Sol, 29 septembre 2026.
- OpenAI, bonnes pratiques d’évaluation, vérifiées le 19 octobre 2026.
Analyse et méthode proposées par Anand Candassamy au 19 octobre 2026.