Qu’est-ce qu’une grille pour juger un projet d’IA en cinq minutes ?
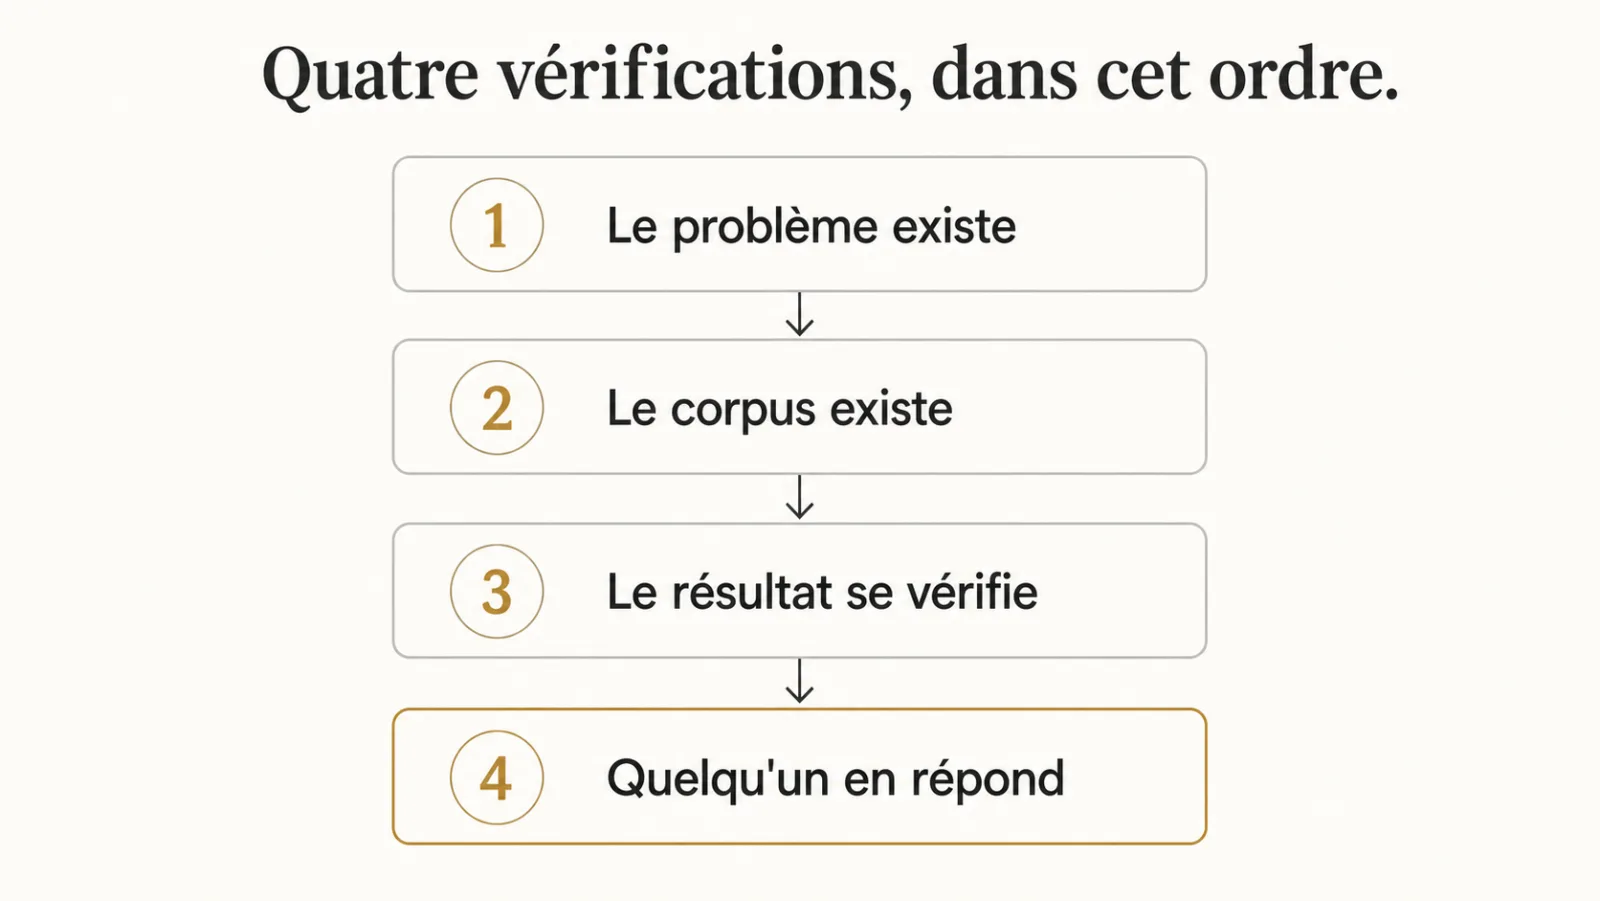
Une grille pour juger un projet d’IA en cinq minutes est une suite ordonnée de quatre vérifications, problème, corpus, vérifiabilité et responsable, qui permet d’écarter rapidement les projets qui ne peuvent pas aboutir.
Elle ne note pas, elle filtre. Chaque question examine une condition de préparation ou une dépendance à résoudre avant le prochain jalon. Si une condition manque, il est inutile de poursuivre l’examen : le projet n’est pas mauvais, il n’est pas prêt.
Elle sert dans trois situations : un jury de programme d’innovation, un comité qui arbitre entre projets internes, et la première réunion de cadrage d’une mission. Dans les trois cas, le temps disponible est court et la décision porte sur la suite à donner.
Pourquoi utiliser une grille, et pourquoi dans cet ordre ?
L’ordre des questions permet de vérifier d’abord le besoin, puis les données, la mesure et la responsabilité, afin d’identifier rapidement ce qui manque à la préparation.
J’ai construit cette grille en siégeant dans des jurys de programmes d’innovation, et je m’en sers en cadrage de mission. Elle organise une conversation courte, pas une décision d’investissement complète.
La première question révèle les projets qui commencent par une solution sans description du travail réel. Je ne conserve pas la proportion de dossiers écartés : elle n’est pas établie par une mesure vérifiable. Le livrable utile est la prochaine étape du porteur.
Le problème existe-t-il sans l’IA ?
Un projet doit décrire un problème observé avant de choisir l’IA, avec les personnes concernées, le travail actuel et les conséquences qui justifient de chercher une amélioration.
« Nous voulons un agent qui... » décrit un moyen. La reformulation utile demande qui fait quoi, à quelle fréquence et avec quelle difficulté. Si ces informations manquent, je propose une observation du travail avant de discuter du modèle.
Un besoin peut être exploratoire. Il faut alors écrire l’incertitude que le projet doit réduire, au lieu de promettre une économie déjà acquise.
Cette question rejoint le tri des cas d’usage. Elle ne condamne pas une idée ; elle distingue une demande préparée d’un projet encore à construire.
Les données, la mesure et le responsable sont-ils identifiés ?
Après le besoin, je vérifie les données disponibles, les moyens de juger les résultats et la personne responsable, pour rendre visibles les conditions du prochain essai.
- Le corpus existe-t-il ? Sur quels documents, dans quel état, et qui sait dire lesquels font autorité. Voir le corpus est le projet.
- Le résultat se vérifie-t-il ? Sait-on dire, à la fin, si c’est juste, et par quel moyen : une citation, un test, une comparaison avec une référence.
- Quelqu’un en répond-il ? Une personne nommée, qui accepte les conséquences des actions du système.
- Et une cinquième, hors grille : le porteur sait-il ce qu’il abandonne ? Un projet qui vise tout ne livre rien.
À quoi reconnaître une bonne et une mauvaise réponse à chaque question ?
Pour chaque vérification de la grille, une bonne réponse est précise, observable et nominative, tandis qu’une mauvaise réponse reste générale, future ou collective.
| Vérification | Réponse qui passe | Réponse qui alerte |
|---|---|---|
| Le problème existe-t-il sans l’IA ? | « L’équipe support traite chaque jour des demandes répétitives, chacune prend un temps mesuré » | « Nous voulons un agent intelligent pour le support » |
| Le corpus existe-t-il ? | « Les procédures sont dans un outil, la version en vigueur est identifiée » | « Les documents sont un peu partout, on les rassemblera » |
| Le résultat se vérifie-t-il ? | « Chaque réponse cite sa source, et nous avons des questions de référence » | « Les utilisateurs nous diront s’ils sont satisfaits » |
| Quelqu’un en répond-il ? | « La responsable du service valide le périmètre et signe » | « L’équipe projet, collectivement » |
Ces exemples hypothétiques servent aussi au porteur : il lui montre ce qu’il doit préparer avant de revenir. La troisième ligne rejoint un constat plus large, développé dans mesurer l’adoption, pas la satisfaction : une enquête de satisfaction n’est pas une mesure de justesse.
Qu’est-ce que le critère de vérifiabilité écarte ?
Un projet dont personne ne sait dire si le résultat est bon ne peut ni être amélioré, ni être défendu, ni être arrêté. C’est le critère le plus discriminant après le problème.
Les cas concernés se ressemblent : produire une synthèse « de qualité », rédiger un contenu « pertinent », faire des recommandations « adaptées ». Aucun de ces adjectifs ne se mesure.
Sur les missions que j’ai menées, mon constat est le suivant : La question à poser est directe : dans six mois, comment saurez-vous que ça marche ? Une réponse en termes de satisfaction est insuffisante, parce qu’une enquête de satisfaction est toujours bonne.
Le critère se transforme d’ailleurs en livrable : c’est le jeu de tests, dont la constitution est décrite dans construire un jeu de tests en une journée, et qui devrait exister avant le système.
Pourquoi exiger qu’une personne nommée réponde du système ?
Exiger qu’une personne nommée réponde du système permet de vérifier qui accepte les conséquences de ses résultats, valide son périmètre et peut décider de l’arrêter.
Un projet porté « par l’équipe » ou « par la direction » n’a pas de responsable au sens utile. Personne ne tranchera quand le système produira une réponse contestable, et personne n’aura l’autorité de restreindre ce qu’il fait.
Ce critère rejoint la ligne tracée dans ce qu’on ne délègue jamais à un modèle : ce qui affecte une personne ou engage l’organisation doit avoir un répondant humain. Son absence est l’une des causes décrites dans l’anatomie d’un PoC qui ne passe jamais.
Un nom ne suffit toutefois pas : cette personne doit disposer de l’information, du temps et de l’autorité nécessaires. Les décisions qui dépassent son mandat doivent avoir une voie d’escalade.
Comment se déroulent concrètement les cinq minutes ?
Les cinq minutes se répartissent en quatre questions posées dans l’ordre, chacune arrêtant l’examen si la réponse manque, puis une conclusion formulée comme une marche à suivre.
- Demander la reformulation sans le mot IA. Qui fait quoi aujourd’hui, combien de fois, à quel coût. Si la réponse ne vient pas, conclure sur l’observation du travail réel.
- Demander les documents. Où sont-ils, dans quel état, qui désigne la version qui fait foi.
- Demander la mesure. Comment saura-t-on, dans six mois, que le système fonctionne ?
- Demander un nom. Qui valide le périmètre et répond des résultats ?
- Conclure par l’étape suivante. Ce qui manque, et ce qu’il faut préparer pour revenir.
Cette séquence vaut aussi pour juger un prototype produit en quelques jours, situation décrite dans ce qu’un hackathon révèle du niveau réel. Elle structure le premier entretien d’un audit IA.
Que ne dit pas la grille et que faut-il examiner ensuite ?
La grille ne juge pas à elle seule l’ambition, la valeur économique ou la qualité de l’équipe, ce qui demande un examen complémentaire après les premières vérifications.
Un projet peut décrire un problème réel et disposer de données sans apporter un gain intéressant. Il faut encore comparer la solution proposée au fonctionnement actuel et aux alternatives plus simples.
À l’inverse, un projet peut viser à créer un corpus ou à explorer une faisabilité. L’absence de données prêtes n’impose pas un rejet, mais un jalon explicite pour résoudre cette dépendance.
Je présente donc la grille comme un filtre de préparation. Elle ne remplace pas l’étude des droits d’accès, de la sécurité, des coûts, des personnes affectées ou du cadre juridique. La suite doit être proportionnée au projet.
Sur les missions que j’ai menées, mon constat est le suivant : Quatre vérifications suffisent. La première élimine environ la moitié des dossiers, ce qui n’est pas un jugement de valeur sur les porteurs : c’est le signe que le travail de problème n’a pas encore été fait.
Quelle question poser si le temps manque pour toute la grille ?
Si le temps manque, je demande comment le porteur saura que le projet a réussi, puis quels éléments concrets permettront de soutenir cette conclusion à l’échéance choisie.
« Dans six mois, comment saurez-vous que ça a marché ? » Une réponse précise indique que le problème, le corpus et la vérifiabilité ont été pensés. Une réponse vague indique qu’aucun des trois ne l’a été.
Comment utiliser la grille en interne sans braquer les porteurs ?
Elle sert autant à arbitrer entre projets internes qu’à juger des candidatures externes, et l’exercice est plus difficile en interne. La raison est politique.
En jury, écarter un projet n’a pas de conséquence sur les relations de travail. En interne, dire qu’un projet porté par une direction ne passe pas la première question demande de la forme.
La forme qui fonctionne consiste à poser les quatre questions comme une aide à la préparation, pas comme un verdict. Un porteur qui répond lui-même « je ne sais pas dire si c’est juste » arrive à la conclusion sans qu’on la lui impose.
Cette approche déplace la conversation de l’arbitrage vers la construction, et c’est ce qui rend le refus acceptable, comme développé dans combien de cas d’usage faut-il abandonner.
Quelles erreurs commettent les évaluateurs de projets d’IA ?
Les erreurs des évaluateurs de projets d’IA consistent le plus souvent à se laisser guider par la démonstration, par la technologie annoncée ou par le prestige du porteur, au lieu de vérifier les quatre conditions.
- Juger sur la démonstration. Une démonstration réussie montre que le cas favorable fonctionne, pas que le problème existe ni que le résultat se vérifie.
- Commencer par la technologie. Discuter du modèle ou de l’architecture avant le problème donne une légitimité à une solution sans besoin.
- Noter au lieu de filtrer. Une moyenne pondérée laisse passer un projet excellent sur trois critères et nul sur le quatrième, alors que ce quatrième suffit à le faire échouer.
- Confondre ambition et préparation. Un projet très ambitieux peut être prématuré ; le dire n’est pas le juger.
- Oublier la question de l’abandon. Un porteur qui ne sait pas ce qu’il renonce à faire n’a pas encore délimité son projet.
Quelles questions fréquentes se poser pour évaluer un projet ?
Quelle est la première question à poser ?
Le problème existe-t-il sans l’IA ; Un projet qui commence par la solution décrit un moyen, pas un besoin; Reformulé sans le mot IA, il ne reste souvent rien.
Quelles sont les quatre questions de la grille ?
Le problème existe-t-il sans l’IA, le corpus existe-t-il, le résultat se vérifie-t-il, et quelqu’un en répond-il; Elles se posent dans cet ordre, et une réponse manquante suffit à arrêter l’examen.
Pourquoi la vérifiabilité est-elle si discriminante ?
Parce qu’un projet dont personne ne sait dire si le résultat est bon ne peut être ni amélioré, ni défendu, ni arrêté. Les adjectifs comme « pertinent » ou « de qualité » ne se mesurent pas.
La grille juge-t-elle l’ambition d’un projet ?
La grille examine d’abord la préparation, sans mesurer toute l’ambition ni la valeur économique, ce qui laisse un travail complémentaire pour comparer les projets et leurs alternatives. Elle ne constitue pas un score complet.
Comment l’utiliser en interne sans braquer ?
En posant les quatre questions comme une aide à la préparation, pas comme un verdict; Un porteur qui répond lui-même arrive à la conclusion sans qu’on la lui impose.
Que faire d’un projet qui échoue à la première question ?
Le renvoyer à l’observation du travail réel, sans le condamner; Le porteur revient avec une phrase précise : qui fait quoi aujourd’hui, combien de fois, à quel coût. Le projet est alors examiné sur les trois autres questions.