Qu’est-ce qu’une licence de modèle ouvert ?
Une licence de modèle ouvert est le contrat qui fixe ce qu’on a le droit de faire avec les poids d’un modèle téléchargeable : l’exécuter, le modifier, le livrer à d’autres. Elle est distincte du modèle lui-même. Deux modèles de qualité identique peuvent avoir des valeurs opposées pour une entreprise selon ce que leur licence autorise.
Trois notions sont souvent confondues. Les poids sont les paramètres appris pendant l’entraînement ; les publier permet de faire tourner le modèle sur son propre matériel. Le code d’inférence est le logiciel qui exécute ces poids, souvent sous une licence classique. La licence des poids est le texte qui encadre leur usage, et c’est elle qui décide.
« Ouvert » ne veut donc pas dire « libre ». Un modèle peut être téléchargeable tout en étant réservé à la recherche, limité à certains usages ou interdit au-delà d’une certaine taille d’entreprise. L’étiquette ne dit rien ; seul le texte de la licence fait foi.
Pourquoi la licence de Llama 2 compte-t-elle plus que ses performances ?
Llama 2 est publié avec ses poids et une licence autorisant l’usage commercial, ce qui n’était pas le cas de la génération précédente, réservée à la recherche. C’est cette clause, et non le score du modèle, qui change les décisions d’architecture.
Un modèle dont les poids sont téléchargeables mais dont la licence interdit l’usage commercial n’a aucune valeur pour une entreprise : il sert à la recherche et à la démonstration, pas à la production. Le passage à une licence commerciale fait entrer une nouvelle option dans l’arbitrage, celle du modèle hébergé sur son propre matériel.
Cette option n’était pas ouverte jusqu’ici, quel que soit le niveau technique de l’équipe. Elle l’est désormais, et elle change la nature de la conversation avec une direction juridique ou un responsable de la sécurité, en particulier sur la question de ce qu’on a le droit de mettre dans un prompt quand le modèle est hébergé ailleurs.
Quels sont les trois droits à vérifier dans une licence de modèle ?
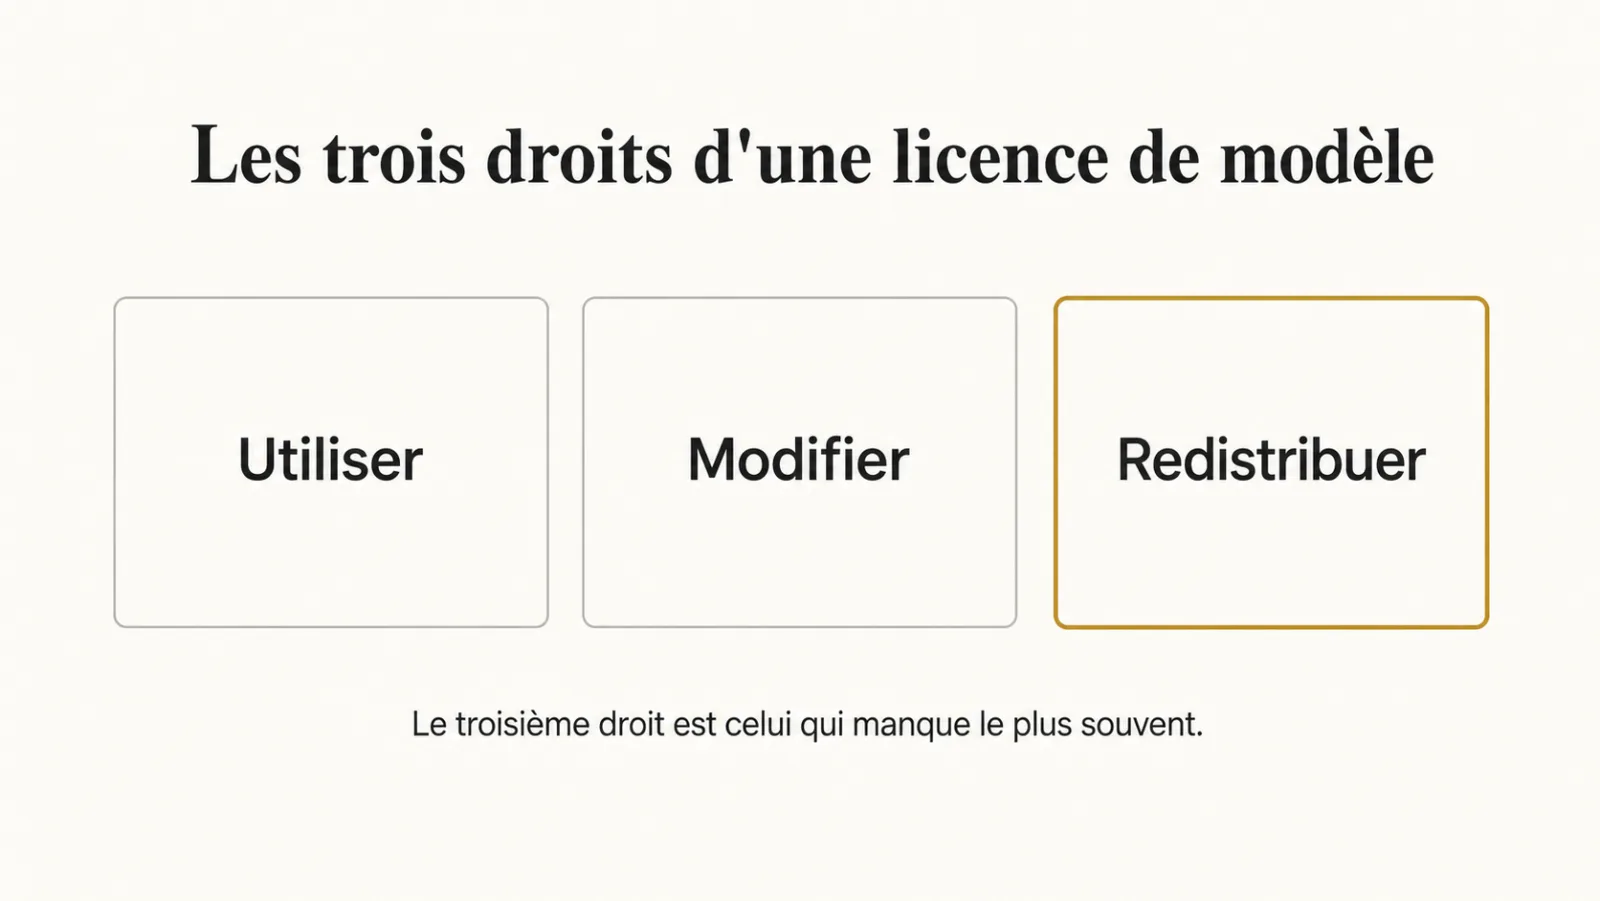
Une licence de modèle accorde ou refuse séparément trois droits distincts : utiliser le modèle, le modifier par réglage fin, et le redistribuer à des tiers. Confondre les trois est l’erreur la plus fréquente, et elle se paie tard.
Le droit d’utiliser permet de faire tourner le modèle pour son propre compte. C’est le minimum, et c’est souvent tout ce qui est réellement accordé sous l’étiquette « ouvert ».
Le droit de modifier permet le réglage fin sur ses propres données. Il conditionne toute stratégie de spécialisation, et il s’accompagne parfois d’obligations : publier les modifications, mentionner l’origine, ne pas entraîner un modèle concurrent.
Le droit de redistribuer permet de livrer le modèle à un tiers : un client, une filiale, un partenaire. C’est celui qui manque le plus souvent, et c’est un problème pour tout éditeur de logiciel qui voudrait embarquer le modèle dans son produit.
À cela s’ajoutent des restrictions moins visibles : seuils d’utilisateurs actifs au-delà desquels la licence ne s’applique plus, usages interdits, obligations de nommage.
| Droit | Ce qu’il permet | Question à poser | Conséquence s’il manque |
|---|---|---|---|
| Utiliser | Exécuter le modèle pour son propre compte | L’usage commercial est-il autorisé, et sans seuil bloquant ? | Le modèle reste un objet de démonstration |
| Modifier | Régler le modèle sur ses données | Quelles obligations accompagnent les versions modifiées ? | Aucune spécialisation possible |
| Redistribuer | Livrer le modèle à un client ou une filiale | Peut-on l’embarquer dans un produit vendu ? | L’architecture ne peut pas en dépendre |
Ce que l’auto-hébergement change réellement
- Les données ne quittent plus l’infrastructure. C’est l’argument décisif dans la santé, la défense et le secteur public, et il ne se remplace pas par une clause contractuelle.
- Le coût devient fixe au lieu d’être variable. Un serveur amorti coûte le même prix à mille ou à cent mille requêtes, ce qui inverse complètement le calcul au-delà d’un certain volume. Voir modèles ouverts et souveraineté.
- Le modèle ne change plus sans prévenir. Une version figée reste identique, ce qui supprime la classe de problèmes décrite dans le jour où le modèle a changé sans prévenir.
- La charge d’exploitation devient interne. Mise à jour, supervision, capacité, incidents : tout ce que le fournisseur assurait devient une responsabilité d’équipe.
Combien coûte réellement l’auto-hébergement d’un modèle ouvert ?
L’auto-hébergement d’un modèle ouvert devient rentable au-delà d’un volume précis, et ce volume est plus élevé que ne l’estiment la plupart des équipes. L’erreur classique consiste à comparer le prix d’un serveur au prix des appels API, en oubliant tout le reste.
Ce qu’il faut ajouter du côté interne : le temps d’ingénierie pour la mise en service, la supervision permanente, la capacité à absorber les pointes, la redondance si le service est critique, et le coût de la montée de version quand un meilleur modèle sort. Ces postes représentent en général davantage que le matériel.
Ce qu’il faut ajouter du côté API : rien de caché, mais un risque de dépendance et une exposition à des changements de tarif ou de disponibilité.
| Poste | API d’un fournisseur | Modèle ouvert auto-hébergé |
|---|---|---|
| Coût | Variable, proportionnel à l’usage | Fixe, indépendant du volume |
| Localisation des données | Chez le fournisseur | Dans l’infrastructure interne |
| Stabilité de la version | Décidée par le fournisseur | Décidée par l’équipe |
| Supervision et incidents | Assurées par le fournisseur | À la charge de l’équipe |
| Montée de version | Immédiate, parfois imposée | Projet à mener à chaque fois |
| Dépendance | Au fournisseur et à son tarif | Aux compétences internes |
Ma recommandation reste la même : commencer par une API derrière une couche d’abstraction, mesurer trois mois, puis rejouer le calcul avec des chiffres constatés. Cette couche est précisément ce qui rend le modèle remplaçable, comme le montre Amazon Bedrock, la couche qui rend le modèle remplaçable.
La question à poser à votre direction juridique
« Avons-nous le droit de livrer ce modèle à un client, dans notre produit ? » Si la réponse est non, l’architecture ne doit pas dépendre de ce modèle en particulier, et la couche d’abstraction devient obligatoire, pas optionnelle.
Comment vérifier une licence de modèle avant de bâtir dessus ?
Vérifier une licence de modèle avant de bâtir dessus demande une lecture structurée en cinq étapes, menée conjointement par l’équipe technique et la direction juridique. Elle prend quelques heures et évite de découvrir une impossibilité au moment de livrer.
- Décrire l’usage visé en une phrase : usage interne, service rendu à des clients, modèle embarqué dans un produit livré. Chaque cas mobilise des droits différents.
- Lire la licence des poids, pas la page de présentation ni le dépôt de code. Repérer les trois droits et noter, pour chacun, s’il est accordé, restreint ou absent.
- Relever les clauses conditionnelles : seuils d’utilisateurs, liste d’usages interdits, obligations de mention, restrictions sur l’utilisation des sorties du modèle pour en entraîner d’autres.
- Confronter ces clauses à la trajectoire, pas seulement à la situation actuelle. Un usage interne aujourd’hui peut devenir une offre client dans un an.
- Consigner la décision dans le dossier d’architecture, avec la version exacte de la licence lue. Une licence peut évoluer entre deux versions d’un même modèle.
Si l’une de ces étapes laisse un doute, la réponse prudente est la même que pour le droit de redistribuer : ne pas rendre l’architecture dépendante de ce modèle. Ce travail de lecture fait partie de ce qu’examine un audit IA avant tout choix structurant.
Quelles erreurs fréquentes faut-il éviter avec un modèle ouvert ?
Les erreurs fréquentes avec un modèle ouvert consistent à le traiter comme gratuit, comme libre ou comme définitif, alors qu’il n’est rien de tout cela. Chacune repose sur une confusion simple.
- Croire qu’ouvert signifie gratuit. Les poids sont gratuits ; l’exploitation ne l’est pas. Le coût se déplace de la facture du fournisseur vers le budget d’équipe.
- Croire qu’ouvert signifie libre. Une licence peut autoriser l’usage commercial tout en restreignant la redistribution ou en fixant des seuils.
- Régler finement par réflexe. Sur la plupart des usages documentaires, une bonne récupération donne de meilleurs résultats, pour un coût moindre. C’est l’argument de RAG, la seule architecture qui tienne.
- Coder directement contre un modèle. Sans couche d’abstraction, changer de modèle revient à réécrire l’application.
- Choisir sur un classement public. Un score général ne dit rien de la tâche précise ; seul un jeu de tests construit sur ses propres cas tranche.
Que va changer Llama 2 dans les deux années suivantes ?
Avec Llama 2, l’écart entre modèles fermés et modèles ouverts va se réduire, et le choix entre les deux deviendra un arbitrage ordinaire plutôt qu’un renoncement. C’est déjà perceptible sur les tâches structurées : extraction, classification, reformulation.
Sur ces tâches, un modèle ouvert de taille moyenne fait le travail à une fraction du coût. Sur le raisonnement complexe et les contextes très longs, l’écart reste net et le restera un certain temps.
La conséquence pratique est le routage : petit modèle ouvert pour le volume, grand modèle fermé pour les cas difficiles. Ce réglage suppose une couche d’abstraction et un jeu de tests, faute de quoi personne ne saura quelle tâche relève de quel modèle. C’est le chaînon décrit dans l’évaluation continue.
Questions fréquentes
Un modèle « ouvert » est-il un modèle libre ?
Rarement. La plupart des licences dites ouvertes accordent l’usage et la modification, mais restreignent la redistribution, interdisent certains usages ou imposent des seuils d’utilisateurs. Il faut lire la licence, pas l’étiquette.
Peut-on utiliser Llama 2 dans un produit commercial ?
La licence de Llama 2 autorise l’usage commercial, ce qui le distingue de la génération précédente. Elle comporte toutefois des conditions, notamment un seuil d’utilisateurs actifs et une liste d’usages interdits. Il faut vérifier ces clauses au regard de l’usage visé et de sa trajectoire.
À partir de quel volume l’auto-hébergement devient-il rentable ?
Le seuil dépend du modèle et du matériel, mais il est toujours plus élevé qu’estimé, parce que le calcul oublie la supervision, la redondance et la montée de version. Il faut mesurer trois mois d’usage réel avant de trancher.
Peut-on combiner modèle ouvert et modèle propriétaire ?
Oui, et c’est souvent la configuration la plus économique : un modèle ouvert pour les tâches structurées à fort volume, un modèle propriétaire pour le raisonnement complexe. Cela suppose une couche d’abstraction commune et un jeu de tests pour répartir les tâches.
Le réglage fin est-il nécessaire sur un modèle ouvert ?
Pas systématiquement. Sur la plupart des usages documentaires, une bonne récupération donne de meilleurs résultats qu’un réglage fin, pour un coût très inférieur et une maintenance beaucoup plus simple. Le réglage fin se justifie surtout pour imposer un format ou un style constant.
Pourquoi héberger soi-même un modèle plutôt qu’utiliser une API ?
Pour garder les données dans son infrastructure, figer la version du modèle et transformer un coût variable en coût fixe. En contrepartie, l’exploitation devient une charge interne. Le choix se justifie d’abord par la confidentialité, ensuite par le volume.