Que change la publication de Llama 3.1 405B pour les modèles ouverts ?
La publication de Llama 3.1 405B, que Meta présente comme compétitif avec les meilleurs modèles propriétaires, déplace le débat de la capacité des modèles ouverts vers leur exploitation. Le second débat est plus difficile que le premier.
Un modèle à poids ouverts est un modèle dont les paramètres sont publiés et téléchargeables : on peut le faire tourner sur sa propre infrastructure, sans passer par l’API d’un fournisseur. Les conditions d’utilisation sont décrites par la licence Llama 3.1 datée du 23 juillet 2024. Télécharger les poids ne fournit pas le service qui les rend utilisables.
La comparaison publiée le 23 juillet 2024 avec GPT-4, GPT-4o et Claude 3.5 Sonnet vient de Meta, et elle reste à vérifier sur ses propres tâches. Mais elle suffit à changer la nature de la discussion. Pendant deux ans, l’argument contre les modèles ouverts était la qualité. Cet argument s’affaiblit. Celui qui le remplace est moins commode à traiter parce qu’il ne porte pas sur une caractéristique du modèle mais sur une capacité de l’organisation.
La question devient : qui fait tourner ce modèle, tous les jours, pendant trois ans. Elle n’a pas de réponse technique.
Quelles charges d’exploitation la publication des poids ne couvre-t-elle pas ?
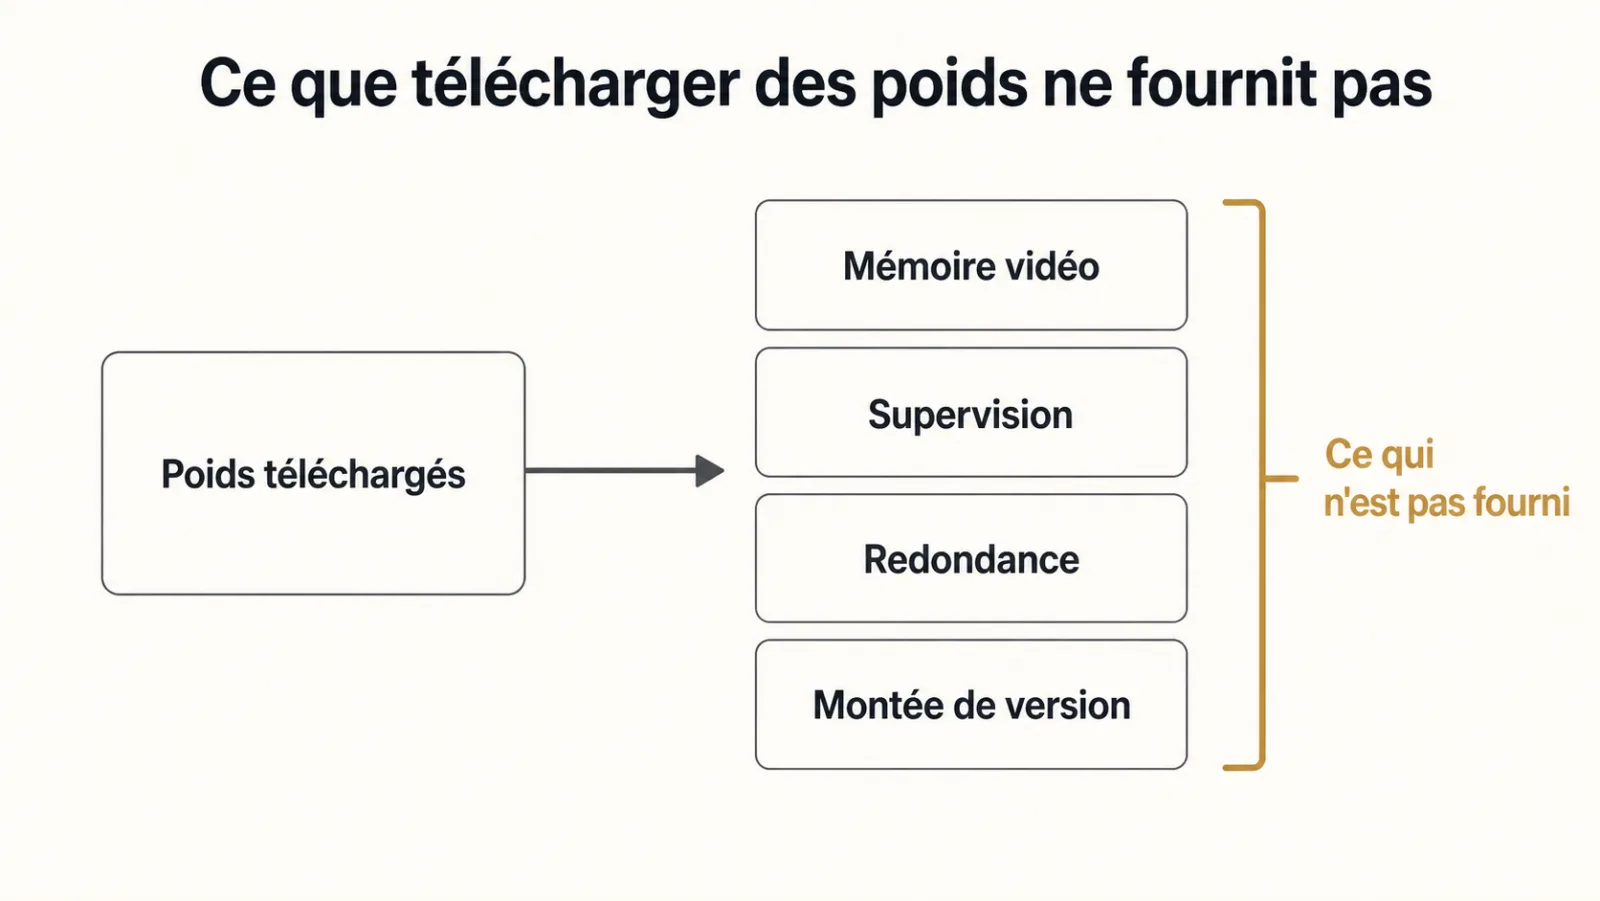
La publication des poids ne couvre ni la mémoire vidéo, ni la supervision, ni la redondance, ni la montée de version, quatre charges dont le coût dépend du niveau de service et de la charge attendue. Elles doivent figurer dans la comparaison au même titre que les appels API.
La mémoire vient en premier et c’est la seule qu’on chiffre correctement : un modèle de cette taille demande une infrastructure de centre de données, un dimensionnement qui dépend de la précision, du contexte et des requêtes simultanées.
La supervision est permanente. Quelqu’un doit surveiller la disponibilité, diagnostiquer les ralentissements, gérer la saturation aux heures de pointe. Ce n’est pas un projet, c’est une astreinte.
La redondance conditionne la criticité. Un service dont l’organisation dépend ne peut pas reposer sur une machine unique, ce qui ajoute une capacité de secours à dimensionner.
La montée de version, enfin, doit être préparée selon les versions réellement retenues. Le raisonnement complet figure dans modèles ouverts et souveraineté.
| Charge | Ce qu’elle recouvre | Visible dans la comparaison de tarifs ? |
|---|---|---|
| Mémoire vidéo | Matériel de centre de données pour faire tourner le modèle | À dimensionner explicitement |
| Supervision | Disponibilité, ralentissements, saturation, astreinte | À ajouter au coût complet |
| Redondance | Une seconde infrastructure pour ne pas dépendre d’une machine | Non |
| Montée de version | Tester, migrer et revalider chaque nouvelle version | Non |
Dans quels cas envisager l’hébergement interne de Llama 3.1 ?
L’hébergement interne mérite d’être étudié lorsque les contraintes de données, la stabilité attendue et le volume justifient un service que l’organisation sait effectivement exploiter et maintenir.
- Quand les données ne peuvent pas sortir, pour une raison réglementaire ou contractuelle. C’est l’argument décisif, et le seul qui ne se remplace pas.
- Quand le volume est très élevé et stable, ce qui amortit le matériel et la supervision sur un grand nombre d’appels.
- Quand la stabilité prime, un modèle figé ne changeant pas de comportement. Voir le jour où le modèle a changé sans prévenir.
- Quand l’équipe d’exploitation existe déjà et sait tenir un service critique. Sans elle, la décision est un vœu.
Comment décider d’héberger un modèle ouvert en interne, étape par étape ?
Décider d’héberger un modèle ouvert en interne demande de vérifier, dans l’ordre, la contrainte sur les données, la licence, la qualité sur ses propres tâches, le volume, puis l’existence d’une équipe d’exploitation. Si une étape échoue, la décision s’arrête là.
- Qualifier les données. Peuvent-elles sortir, sous quelles conditions contractuelles ? Si oui, l’argument principal de l’hébergement interne disparaît.
- Lire la licence. Un modèle ouvert n’autorise pas forcément tous les usages ; la licence compte autant que le modèle.
- Mesurer sur ses tâches. Rejouer son propre jeu de tests plutôt que de se fier aux comparaisons publiées par l’éditeur. L’écart dépend du type de tâche, comme l’a montré le resserrement observé avec Llama 3 sur les tâches structurées.
- Chiffrer le volume. Un volume faible ou irrégulier n’amortit ni le matériel ni l’astreinte.
- Nommer l’équipe d’exploitation. Des personnes identifiées, avec le temps prévu, pas une intention.
Cette séquence évite le cas le plus fréquent : un modèle téléchargé, installé, puis laissé sans maintenance. Des poids publiés ne sont pas des poids exploitables, comme le rappelait déjà le cas de Grok.
Quelle configuration fonctionne le mieux en pratique entre modèle hébergé et API ?
La configuration qui fonctionne le mieux en pratique consiste à héberger un modèle de taille moyenne pour les données protégées, et à recourir à une API pour l’analyse complexe sur le reste. Cette architecture mixte donne plus de souveraineté réelle qu’un projet d’hébergement ambitieux.
Le raisonnement est simple. Certaines tâches sur données sensibles sont structurées : extraction, classification, anonymisation, recherche documentaire. Il faut vérifier qu’un modèle plus petit respecte leur format et leur qualité sur le matériel disponible.
L’analyse complexe peut être confiée à une API si les contenus peuvent sortir, ou qui ont été préalablement anonymisés par le premier étage.
Cette configuration a un mérite supplémentaire : elle est réversible. Si le modèle interne s’avère insuffisant, on bascule ; si l’API devient trop chère, on internalise davantage. Elle suppose la couche d’abstraction décrite dans la couche qui rend le modèle remplaçable.
Qui doit assurer l’exploitation d’un modèle hébergé en interne ?
Une équipe identifiée doit assurer disponibilité, incidents et maintien de la configuration, avec un niveau de service explicite avant de décider l’hébergement interne d’un modèle.
« Qui sera d’astreinte sur ce modèle un dimanche de novembre ? » Si personne n’a de réponse, l’hébergement interne n’est pas décidé. Il est seulement souhaité, et la continuité du service reste sans responsable.
Que peut-on attendre des versions réduites d’un très grand modèle ouvert ?
Les versions réduites d’un très grand modèle ouvert, compressées ou distillées par la communauté, peuvent faciliter certains déploiements, sous réserve d’une validation distincte de leur qualité et de leurs conditions d’usage. Ce n’est pas une garantie sur des versions futures.
Un très grand modèle ouvert sert de matière première : il est compressé, distillé, spécialisé, et donne naissance à des modèles bien plus petits qui héritent d’une partie de ses capacités. Ce sont ceux-là que les organisations déploieront réellement.
La recommandation pratique en découle. Construire aujourd’hui une architecture réversible, avec un jeu de tests, permet d’adopter ces dérivés sans projet quand ils arriveront. Une architecture liée à un fournisseur devra être réécrite pour en profiter, ce qui revient en général à ne pas en profiter.
Pourquoi faut-il refaire le calcul hébergement contre API chaque semestre ?
Il faut refaire le calcul hébergement contre API chaque semestre parce que le seuil de rentabilité entre les deux se déplace régulièrement, dans les deux sens. Une revue périodique est une règle de pilotage, pas la preuve que le calcul précédent était faux.
Deux forces s’opposent. Les modèles ouverts deviennent plus capables à matériel constant, ce qui favorise l’internalisation. Les tarifs d’API et les conditions de service peuvent également évoluer, ce qui la défavorise.
La seule façon de tenir cette décision est de la rendre bon marché à reprendre : une couche d’abstraction, un jeu de tests, et un seuil de volume écrit à l’avance qui déclenche le réexamen. Voir construire un jeu de tests en une journée et, pour le rejouer à chaque changement, l’évaluation continue.
Quelles erreurs fréquentes commet-on en voulant héberger un grand modèle ouvert ?
Les erreurs fréquentes sont de comparer uniquement le prix du matériel au tarif d’une API, de croire la comparaison de l’éditeur sur parole, d’oublier la redondance et de confondre souveraineté et hébergement du plus gros modèle. Elles conduisent toutes à une décision prise sur un coût incomplet.
- Comparer matériel et tarif d’API. Trois des quatre charges disparaissent du calcul.
- Se fier aux évaluations publiées. Elles portent sur des tâches génériques, souvent en anglais, et viennent de l’éditeur.
- Viser le plus gros modèle par principe. Un modèle de taille moyenne couvre la plupart des traitements sensibles.
- Oublier la réversibilité. Sans couche d’abstraction, chaque changement de modèle devient un projet.
Avant de s’engager, un audit IA permet de qualifier les données, les volumes et les tâches, et de vérifier si l’hébergement interne répond à une contrainte réelle.
Quelles questions poser avant d’exploiter Llama 3.1 405B ?
Un modèle ouvert de pointe comme Llama 3.1 405B est-il utilisable par une PME ?
Une PME peut accéder à Llama 3.1 par un prestataire ou choisir une version plus petite, tandis qu’héberger les poids complets exige un dimensionnement adapté au niveau de service. Il faut comparer les options avant d’investir.
Que coûte réellement un modèle hébergé ?
Le coût complet inclut matériel, hébergement, surveillance, capacité de secours et travail de validation, sans fréquence universelle de migration ni règle sur le poids relatif de chaque poste.
Quelle configuration recommander en pratique ?
Un modèle de taille moyenne hébergé pour les données protégées, une API pour l’analyse complexe sur le reste ; Cette architecture mixte est réversible et donne plus de souveraineté réelle qu’un projet ambitieux inachevé.
Quand l’hébergement interne s’impose-t-il vraiment ?
Quand les données ne peuvent pas sortir pour une raison réglementaire ou contractuelle ; C’est le seul argument qui ne se remplace pas par une clause de contrat ou une baisse de tarif.
Llama 3.1 405B vaut-il vraiment les meilleurs modèles propriétaires ?
C’est ce qu’affirme Meta à partir de ses propres évaluations ; Pour une organisation, la seule comparaison qui compte est celle obtenue sur son propre jeu de tests, sur ses tâches et dans sa langue.
Que signifie un modèle à poids ouverts ?
C’est un modèle dont les paramètres sont publiés et téléchargeables, ce qui permet de le faire tourner sur sa propre infrastructure. Les conditions d’usage restent fixées par sa licence, et toute l’exploitation reste à la charge de celui qui l’héberge.