Qu’est-ce que la recherche hybride ?
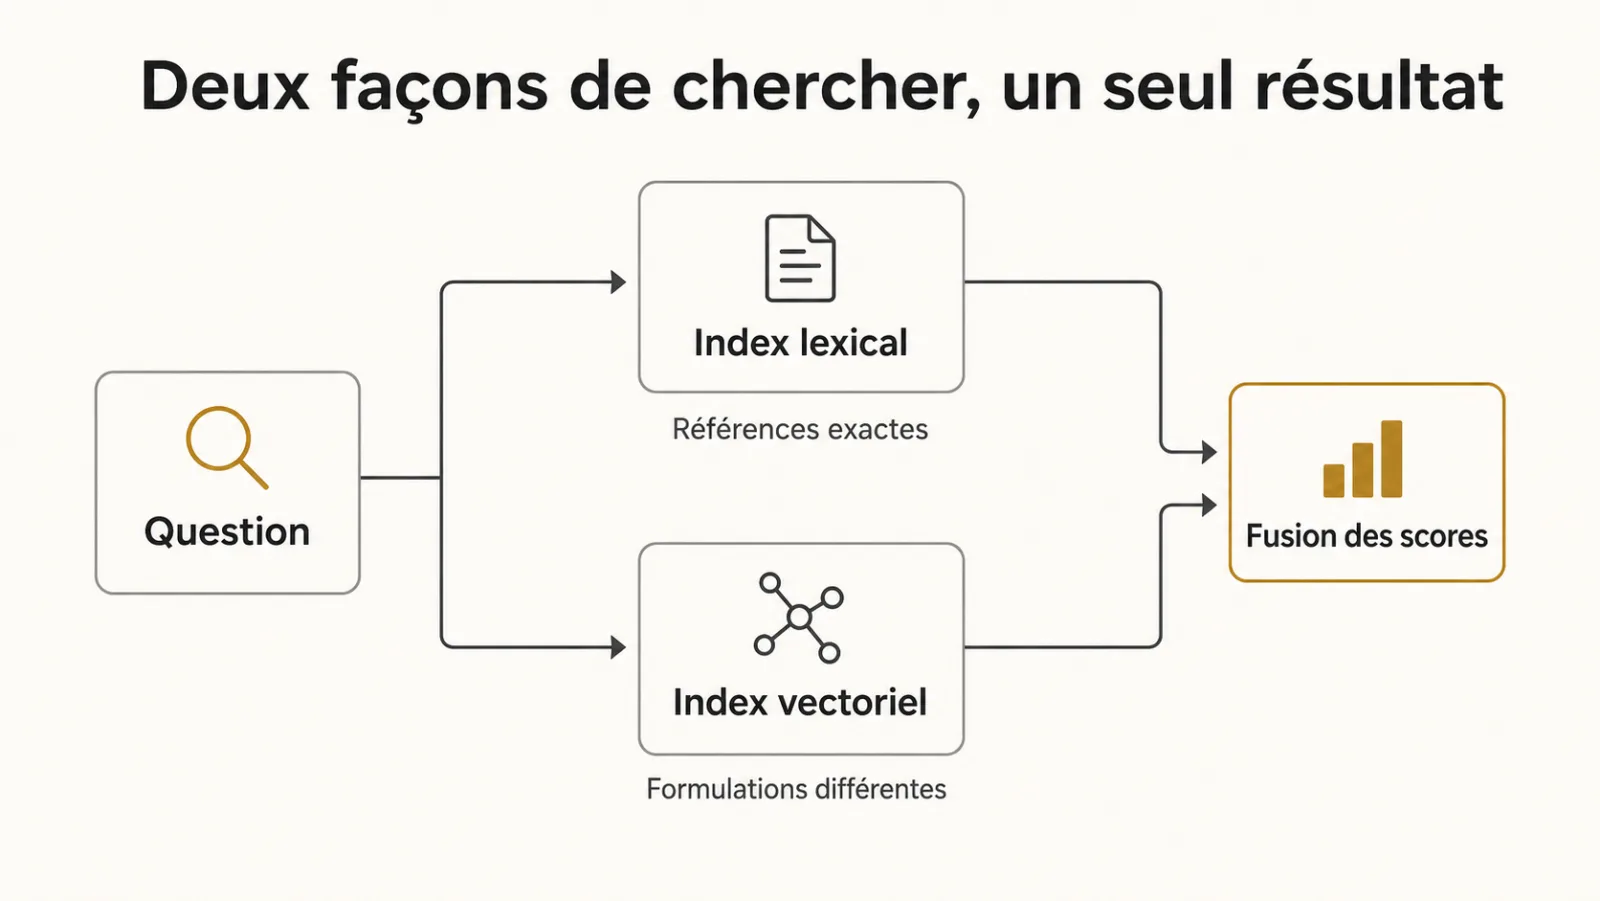
La recherche hybride est une méthode de récupération documentaire qui interroge en parallèle un index lexical, fondé sur les mots exacts, et un index vectoriel, fondé sur le sens, puis fusionne les deux listes de résultats.
Dans un système qui répond à partir de documents, l’architecture dite RAG décrite dans la seule architecture qui tienne, la qualité de la réponse dépend d’abord des passages retrouvés. Deux familles de recherche coexistent pour cela.
La recherche lexicale, dont l’algorithme le plus courant s’appelle BM25, classe les passages selon les mots qu’ils partagent avec la question. La recherche vectorielle transforme question et passages en vecteurs numériques, les embeddings, et classe les passages par proximité de sens ; son principe est expliqué dans les embeddings expliqués à une direction. La recherche hybride additionne leurs forces et compense leurs angles morts.
Quel défaut la recherche vectorielle ne voit-elle pas ?
La recherche vectorielle peut confondre des références proches parce qu’elle privilégie des représentations de sens, ce qui demande de tester séparément les identifiants et les correspondances exactes.
Un utilisateur peut demander une clause précise et recevoir un passage voisin qui parle du même sujet. La réponse devient plausible sans être fondée sur la bonne référence.
Je vérifie ce risque sur les codes, les numéros d’articles et les identifiants du domaine. Il n’affecte pas systématiquement tous les modèles d’embeddings ni toutes les requêtes. Le comportement dépend des textes, de l’index et des filtres.
L’échec se diagnostique avant la génération : quel passage a réellement été retrouvé ? Augmenter la fluidité de la réponse ne corrige pas une référence erronée.
Quel est le défaut symétrique de la recherche par mots-clés ?
La recherche lexicale peut manquer une réponse lorsque la question et le document utilisent des formulations différentes, sans correspondance suffisante entre leurs termes et leurs variantes. C’est le défaut inverse, connu depuis longtemps et tout aussi bloquant.
Un document parle de « résiliation anticipée », l’utilisateur demande « comment arrêter le contrat avant la fin ». La correspondance dépend alors des variantes, de l’analyse linguistique et de l’index. C’est précisément ce que la recherche vectorielle a résolu, et c’est pourquoi elle s’est imposée.
Les deux méthodes présentent des forces complémentaires, sans couvrir automatiquement tous les échecs. Combiner les deux ne relève pas du raffinement : c’est la configuration par défaut qui aurait dû être adoptée dès le départ, et elle est absente de la majorité des systèmes que je reprends.
Le gain est net sur les corpus qui contiennent des références numérotées, réglementaires, contractuelles ou techniques. Une mesure publiée en 2024, publiée par Anthropic en septembre 2024, fait état de 49 % d’échecs de récupération en moins, mais pour une combinaison où l’index lexical et les embeddings sont tous deux enrichis d’un contexte propre à chaque passage ; un simple ajout d’index lexical ne garantit pas ce chiffre. La qualité du découpage reste déterminante, comme le montre découper un document.
Quelle méthode de recherche choisir selon le type de question ?
Le choix entre recherche lexicale, vectorielle et hybride dépend de la forme des questions réellement posées, et la plupart des corpus d’entreprise reçoivent les deux formes à la fois.
| Type de question | Lexicale seule | Vectorielle seule | Hybride |
|---|---|---|---|
| « Que dit l’article 12.3 ? » | Candidat naturel à tester | Risque de référence voisine | Correspondance à contrôler |
| « Comment arrêter le contrat avant la fin ? » | Dépend des variantes | Similarité à vérifier | Couverture à mesurer |
| Code produit ou numéro de dossier | Exactitude à tester | Similarité parfois insuffisante | Exactitude à préserver |
| Question vague sur un thème | Correspondances lexicales | Similarité thématique | Complémentarité à mesurer |
| Sigle interne ou jargon maison | Correspondance possible | Dépend du modèle | Sigle à vérifier |
La lecture du tableau est simple : dès qu’un corpus mélange références exactes et questions formulées librement, l’hybride mérite une comparaison avec les méthodes seules.
Comment fusionner des résultats lexicaux et vectoriels ?
Les résultats lexicaux et vectoriels peuvent être fusionnés par leurs rangs, en conservant les identifiants des passages et en mesurant l’effet des paramètres sur les questions réelles.
- Par fusion de rangs, qui combine les positions plutôt que les scores. Cela évite d’additionner directement des scores de nature différente ; le nombre de candidats et les paramètres restent à tester.
- Sans pondération savante au départ. Une pondération égale constitue un point de départ à comparer ; l’ajuster demande un jeu de tests. Voir construire un jeu de tests en une journée.
- En dédupliquant sur l’identifiant du passage, un même extrait pouvant remonter dans les deux listes.
- En gardant la trace de la voie d’arrivée, ce qui rend les échecs diagnosticables.
Comment traiter les identifiants dans une question ?
Quand la question contient un identifiant reconnaissable, il faut le rechercher exactement et privilégier le résultat, avant même toute fusion. C’est une règle simple qui règle une classe entière de problèmes.
La mise en œuvre tient en quelques lignes. On détecte dans la question les motifs d’identifiant du domaine, article suivi d’un nombre, code produit, numéro de dossier, et on lance une recherche exacte sur ce motif. Si elle donne un résultat valide dans le périmètre autorisé, il peut être prioritaire. Il faut traiter les ambiguïtés de version et les codes partagés par plusieurs documents.
Ce traitement paraît rustique et il est remarquablement efficace, parce que les questions contenant un identifiant sont précisément celles où l’utilisateur attend une réponse exacte et où l’à-peu-près est le plus dommageable.
J’y ajoute une règle de refus : si l’identifiant demandé n’existe pas dans le corpus, le système doit le dire plutôt que de répondre sur un article voisin. Le principe est développé dans le refus de répondre est une fonctionnalité.
Comment mettre en place une recherche hybride, étape par étape ?
Mettre en place une recherche hybride sur un système existant suit six étapes, dont la charge dépend du moteur, des accès et du découpage déjà disponibles.
- Constituer dix à vingt questions de référence contenant des identifiants exacts et autant de questions reformulées, avec le passage attendu pour chacune.
- Mesurer l’existant. Combien de ces passages remontent-ils dans les premiers résultats ?
- Ajouter l’index lexical sur les mêmes passages que l’index vectoriel, avec les mêmes identifiants.
- Lancer les deux recherches en parallèle et fusionner par rangs, à pondération égale.
- Ajouter la détection d’identifiants propre au domaine, avec recherche exacte prioritaire et refus si l’identifiant n’existe pas.
- Mesurer à nouveau sur les mêmes questions, et conserver la voie d’arrivée de chaque passage dans les journaux.
Cette séquence s’intègre aux garde-fous décrits dans chatbot RAG : sources et garde-fous, où la citation de la source permet à l’utilisateur de vérifier qu’il a bien obtenu l’article demandé.
Les mêmes filtres de validité et de droits doivent s’appliquer aux deux voies avant que les passages soient transmis au modèle. Un gain de rappel ne justifie pas de retrouver des documents interdits à l’utilisateur.
Combien coûte la mise en place d’une recherche hybride ?
La mise en place d’une recherche hybride ajoute un index, une fusion et une recette, avec un coût de calcul et une latence à mesurer dans l’environnement concerné.
Un moteur qui dispose déjà des deux modes peut simplifier l’intégration. Un système qui ne possède qu’un index vectoriel demande davantage de travail : indexation, correspondance des identifiants, accès et surveillance.
Exécuter les recherches en parallèle peut limiter leur délai cumulé, mais ne garantit pas une latence inchangée. La plus lente, la fusion et les échanges réseau comptent dans le parcours.
Je chiffre donc la préparation et l’exploitation, puis les compare aux erreurs corrigées. Aucun délai universel d’une journée ni coût nul par requête ne peut être annoncé sans examiner le corpus et la charge.
Quel test permet de repérer un défaut sur les références exactes ?
Un premier test consiste à poser des questions contenant des références connues et à inspecter les passages retrouvés, afin de séparer une erreur d’index d’une erreur de génération.
Poser dix questions contenant une référence exacte, un numéro d’article, un code produit, et vérifier que le bon passage remonte. Un passage voisin signale un défaut à diagnostiquer : identifiant, index, filtre ou découpage. Il ne prouve pas à lui seul l’absence d’un index lexical.
Qu’est-ce que la recherche hybride ne corrige pas ?
La recherche hybride ne décide pas quelle version fait autorité et ne répare pas automatiquement un passage privé de ses conditions, ce qui impose un travail préalable sur le corpus. Il faut la situer correctement dans la chaîne.
Si le corpus contient trois versions d’une même procédure sans indication de validité, les deux index remonteront les trois. La hiérarchie des sources est une décision humaine, pas un problème de recherche, ce que rappelle le corpus est le projet.
Si le découpage sépare une clause de sa condition, retrouver un extrait isolé peut produire une réponse incomplète. Il faut alors ajuster les unités ou restituer leur contexte. Le passage remonté sera correct et incomplet.
L’ordre d’intervention qui fonctionne est donc : corpus d’abord, découpage ensuite, recherche hybride en troisième. Inverser cet ordre produit des améliorations qui ne se voient pas, parce qu’un problème amont masque le gain aval.
Quelles erreurs fréquentes faut-il éviter avec la recherche hybride ?
Les erreurs les plus fréquentes avec la recherche hybride viennent d’un réglage prématuré et d’une absence de mesure, bien plus que d’un mauvais choix d’algorithme.
- Pondérer à l’intuition. Sans jeu de tests, une pondération « 70 / 30 » n’est qu’une opinion chiffrée.
- Additionner des scores incomparables. Les scores lexicaux et vectoriels ne sont pas sur la même échelle ; la fusion par rangs évite ce piège.
- Indexer des passages différents dans les deux index. La déduplication devient impossible et les résultats se contredisent.
- Oublier les journaux. Sans la voie d’arrivée de chaque passage, on ne sait pas quelle recherche a échoué.
- Attendre de l’hybride qu’il règle un corpus en désordre. Il retrouvera fidèlement les mauvaises versions.
Ces points font partie des vérifications d’un audit IA sur un assistant documentaire.
Quelles questions fréquentes se poser sur la recherche hybride ?
Qu’est-ce que la recherche hybride en RAG ?
C’est la combinaison d’une recherche par mots exacts, comme BM25, et d’une recherche par le sens fondée sur des embeddings, dont les résultats sont fusionnés en une seule liste. Elle couvre à la fois les références exactes et les questions reformulées.
Pourquoi la recherche vectorielle rate-t-elle les numéros d’article ?
La recherche vectorielle peut rapprocher des références voisines sans respecter la distinction exacte attendue par l’utilisateur, selon le modèle, les textes et les filtres de l’index. Ce risque doit être testé.
Comment fusionner les deux listes de résultats ?
Par fusion de rangs, qui combine les positions plutôt que les scores; Une pondération égale fonctionne bien au départ ; l’ajuster demande un jeu de tests.
Combien coûte l’ajout d’un index lexical ?
Le coût dépend des possibilités du moteur, du corpus et de la charge, avec un travail d’indexation, de fusion, de contrôle des accès et de recette. Les ressources et la latence doivent être mesurées.
Qu’est-ce que la recherche hybride ne corrige pas ?
Un corpus contenant plusieurs versions sans indication de validité, et un découpage qui sépare une clause de sa condition; Ces deux problèmes sont en amont de la recherche et doivent être traités d’abord.
Quel gain attendre de la recherche hybride ?
Le gain dépend du corpus et des questions : les 49 % annoncés par Anthropic en septembre 2024 concernent une recherche contextuelle combinant BM25 et embeddings enrichis. Ils ne garantissent pas le gain d’un index lexical ordinaire.