Pourquoi un assistant d’IA invente-t-il sur vos propres documents ?
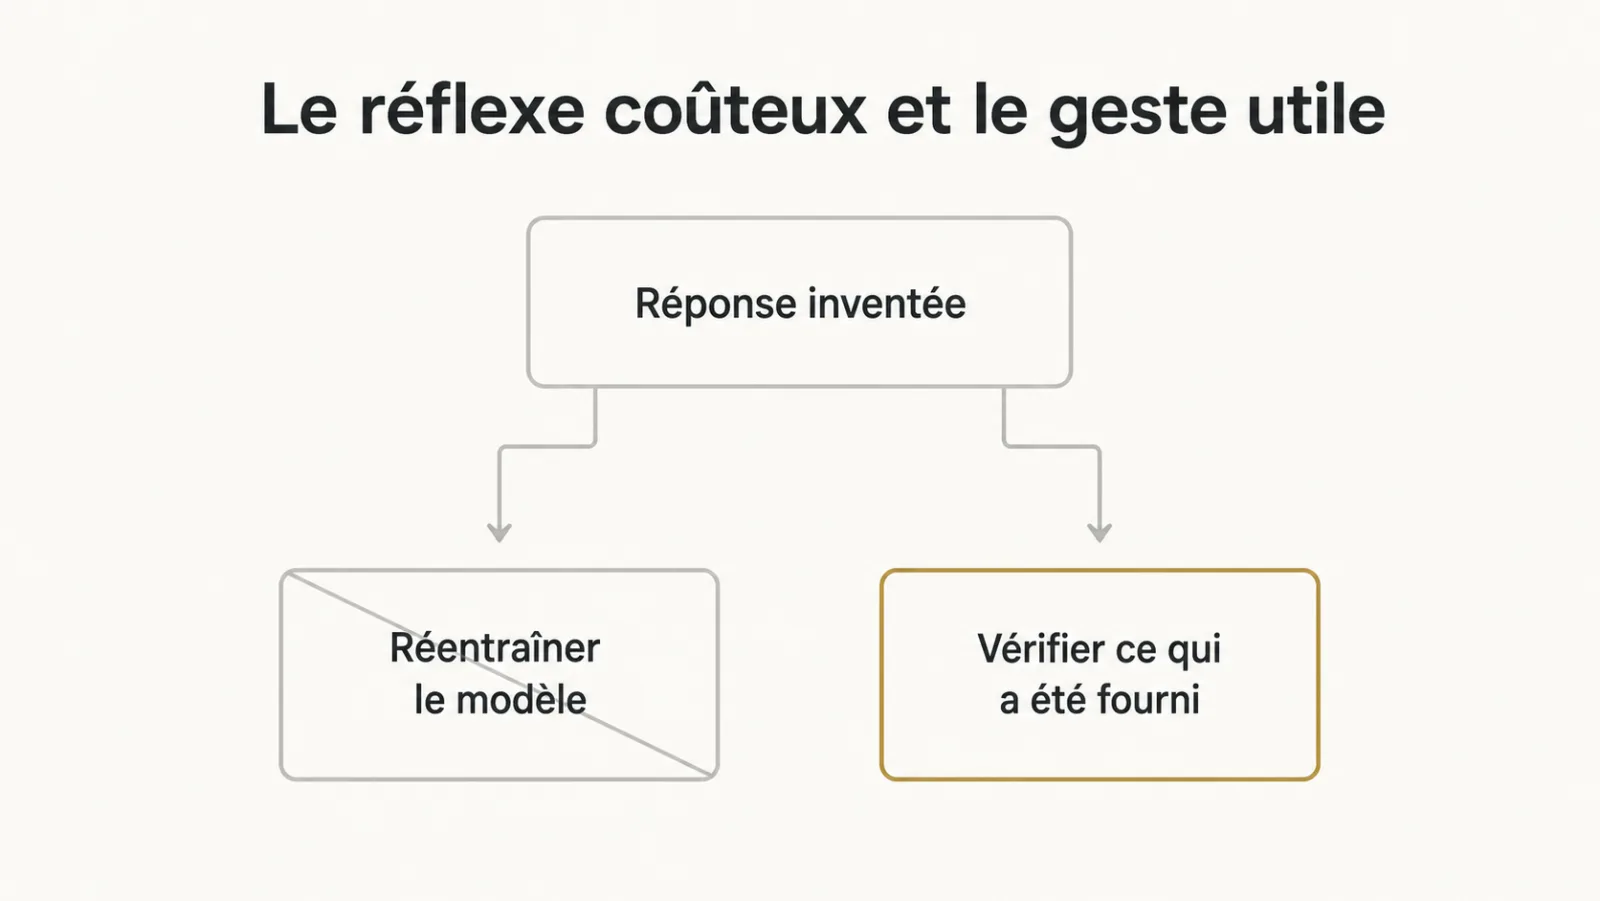
Un assistant documentaire peut inventer lorsque la source manque, lorsque les extraits sont mal choisis ou lorsque le modèle exploite incorrectement des informations pourtant disponibles. Le réentraîner d’emblée ne traite pas nécessairement la cause.
On parle d’invention, ou d’hallucination, quand le système produit une affirmation plausible qui n’est pas fondée sur les documents. Dans une chaîne documentaire (souvent appelée RAG, pour génération augmentée par récupération), le modèle ne possède pas nécessairement une connaissance à jour du corpus : il reçoit, à chaque question, quelques extraits sélectionnés par une étape de recherche, tout en conservant les connaissances de son entraînement.
Le travail original de Lewis et ses coauteurs, publié en mai 2020, combine précisément connaissances paramétriques et informations récupérées. La récupération permet d’apporter des passages explicites ; elle ne garantit pas que toute affirmation produite sera fondée.
Si la réponse est inventée, je commence par inspecter les extraits et les conditions de la réponse avant de modifier le modèle. L’architecture elle-même est décrite dans un chatbot documentaire avec sources et garde-fous.
Comment commencer le diagnostic d’un assistant qui invente ?
Le diagnostic commence par des réponses erronées documentées, en vérifiant pour chacune les sources disponibles, les extraits transmis, les consignes et les droits réellement appliqués. Quelques cas amorcent l’enquête, sans garantir un diagnostic complet en dix minutes.
Le résultat sépare deux causes qui appellent des corrections opposées. Si l’information n’y était pas, le problème est dans la recherche ou dans le corpus. Si elle y était et que la réponse est fausse quand même, le problème est dans le prompt ou dans le modèle.
Je ne déduis pas une fréquence générale de ces cas. Une information absente peut orienter vers la recherche, mais une consigne de refus mal suivie peut aussi aggraver l’erreur.
Ce diagnostic suppose que les extraits puissent être reconstitués dans un dispositif sécurisé et proportionné, décrit dans l’observabilité des systèmes IA.
| Résultat du diagnostic | Où est le problème | Correctif adapté | Le réentraînement aide-t-il ? |
|---|---|---|---|
| Le document n’est pas dans le corpus | Corpus | Ajouter, mettre à jour, retirer les versions périmées | Ne répare pas ce défaut |
| Le document existe mais n’est pas remonté | Recherche | Recherche hybride, réglage de la récupération | Non |
| L’extrait remonté est coupé de son contexte | Découpage | Revoir la maille et les chevauchements | Non |
| L’information était fournie, la réponse est fausse | Prompt ou modèle | Consignes, autorisation de refuser, autre modèle | À évaluer sur des exemples réservés |
Repère de travail que j’utilise sur mes missions : Prendre cinq réponses inventées et vérifier, pour chacune, si l’information correcte figurait dans les extraits fournis au modèle. C’est le seul geste utile avant toute décision.
Quelles causes concrètes rechercher avant de réentraîner le modèle ?
Les causes à examiner sont les documents absents, les erreurs de recherche, les fragments incomplets et les réponses sans fondement, sans leur attribuer une fréquence universelle.
- Le document n’est pas dans le corpus, ou n’y est plus. Vérifier la version et les droits avant de l’ajouter.
- La recherche ne le retrouve pas, typiquement sur une référence exacte. Voir recherche hybride.
- Le découpage a séparé l’information de son contexte, une clause de sa condition. Voir découper un document.
- Le système n’a pas le droit de refuser, ce qui peut favoriser une réponse sans fondement. Voir le refus de répondre est une fonctionnalité.
Comment corriger un assistant qui invente, étape par étape ?
Corriger un assistant qui invente suit une séquence courte : journaliser les extraits, diagnostiquer des cas représentatifs, corriger la cause en amont, afficher les sources, autoriser le refus, puis verrouiller par le jeu de tests. Chaque étape se vérifie avant de passer à la suivante.
- Journaliser les extraits fournis. Conserver la question, les versions et les références avec des accès et une durée de conservation adaptés.
- Diagnostiquer cinq réponses inventées. Classer chacune selon le tableau ci-dessus.
- Corriger la cause dominante. Vérifier la cause observée, sans supposer une fréquence ; le corpus est le projet bien plus souvent que le modèle.
- Afficher la source de chaque réponse. L’utilisateur voit d’où vient l’information.
- Autoriser explicitement le refus. Une consigne claire, et des questions hors périmètre dans le jeu de tests.
- Ajouter chaque cas corrigé au jeu de tests. Pour détecter sa réapparition lors d’une modification.
Quand le corpus évolue souvent, la façon de le tenir à jour sans tout recalculer est décrite dans réindexer coûte plus cher que répondre.
Que corrige un réglage fin, et que ne corrige-t-il pas ?
Un réglage fin peut améliorer le comportement appris, le style et le format, mais ne garantit ni l’actualité des faits internes ni une réponse traçable. Son intérêt doit être testé sur une cause identifiée.
L’annonce d’OpenAI du 22 août 2023 décrit notamment les consignes, les formats et le ton comme usages du réglage fin. Elle le présente aussi comme complémentaire de la récupération. Cela ne prouve pas que tous les défauts documentaires demandent un entraînement.
Un apprentissage peut modifier des connaissances ou des comportements. Il ne remplace pas automatiquement la mise à jour d’une procédure, la gestion des accès et l’ouverture du passage qui justifie une réponse. Il faut comparer la solution entraînée à des corrections de recherche et de consignes, sur des documents réservés aux tests.
La disponibilité de la base relève du cycle de vie propre à la version et au fournisseur. Aucune fréquence annuelle de retrait n’est supposée. Si la base utilisée devient indisponible, il faut prévoir adaptation, reprise des exemples et nouvelle validation. Voir RAG ou fine-tuning : l’arbitrage par le coût.
Comment rendre les réponses et les refus vérifiables par les utilisateurs ?
Afficher les passages utilisés et prévoir un refus explicite rend le comportement plus vérifiable, à condition de tester les citations et les critères de réponse. Ces deux dispositifs n’offrent pas une garantie contre les hallucinations.
L’utilisateur doit pouvoir ouvrir le passage invoqué et vérifier qu’il soutient l’affirmation. Une citation inventée ou hors sujet reste une erreur. Le système cesse d’être une boîte dont il faut croire les réponses.
L’autorisation de refuser change le comportement sur la classe de cas la plus dangereuse. Une consigne de refus doit être éprouvée avec des questions sans réponse, des sources contradictoires et des documents périmés. Un refus utile précise ce qui manque.
Ce second point demande une consigne explicite et un jeu de tests contenant des questions hors périmètre, faute de quoi la première campagne d’optimisation supprimera le garde-fou.
Quelle question poser avant de financer un réglage fin ?
Avant de financer un réglage fin, il faut établir si l’information correcte était disponible et identifier le défaut que l’entraînement devrait corriger sur des exemples.
« L’information correcte figurait-elle dans les extraits fournis ? » Si elle manquait, une correction du corpus ou de la recherche mérite une comparaison avant l’entraînement. La décision doit préciser un bénéfice attendu et les contrôles permettant de l’observer.
Que faut-il expliquer aux utilisateurs d’un assistant documentaire ?
Les utilisateurs doivent comprendre que l’assistant consulte des extraits sélectionnés et peut les interpréter incorrectement, afin de signaler la source et le passage concernés par une erreur. Cette explication en une phrase change la façon dont les utilisateurs formulent et signalent.
Repère de travail que j’utilise sur mes missions : Afficher la source de chaque réponse, et autoriser le système à dire qu’il n’a pas trouvé. Ces deux gestes règlent la majorité des situations, et ils coûtent une journée.
Le même utilisateur, informé du mécanisme, signale autrement : il dit que le document attendu et le passage pertinent, ce qui fournit une piste à vérifier.
Cette explication fait partie de ce que je transmets en priorité, parce qu’elle transforme les utilisateurs en source de diagnostic. C’est un des trois gestes décrits dans les trois gestes qui font tenir un système, et un contenu central de toute formation IA destinée aux utilisateurs.
La formulation que j’emploie tient en une phrase, et je la fais figurer dans l’interface elle-même quand c’est possible : ce système consulte une sélection de documents ; ouvrez les sources et signalez le passage qui contredit sa réponse. Je demande aussi de distinguer erreur factuelle, document absent et refus incorrect, sans attribuer d’avance la cause.
Quelles erreurs fréquentes aggravent les inventions d’un assistant ?
Les erreurs qui aggravent les inventions d’un assistant sont de réentraîner sans diagnostic, d’ajouter des consignes pour compenser la recherche, de masquer les sources et d’interdire le refus. Toutes déplacent le problème au lieu de le traiter.
- Réentraîner d’emblée. Coûteux, à refaire quand la base est retirée, et sans correction directe du document absent ou du droit d’accès.
- Compenser par le prompt. Une consigne du type « cherche ailleurs si tu ne trouves pas » peut conduire à utiliser des sources non pertinentes.
- Masquer les sources. L’utilisateur ne peut plus repérer l’erreur lui-même.
- Exiger une réponse à tout. Cela peut encourager une réponse sans justification.
- Ne pas journaliser. Sans les extraits fournis, le diagnostic devient plus difficile.
Pour un système déjà en place qui invente régulièrement, un audit IA commence par ce diagnostic des extraits avant toute recommandation sur le modèle.
Quelles questions poser quand l’assistant invente sur ses documents ?
Faut-il réentraîner le modèle sur ses documents quand l’assistant invente ?
Il faut commencer par un diagnostic des sources, des extraits et des consignes : un réglage fin peut être utile, mais ne corrige pas automatiquement une recherche défaillante.
Comment commencer le diagnostic d’un assistant qui invente ?
Quelques erreurs réelles permettent de commencer en examinant les extraits et la source attendue ; le temps nécessaire dépend du système et aucune durée de dix minutes n’est garantie.
Que corrige un réglage fin ?
Le réglage fin peut améliorer les consignes, le ton et les formats, sans garantir une connaissance interne actuelle ; sa maintenance dépend aussi de la disponibilité de la base utilisée.
Que faut-il contrôler en affichant les sources et les refus ?
Il faut vérifier que la citation existe, soutient l’affirmation et reste accessible à l’utilisateur, puis tester les réponses attendues et les refus sur des cas documentés.
Pourquoi journaliser les extraits fournis au modèle ?
Conserver ou pouvoir reconstituer les extraits aide à établir ce qui était disponible ; les traces doivent être sécurisées, proportionnées et associées aux versions du système.
Qu’est-ce qu’une hallucination dans un assistant documentaire ?
Une hallucination est une affirmation sans fondement dans les documents consultés ou contraire à ceux-ci ; ses causes possibles incluent récupération, corpus, consignes et comportement du modèle.