En quoi consiste le retrait des identifiants avant l’envoi à une API d’IA ?
Remplacer les identifiants par des marqueurs avant un appel externe peut réduire leur exposition, sans rendre automatiquement le transfert licite ni les données anonymes. La chaîne doit être évaluée sur le corpus et les conditions du traitement.
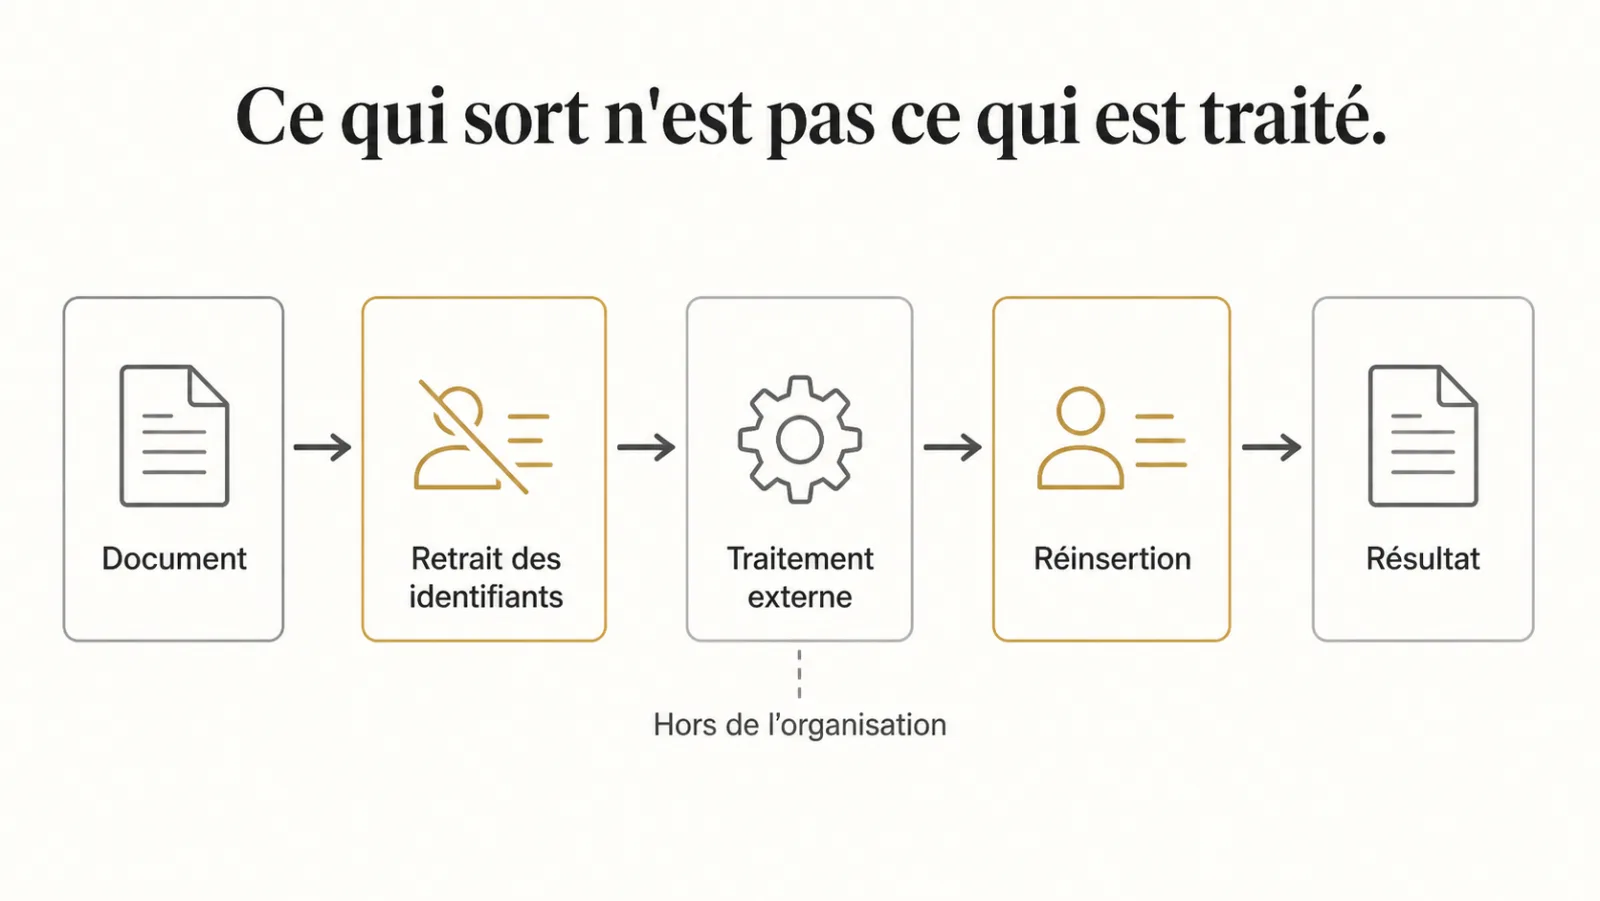
Le traitement se déroule en trois temps. Un composant interne repère les éléments identifiants et les remplace par des marqueurs stables. Le document ainsi transformé part vers le service externe. La réponse revient, et le même composant remplace les marqueurs par les valeurs d’origine.
L’objectif est de maintenir localement les valeurs directement identifiantes, tout en transmettant le contenu nécessaire à la tâche. Un identifiant oublié, un journal trop détaillé ou un recoupement peut compromettre cet objectif.
Est-ce une anonymisation ou une pseudonymisation au sens du RGPD ?
Une chaîne qui remplace les identifiants par des marqueurs puis réinsère les valeurs d’origine est juridiquement une pseudonymisation, pas une anonymisation : les données restent des données personnelles au sens du RGPD. On parle couramment d’« anonymiser avant d’envoyer », mais le terme est trompeur.
La différence tient à la réversibilité. Une donnée anonymisée ne permet plus, par aucun moyen raisonnable, de retrouver la personne. Une donnée pseudonymisée le permet, à condition de disposer de l’information complémentaire, ici la table de correspondance entre marqueurs et valeurs. Puisque la chaîne réinsère les valeurs, cette table existe par construction.
Le CEPD, dans la version pour consultation adoptée le 16 janvier 2025, rappelle que des données réattribuables grâce à une information complémentaire restent personnelles. C’est cette édition historique qui est utilisée ici.
| Anonymisation | Pseudonymisation (la chaîne décrite ici) | |
|---|---|---|
| Retour à la personne possible | Non, par aucun moyen raisonnable | Oui, avec la table de correspondance |
| Statut au regard du RGPD | Hors du champ du règlement | Données personnelles, règlement applicable |
| Réinsertion des valeurs après traitement | Impossible | C’est le principe même |
| Ce qu’elle apporte | Un risque d’identification rendu négligeable, à réévaluer | Une réduction du risque lors du transfert |
La conséquence pratique est simple : la chaîne ne dispense ni de base légale, ni d’analyse de risque, ni d’encadrement contractuel du prestataire. Elle réduit l’exposition, ce qui est déjà beaucoup.
Que ne protège pas une chaîne de retrait des identifiants ?
Une chaîne de retrait des identifiants ne protège pas contre l’identification par recoupement : un document peut rester identifiant après retrait de tous les noms. C’est la limite qu’il faut poser avant de s’appuyer sur la technique, et elle est souvent découverte trop tard.
Un compte rendu associant pathologie rare, date et établissement peut permettre de reconnaître une personne. Un poste unique dans une petite structure peut avoir le même effet. La CNIL, dans sa fiche du 19 mai 2020, distingue notamment individualisation, corrélation et inférence.
La règle à retenir : le retrait d’identifiants directs réduit le risque, il ne le supprime pas. Pour un corpus où la combinaison de caractéristiques suffit à identifier, la chaîne seule ne suffit pas. Il faut réduire les détails, ajouter des protections ou garder le traitement interne, selon l’analyse documentée.
La décision relève d’une analyse de risque documentée, pas d’un choix technique. Le cadre général figure dans confidentialité : ce qu’on a le droit de mettre dans un prompt, et les obligations de documentation côté ingénierie dans ce que l’ingénieur doit livrer avec l’AI Act.
Quels pièges contrôler dans une chaîne de pseudonymisation ?
Les principaux pièges concernent les identifiants oubliés, les marqueurs incohérents, les réinsertions incorrectes et les détails permettant un recoupement, à tester séparément avant l’envoi.
- Les marqueurs instables. Si la même personne reçoit deux marqueurs différents dans un même document, le modèle peut confondre les relations entre les personnes.
- Les identifiants manqués. Un numéro de dossier au format inhabituel, une adresse électronique dans un en-tête, une signature en pied de page.
- La réinsertion partielle, quand le modèle reformule le marqueur au lieu de le recopier. Il faut vérifier les marqueurs attendus selon la tâche, ainsi que les marqueurs inconnus ou ambigus.
- Le contexte trahissant, décrit plus haut, qui ne relève pas du retrait mais de l’analyse de risque.
Comment repérer les identifiants de façon fiable dans un document ?
Le repérage des identifiants doit combiner les méthodes adaptées au corpus et mesurer leurs oublis, sans présumer qu’un petit modèle dépasse toujours les règles explicites. Je recommande de comparer les candidats avant de choisir.
Les expressions régulières couvrent des formats connus, comme des numéros ou des adresses électroniques. Un modèle de reconnaissance peut compléter les règles pour les noms et les formes libres, mais il peut aussi manquer un identifiant ou masquer un terme utile.
Un modèle local doit être testé sur le français, les documents numérisés et les formats particuliers de l’organisation. L’hébergement interne ne règle pas seul la confidentialité : accès, traces et table de correspondance doivent être protégés. Voir l’écart se resserre sur les tâches structurées.
Un format contraint facilite le contrôle de la réponse, comme dans les sorties structurées. Il ne prouve pas que les bons identifiants ont été retirés ni que leur réinsertion est sémantiquement correcte.
Comment mettre en place la chaîne, étape par étape ?
Mettre en place une chaîne de pseudonymisation suit six étapes : qualifier le corpus, définir les catégories d’identifiants, construire le repérage, garantir des marqueurs stables, contrôler la réinsertion, puis mesurer les oublis et les erreurs sur des documents annotés. Chaque étape a son propre mode d’échec.
- Qualifier le corpus. Déterminer si la combinaison de caractéristiques suffit à identifier une personne. Si oui, revoir le contenu transmis et les protections avant tout envoi.
- Lister les catégories d’identifiants. Noms, adresses, numéros de dossier, identifiants médicaux, mais aussi identifiants internes propres à l’organisation.
- Construire le repérage. Expressions régulières pour les formats certains, petit modèle local pour le reste.
- Rendre les marqueurs stables. Définir la cohérence nécessaire dans le document, sans créer de lien entre dossiers sans besoin. Conserver la table séparément avec des accès limités.
- Contrôler la réinsertion. Contrôler les marqueurs attendus, inconnus ou modifiés selon le format de sortie. Bloquer une réinsertion ambiguë.
- Mesurer avant la mise en service. Utiliser des documents annotés avec les identifiants attendus, puis analyser chaque catégorie d’oubli.
Que faut-il mesurer avant de mettre la chaîne en service ?
Avant la mise en service, il faut mesurer les identifiants manqués, les masquages inutiles, les recoupements possibles et les erreurs de réinsertion sur des cas annotés. Le nombre de documents ne constitue pas, seul, une preuve de sécurité.
Cent documents peuvent amorcer une revue, si les types de fichiers, les catégories d’identifiants et les situations rares sont couverts. Une personne annote les valeurs à retirer ; une autre contrôle la version transformée. Le taux d’oubli se calcule sur les identifiants attendus, en indiquant le dénominateur.
Il faut aussi examiner la gravité : un nom de patient, un identifiant interne et une adresse ont des conséquences différentes. Un résultat sans oubli observé ne prouve pas l’absence d’oubli futur. Les documents réservés à la vérification doivent rester distincts de ceux utilisés pour régler le repérage.
La mesure est reprise quand le corpus change : nouveau format, nouveaux usages ou nouvelle catégorie de données. C’est la logique de construire un jeu de tests en une journée, appliquée à l’exposition des informations.
Quelle première relecture effectuer avant les tests de la chaîne ?
Une première relecture manuelle aide à repérer les catégories d’identifiants et les combinaisons sensibles, mais ne remplace pas les tests nécessaires pour autoriser un transfert.
Je pars de documents de formats différents et cherche ce qui identifie encore, y compris les en-têtes et signatures. Les défauts trouvés deviennent des cas de contrôle. Il faut aussi vérifier ce que les journaux et messages d’erreur conserveraient après l’appel externe.
Quand une chaîne de pseudonymisation n’est-elle pas la bonne réponse ?
Si l’organisation dispose déjà d’un modèle interne suffisant pour la tâche, une chaîne destinée à l’appel externe peut ajouter une complexité inutile à la tâche considérée. Il faut se poser la question dans cet ordre.
La séquence saine consiste à d’abord vérifier si un modèle interne traite la tâche à un niveau acceptable. Pour l’extraction ou la classification, cette option mérite une comparaison sur des exemples réels.
La chaîne se justifie quand la tâche exige réellement un grand modèle externe : une analyse complexe, une synthèse exigeante, un raisonnement en plusieurs étapes sur un contenu sensible.
Elle a un coût propre : un composant supplémentaire à maintenir, une source d’erreur additionnelle, et une mesure à refaire à chaque évolution du corpus. Ce coût est justifié quand le gain de qualité l’est, et pas autrement. Cet arbitrage est approfondi dans la lecture complémentaire modèles ouverts et souveraineté. L’hébergement interne a lui aussi ses charges, détaillées dans ce que télécharger des poids ne fournit pas. Lorsqu’un projet hésite entre les deux, un audit IA permet de qualifier le corpus et les tâches avant de choisir.
Quelles limites vérifier avant de pseudonymiser des documents pour l’IA ?
Retirer les noms suffit-il à rendre un traitement externe licite ?
Pas toujours ; Un document peut rester identifiant par combinaison de caractéristiques, pathologie rare, date, établissement, sans qu’aucun nom n’apparaisse. La décision relève d’une analyse de risque documentée, et les données restent soumises au RGPD.
Remplacer les identifiants par des marqueurs, est-ce de l’anonymisation ?
Non ; Dès lors que les valeurs d’origine peuvent être réinsérées grâce à une table de correspondance, il s’agit d’une pseudonymisation. Les données restent personnelles au sens du RGPD ; la technique réduit le risque sans sortir du champ du règlement.
Expressions régulières ou modèle local pour repérer les identifiants ?
Les règles couvrent les formats connus et un modèle peut compléter le repérage ; il faut comparer leurs erreurs sur le corpus, sans garantir une supériorité universelle du modèle.
Comment vérifier que la chaîne de retrait fonctionne ?
Une annotation de référence permet de compter les identifiants attendus, les oublis et les masquages inutiles ; il faut aussi contrôler les recoupements et les réinsertions, avec un échantillon adapté.
Quand faut-il éviter cette chaîne ?
Il faut comparer l’option interne lorsqu’elle satisfait déjà la tâche : une chaîne externe ajoute maintenance et risques, mais son utilité dépend du bénéfice effectivement mesuré.
Que faire si le modèle externe reformule un marqueur ?
Une réinsertion ambiguë doit être bloquée et signalée ; le contrôle porte sur les marqueurs attendus pour la tâche, leur intégrité et l’absence de marqueur inconnu.