Que permet de conclure la sortie de Llama 3 sur les tâches structurées ?
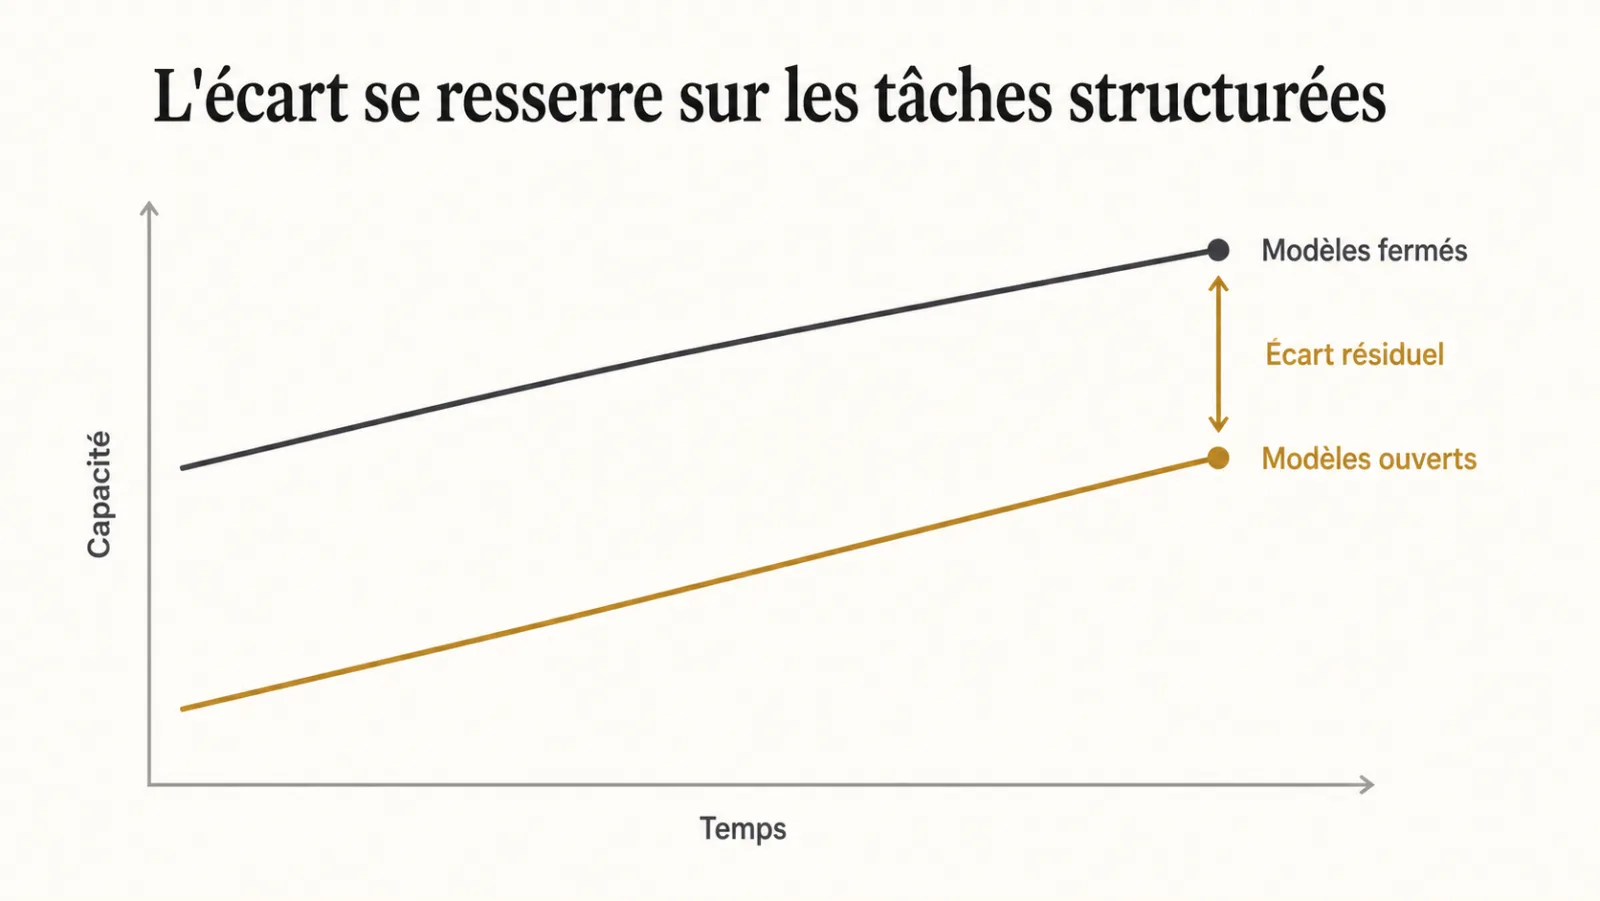
La sortie de Llama 3 justifie de comparer les modèles à poids publiés sur les tâches structurées, sans conclure à une égalité générale avec les API propriétaires. Le choix doit porter sur la tâche et ses contraintes.
Un modèle ouvert, dans le vocabulaire de cet article, désigne un modèle dont les poids sont publiés et que l’on peut héberger soi-même, par opposition à un modèle propriétaire accessible uniquement par l’API de son fournisseur. Une tâche structurée est une tâche dont la réponse attendue est courte, contrainte et vérifiable.
Les tâches structurées ont cette caractéristique commune : extraire une date, classer une demande dans l’une de six catégories, reformuler un paragraphe dans un registre donné. Les catégories, les absences de réponse et les erreurs doivent être définies avant la comparaison.
Le raisonnement long est l’inverse : plusieurs étapes, des contraintes qui interagissent, un résultat difficile à vérifier automatiquement. Les capacités requises ne se déduisent pas du seul nombre de paramètres.
Le 18 avril 2024, Meta publie Llama 3 en versions 8B et 70B. Ses évaluations incluent classification, extraction et réécriture. Elles sont réalisées par l’éditeur et ne constituent pas une preuve de parité sur notre corpus ou en français.
| Type de tâche | Exemple | Ce qu’il faut mesurer | Choix à comparer |
|---|---|---|---|
| Extraction | Date et montant d’une facture | Valeurs exactes, absence et ambiguïté | Poids publiés, API, règles |
| Classification | Ranger une demande | Erreurs par catégorie et cas inconnus | Poids publiés ou API |
| Reformulation | Changer de registre | Conservation du sens et des réserves | Modèles répondant aux critères |
| Analyse longue | Dossier à contraintes multiples | Raisonnement, sources, contradictions | Candidats validés sur ces cas |
Pourquoi cette dissociation décide-t-elle de l’économie d’un système d’IA ?
L’intérêt économique d’un routage dépend du volume, de la qualité et du coût complet de chaque tâche, à mesurer avant de répartir les appels entre modèles. Les deux ne se traitent donc pas de la même façon, ni au même endroit.
Je distingue les appels de préparation, filtrage ou extraction de ceux qui produisent l’analyse visible. Leur part varie selon l’application. Il faut compter les relances, les traitements périodiques et les corrections humaines, sans supposer une répartition de quatre-vingts et vingt pour cent.
Basculer les tâches structurées sur un modèle ouvert hébergé ou sur une API à bas coût peut réduire le coût si le niveau requis est conservé. Une erreur sur un appel de préparation peut affecter la réponse finale. C’est le levier décrit dans Mistral 7B et l’arbitrage par le routage, amplifié par la qualité désormais atteinte. Il prolonge la logique de choisir le palier, pas le modèle : chaque tâche reçoit le modèle le moins cher qui la réussit.
Comment basculer une tâche vers un modèle ouvert sans régression ?
Basculer une tâche vers un modèle ouvert sans régression demande de la mesurer sur un jeu de tests maison avant et après, tâche par tâche, en commençant par les plus structurées. La méthode tient en cinq étapes.
- Inventorier les appels. Lister chaque type d’appel du système et le classer : structuré ou raisonnement.
- Constituer des cas annotés par tâche. Des cas réels avec la réponse attendue et les limites. Trente cas peuvent amorcer la comparaison, sans prouver une fiabilité générale.
- Mesurer le modèle actuel. Établir la référence : taux de réussite, validité du format, comportement de refus.
- Mesurer le candidat ouvert. Mêmes cas et critères ; noter les adaptations du prompt sans régler le candidat sur les cas réservés aux tests.
- Basculer une tâche à la fois. Conserver le modèle actuel en repli, et surveiller les erreurs et la stabilité selon le risque avant de passer à la suivante.
Cette démarche n’est possible que si le jeu de tests est rejouable en une commande, ce qui est le sujet de l’évaluation continue, le chaînon manquant.
Quels critères vérifier avant de confier une tâche à Llama 3 ?
Avant une bascule, il faut vérifier les cas limites, les formats, la langue et les refus sur les documents réels, avec des critères d’acceptation explicites.
- Le comportement sur les cas limites, pas sur les cas moyens. C’est là que les écarts subsistent, et ce sont eux que les utilisateurs remarquent.
- La stabilité du format de sortie. Un format invalide doit être détecté et orienté vers un traitement défini.
- Le comportement en français. La fiche du modèle Llama 3, édition avril 2024, vise l’usage en anglais ; une bonne performance en français n’est pas garantie. Voir le multilingue comme contrainte d’architecture.
- Le refus. Les questions sans réponse et les demandes hors périmètre doivent avoir un comportement contrôlé. Voir le refus de répondre est une fonctionnalité.
Peut-on se fier aux classements publics pour choisir un modèle ?
On ne peut pas se fier aux classements publics pour choisir un modèle, parce qu’un classement général ne suffit pas à prédire la performance sur votre tâche, votre langue et votre format. C’est la raison pour laquelle le jeu de tests maison reste irremplaçable.
Deux problèmes se cumulent. D’une part, un risque de recouvrement entre entraînement et évaluation doit être examiné, sans l’attribuer à tout fournisseur. D’autre part, un score moyen sur des tâches variées ne prédit pas le comportement sur une tâche précise, dans un domaine précis, en français.
J’ai vu à plusieurs reprises un modèle mieux classé donner de moins bons résultats qu’un modèle moins bien classé sur un cas réel : typiquement parce que le premier était plus verbeux et respectait moins bien un format de sortie contraint.
Je conserve des cas réservés à la vérification et une grille stable. L’effort dépend de la tâche et du risque, pas d’une durée universelle.
Quand faut-il rejouer la comparaison avec un nouveau modèle à poids publiés ?
Une nouvelle version mérite une comparaison lorsqu’un besoin, une contrainte ou un défaut observé lui donne un objectif mesurable, avec un effort proportionné au risque.
Le jeu de tests permet une première revue sans migration immédiate. La décision compte aussi l’adaptation de l’interface, la licence, la surveillance et la possibilité de revenir au modèle précédent.
Que change ce rattrapage pour les organisations qui manipulent des données sensibles ?
Un modèle à poids publiés ouvre une option de traitement interne pour les données sensibles, si sa qualité et ses conditions d’exploitation satisfont la tâche et l’analyse de risque. C’est la conséquence la plus importante pour la santé, la défense et le secteur public.
Il faut comparer cette option sur l’extraction, la classification ou le repérage d’identifiants. L’hébergement interne ne garantit pas le résultat ni la protection des données ; les accès, les journaux et les sorties restent à contrôler. La question de ce qu’on a le droit de mettre dans un prompt change alors de nature : la capacité à traiter sur place doit être démontrée sur les cas sensibles.
Le réglage recommandé reste mixte : traitement interne pour tout ce qui touche aux données protégées, recours à une API pour l’analyse complexe sur des contenus non sensibles ou préalablement anonymisés. Cette architecture demande une couche d’abstraction et une règle claire sur ce qui a le droit de sortir, sans présumer que le partage interne et externe convient à chaque organisation.
Quelles conditions faut-il remplir pour exploiter un modèle ouvert en interne ?
Exploiter un modèle ouvert en interne exige une licence compatible avec l’usage, une équipe qui surveille et met à jour le modèle au quotidien, et un budget d’infrastructure provisionné dans la durée. La qualité du modèle ne suffit pas.
La licence d’abord : un modèle dit ouvert n’autorise pas forcément tous les usages, comme l’a montré Llama 2, où la licence comptait autant que le modèle. La licence communautaire Llama 3 datée du 18 avril 2024 doit être lue avec ses conditions avant de bâtir dessus.
L’exploitation ensuite, qui est la condition que la technique ne règle pas : quelqu’un doit exploiter le modèle interne au quotidien, surveiller sa disponibilité, appliquer les montées de version, diagnostiquer les ralentissements. Cette charge est réelle et permanente. Une charge non provisionnée compromet la maintenance et la continuité du service. Des poids publiés ne sont pas des poids exploitables, comme le rappelait le cas de Grok.
Avant de trancher entre interne, API ou architecture mixte, un audit IA permet de cartographier les appels et les données qui les traversent.
Quelles erreurs fréquentes commet-on en passant à un modèle ouvert ?
Les erreurs fréquentes en passant à un modèle ouvert sont de tout basculer d’un coup, de choisir sur un classement, d’oublier le français et de sous-estimer l’exploitation. Une économie apparente peut alors masquer une perte de qualité.
- Tout basculer d’un coup. Si la qualité baisse, on ne sait pas quelle tâche en est la cause.
- Choisir sur un classement public. Le modèle le mieux classé n’est pas forcément le meilleur sur votre format et votre langue.
- Tester en anglais. Les écarts apparaissent souvent sur les autres langues, et sur le français en particulier.
- Basculer le raisonnement long. La qualité sur ces cas doit être vérifiée, sans déduire le choix d’un seul score moyen.
- Oublier qui exploite. Un modèle hébergé sans responsable expose la continuité et les mises à jour à un risque.
Quelles questions poser avant d’adopter Llama 3 pour une tâche structurée ?
Les modèles ouverts comme Llama 3 valent-ils les modèles propriétaires ?
La comparaison dépend des tâches et des contraintes : Meta annonce des progrès, mais l’égalité avec une API sur un corpus français doit être vérifiée localement.
Peut-on se fier aux classements publics de modèles ?
Un classement public aide à repérer des candidats, sans valider une tâche précise ; il faut contrôler langue, format, cas limites et risque de recouvrement avec l’entraînement.
Que vérifier en priorité avant de basculer une tâche vers un modèle ouvert ?
Le comportement sur les cas limites, la stabilité du format de sortie, la performance en français, et la capacité à refuser plutôt qu’à inventer. Ces quatre points décident de l’utilisabilité en production, bien plus que le score moyen.
Une architecture d’IA entièrement interne est-elle réaliste ?
Une architecture interne est une option à tester sur les tâches et données réelles ; elle exige qualité suffisante, exploitation provisionnée et protections des accès et des traces.
Quelles tâches confier en priorité à un modèle ouvert ?
Je commence par les tâches courtes et vérifiables dont le volume justifie la comparaison, puis je mesure qualité, erreurs et coût complet avant d’en décider l’affectation.
Faut-il réévaluer à chaque nouvelle génération de modèle ouvert ?
Une nouvelle génération peut justifier une comparaison ciblée si elle répond à un besoin ou un défaut observé ; le résultat ne garantit pas un gain supérieur aux autres corrections.