Que consomme un système d’IA documentaire avant sa première réponse ?
Avant sa première réponse, un système d’IA documentaire consomme déjà de l’énergie pour indexer le corpus, calculer les embarquements et exécuter des traitements par lot, trois postes à intégrer au bilan avant d’évaluer la consommation par réponse. Ils ont lieu avant qu’aucun utilisateur n’ait posé de question.
Un système documentaire est un assistant qui répond à partir des documents d’une organisation. Pour cela, il faut d’abord lire ces documents, les découper en fragments, et transformer chaque fragment en vecteur, ce qu’on appelle un embarquement (embedding). C’est cette préparation qui permet ensuite de retrouver les bons extraits à chaque question.
La raison de l’angle mort est simple : les traitements de préparation peuvent relever d’une autre infrastructure ou d’un autre budget. Les factures en jetons décrivent un prix, pas une quantité d’énergie ; il faut conserver la distinction.
Le poids relatif dépend du volume d’usage et des reprises. L’étude de Luccioni, Jernite et Strubell, édition FAccT 2024, compare des tâches et architectures ; les systèmes génératifs polyvalents étudiés consomment davantage que des modèles spécialisés sur certaines tâches. Elle ne mesure pas la part de préparation de notre assistant ni tous les modèles d’embarquement.
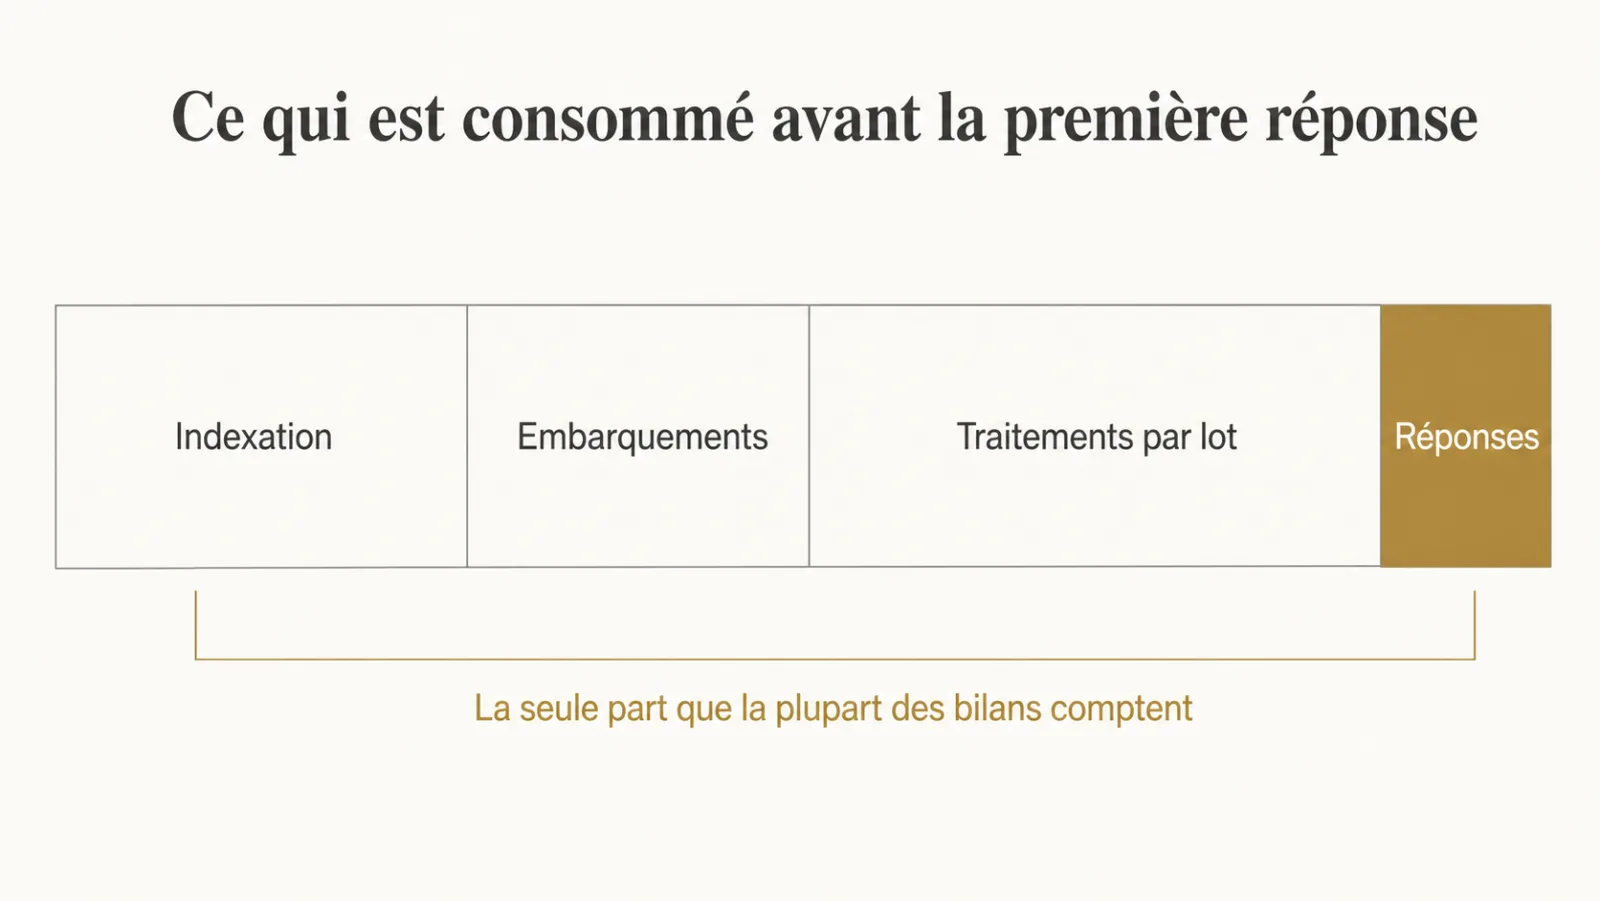
L’amont peut devenir dominant pour un corpus important, peu interrogé ou recalculé souvent. À l’inverse, les réponses peuvent dominer lorsque leur consommation cumulée dépasse celle de la préparation. Le schéma présente les postes ; ses tailles et sa légende ne constituent pas un bilan mesuré. Aucun équivalent en mois d’usage n’est retenu sans données.
Sur mes chaînes documentaires à faible volume de requêtes, le relevé de traitement est le suivant : Sur les chaînes documentaires que j’exploite, la mise en service consomme l’équivalent de plusieurs mois d’usage courant. Un bilan qui commence à la première réponse se trompe donc d’un facteur qui n’est pas marginal.
Quels sont les trois postes de consommation invisibles d’un système documentaire ?
Les trois postes de consommation invisibles d’un système documentaire sont l’indexation, le calcul des embarquements et les traitements par lot, et aucun des trois n’est visible depuis l’interface. Il faut les nommer pour pouvoir les mesurer.
L’indexation lit chaque document du corpus, l’extrait, le découpe. Sur un corpus de plusieurs dizaines de milliers de pièces, la durée dépend des formats et de l’infrastructure et se répète à chaque changement de découpage.
Les embarquements transforment chaque fragment en vecteur. Le calcul dépend du nombre et de la longueur des fragments, ainsi que du modèle et du traitement par lots, et il recommence intégralement à chaque changement de modèle d’embarquement, ce qui demande de planifier la reprise de l’index, comme rappelé dans les embeddings expliqués à une direction.
Les traitements par lot, enfin, sont ceux qu’on oublie le plus : enrichissement de métadonnées, classification systématique, contrôles de complétude. Ils peuvent tourner hors des heures d’usage, et ils traitent parfois l’ensemble du corpus quand seuls quelques documents ont changé.
| Poste | Quand il consomme | Ce qui le fait grossir | Levier principal |
|---|---|---|---|
| Indexation | À la mise en service et à chaque reprise | Changement de découpage, reprise complète | Reprise incrémentale |
| Embarquements | À chaque fragment nouveau ou recalculé | Découpage plus fin, changement de modèle | Stabiliser et versionner le choix du modèle |
| Traitements par lot | La nuit, à intervalle fixe | Périmètre « tout le corpus » | Ne traiter que les documents modifiés |
| Réponses | À chaque requête | Volume d’usage, contexte envoyé | Réduire le contexte, router vers un petit modèle |
Quels relevés permettent de construire un bilan énergétique utile ?
Un bilan utile relie les volumes traités, les reprises, les tâches et les ressources à une période donnée, en distinguant énergie mesurée et indicateurs d’activité.
- Le volume du corpus en nombre de fragments, avec leur longueur et les formats : le nombre seul ne décrit pas le travail.
- La fréquence de réindexation complète, et ce qui la déclenche. Une réindexation mensuelle non justifiée est une piste d’économie à examiner.
- Le périmètre des traitements par lot : tout le corpus, ou seulement les documents modifiés ?
- Le nombre de jetons envoyés par requête, en complément d’une mesure ou d’une estimation explicite de l’énergie. Voir mesurer le coût par fonctionnalité.
Comment établir le bilan énergétique complet d’un système d’IA, étape par étape ?
Établir le bilan énergétique complet d’un système d’IA consiste à séparer le coût de mise en service, le coût des reprises et le coût par requête, puis à les rapporter au volume d’usage réel. Les trois se mesurent séparément.
- Compter les fragments. Relever aussi les jetons, pages et formats, car les traitements diffèrent.
- Mesurer une indexation complète. Mesurer l’énergie sur l’infrastructure réelle, avec durée et ressources. Si seuls des indicateurs sont disponibles, les nommer comme tels.
- Relever la fréquence des reprises. Combien de réindexations complètes par an, et lesquelles étaient justifiées.
- Inventorier les traitements par lot. Leur périmètre et leur fréquence.
- Mesurer la consommation par requête. Mesurer des requêtes représentatives, avec le modèle et le contexte ; les jetons seuls ne sont pas des kWh.
- Rapporter au volume. Comparer la préparation et les réponses sur une même période, avec les mêmes unités.
Le sixième point est celui qui tranche : il dit si le système relève du cas « faible usage, amont dominant » ou du cas « fort usage, inférence dominante », et donc où porter l’effort.
Le calcul sépare énergie initiale, énergie des reprises, traitements périodiques et énergie des requêtes. À consommation moyenne par requête stable, le point d’égalité est l’énergie amont divisée par cette moyenne. La formule donne un seuil propre au système, à réviser quand le modèle ou l’usage change.
Comparez les configurations sur les mêmes questions et documents. L’évaluation continue permet de vérifier qu’une réduction de contexte ou de calcul ne dégrade pas les réponses attendues.
Pourquoi compter la consommation amont change-t-il les décisions techniques ?
Quand la consommation amont est comptée, le découpage des documents et la fréquence de réindexation deviennent des décisions énergétiques, pas seulement techniques. C’est le seul effet qui compte vraiment.
Un découpage plus fin peut augmenter les fragments et les recouvrements, donc le travail de calcul et de stockage. L’effet énergétique doit être mesuré. Cette conséquence doit être explicitée quand on choisit une taille de fragment, alors que le découpage est le choix qui décide de tout.
Sur mes chaînes documentaires, ce constat porte sur les volumes retraités, sans conversion automatique en euros ou en kilowattheures : De même, une réindexation complète programmée chaque semaine sur un corpus qui change à la marge consomme cinquante fois ce que consommerait une reprise incrémentale. Le réglage prend une heure à changer. Ce relevé porte sur les volumes et opérations traités ; il ne fournit pas, à lui seul, une conversion en kilowattheures ou en prix de jetons.
Ces deux décisions sont prises au cadrage, parfois sans mesure de leurs conséquences. Les documenter suffit à les rendre discutables, ce qui est exactement le rôle de la fiche décrite dans écrire la fiche d’un système d’IA.
Pourquoi les documents scannés consomment-ils autant dans un système d’IA ?
Un document scanné peut demander des traitements supplémentaires d’image et d’extraction, dont il faut mesurer le coût et l’énergie selon la tâche réellement exécutée. Une facture multimodale plus élevée ne prouve pas, seule, une consommation électrique supérieure.
Lorsque le corpus contient des scans, comparez l’extraction de texte, la lecture multimodale et la conservation des éléments visuels utiles. Le choix dépend des erreurs d’extraction, des tableaux et de l’usage attendu.
La règle qui limite la casse : extraire une fois à l’indexation plutôt que de renvoyer l’image à chaque question. Le traitement devient un coût unique au lieu d’un coût récurrent, et le texte obtenu reste à vérifier, notamment sur les chiffres et la structure des tableaux.
C’est le même raisonnement que celui posé dans la multimodalité native et ses usages réels, vu cette fois par le poste de consommation.
Quel indicateur établir avant de conclure à la sobriété du système ?
Le volume de fragments recalculés révèle une activité à examiner, mais la sobriété du système exige de relier les traitements à l’énergie et au service rendu.
Le nombre de fragments du corpus, multiplié par le nombre de réindexations complètes par an. Ce produit repère les reprises répétées. Il ne tient compte ni de la longueur des fragments ni des réponses, du matériel ou des traitements d’images.
Sur mes missions, pour relever le nombre de fragments traités et la fréquence des reprises, mon repère opérationnel est le suivant : Il se calcule en dix minutes.
Comment présenter la consommation d’un système d’IA dans un dossier d’investissement ?
Un dossier d’investissement doit présenter séparément la consommation de mise en service, celle des reprises et celle par requête : un coût par requête seul est un chiffre incomplet. Précisez la période et les unités.
La première est un coût d’entrée, ponctuel, qui s’amortit sur la durée de vie du système. La seconde est récurrente et proportionnelle à l’usage. Les confondre conduit soit à surestimer un usage faible, soit à sous-estimer un système qu’on réindexe souvent.
Je présente le coût financier et le bilan énergétique séparément, avec les hypothèses et les incertitudes. Si le prestataire ne fournit pas de données d’énergie, le dossier le signale : le prix facturé ne permet pas de les déduire.
Cette structure de coût est la même que celle décrite dans où part réellement un budget d’IA, et elle se documente au même endroit. Les reprises répétées et non justifiées relèvent d’ailleurs de la dette technique d’un système d’IA. Un audit IA peut établir ce bilan à partir de l’existant.
Le passage à la production ajoute des reprises et des contrôles absents d’une démonstration. Les prévoir au budget, comme dans sortir du prototype, évite de confondre énergie d’un essai et énergie du service.
Quelles erreurs fréquentes faussent le bilan énergétique d’un système d’IA ?
Les erreurs fréquentes sont de ne compter que l’inférence, de généraliser un ordre de grandeur sans tenir compte du volume d’usage, de réindexer intégralement par habitude et de renvoyer les images à chaque question. Toutes faussent le bilan dans un sens ou dans l’autre.
- Compter uniquement les réponses. L’amont disparaît du bilan, alors qu’il peut peser lourd à faible usage.
- Ignorer le volume. Un usage élevé peut faire dominer les réponses, selon leur consommation et celle des reprises.
- Réindexer tout, chaque semaine. Vérifier l’utilité de la reprise et les conditions d’une mise à jour incrémentale.
- Traiter les scans à la volée. Un coût unique devient un coût récurrent.
- Changer de modèle d’embarquement sans le compter. Tout le corpus est à recalculer.
Comment interpréter sans généraliser la consommation d’un système documentaire ?
Qu’est-ce qui consomme le plus dans un système documentaire ?
Le poste dominant dépend de l’énergie cumulée des préparations et des requêtes sur la même période ; un usage faible et des reprises fréquentes peuvent faire peser l’amont davantage.
Pourquoi ces postes n’apparaissent-ils pas dans les bilans ?
Les préparations peuvent être exécutées sur une autre infrastructure ou suivies dans un autre budget ; leur inclusion demande un inventaire des traitements et une mesure distincte des factures.
Quel réglage réduit le plus la consommation amont ?
La fréquence de réindexation complète ; Sur un corpus qui change à la marge, une reprise incrémentale ne traite que les documents modifiés, au lieu de recalculer chaque fois l’ensemble des fragments.
Faut-il traiter les documents scannés autrement ?
Oui : extraire le texte une fois à l’indexation plutôt que de renvoyer l’image à chaque question transforme un coût récurrent en coût unique, pour un résultat interrogeable de la même façon.
Qu’est-ce qu’un embarquement dans un système d’IA ?
Un embarquement transforme le texte en vecteur pour la recherche ; sa consommation dépend du modèle, des longueurs et des lots, et un changement d’espace vectoriel demande de recalculer les documents concernés.
Comment savoir si l’amont pèse lourd dans mon système ?
Il faut comparer l’énergie de préparation et celle des réponses sur la même période, avec des mesures ou des estimations explicites ; le volume de fragments seul ne suffit pas.