Qu’est-ce qu’un assistant de code, et quel critère décide vraiment en entreprise ?
Un assistant de code est un outil d’IA intégré à l’environnement du développeur qui propose du code, et en entreprise il se choisit sur le trajet du code plutôt que sur la qualité de ses suggestions. Les comparatifs évaluent la seconde ; les organisations décident sur le premier.
Concrètement, l’assistant lit le fichier ouvert, parfois le reste du dépôt, envoie ce contexte à un modèle et affiche une proposition : la fin d’une ligne, une fonction entière, un test, une explication. Le modèle tourne le plus souvent chez le fournisseur, plus rarement sur le poste.
Les deux questions, qualité de complétion et trajet du code, n’ont presque aucun rapport. La qualité de complétion se mesure sur des exercices publics, elle progresse vite, et l’écart entre les outils de tête se réduit à chaque génération. C’est donc le critère le moins discriminant.
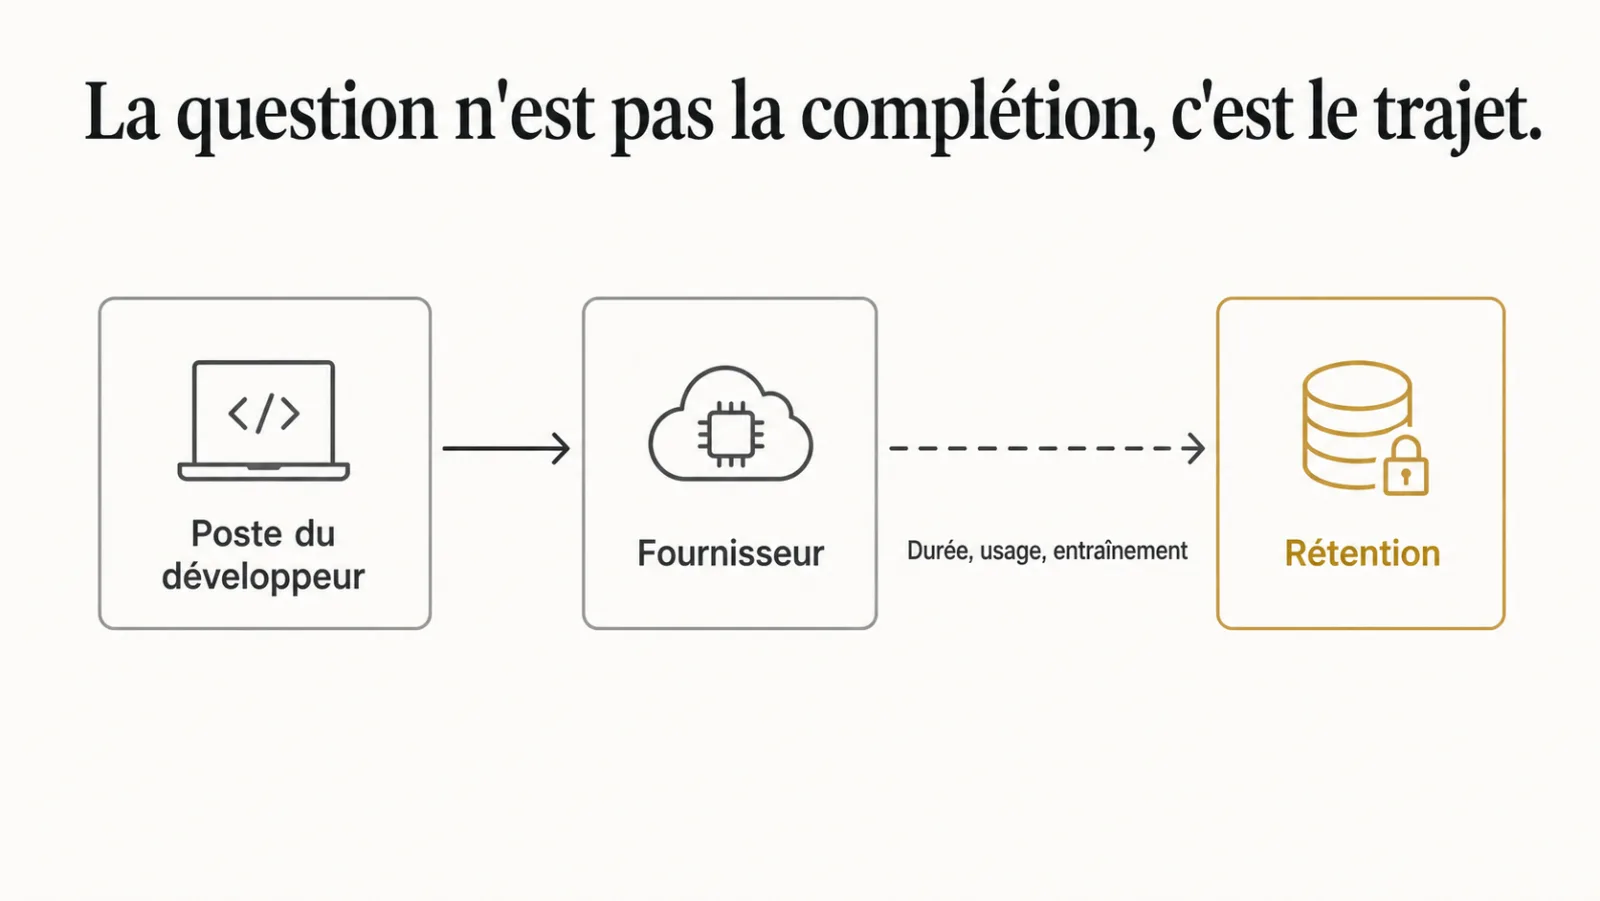
Le trajet du code, lui, varie énormément d’une offre à l’autre : ce qui est envoyé, ce qui est conservé, pour combien de temps, et si cela sert à entraîner. Ces différences sont contractuelles, stables, et elles décident de ce que l’organisation a le droit d’utiliser.
Quelles questions poser au fournisseur d’un assistant de code ?
Quatre questions suffisent à instruire un assistant de code : qu’est-ce qui est envoyé, qu’est-ce qui est conservé, combien de temps, et à quoi cela sert chez le fournisseur. Elles se posent avant toute démonstration.
Ce qui est envoyé : le fichier courant seulement, ou le contexte du dépôt ? Certains outils indexent l’ensemble du code pour améliorer leurs suggestions, ce qui est un transfert d’une tout autre ampleur.
Ce qui est conservé : rien, les requêtes, ou les requêtes et les réponses ? Une rétention nulle se dit et se contractualise.
Combien de temps : une durée chiffrée, pas un engagement de moyens.
À quoi cela sert : usage du service seulement, ou amélioration des modèles ? La réponse à cette dernière question suffit à écarter une offre dans un contexte contraint, et c’est la même logique que celle posée dans confidentialité : ce qu’on a le droit de mettre dans un prompt.
| Question | Réponse qui permet d’avancer | Réponse qui doit alerter |
|---|---|---|
| Qu’est-ce qui est envoyé ? | Périmètre décrit précisément, réglable par dépôt | « Le contexte nécessaire », sans détail |
| Qu’est-ce qui est conservé ? | Rien, ou les seules métadonnées, par écrit | Requêtes et réponses conservées par défaut |
| Combien de temps ? | Une durée chiffrée dans le contrat | « Le temps nécessaire au service » |
| À quoi cela sert ? | Fourniture du service uniquement | Amélioration des modèles, sans exclusion contractuelle |
Ces quatre questions recoupent celles d’évaluer un fournisseur d’IA hors capacités : ce qui distingue deux offres se lit dans le contrat, pas dans la démonstration.
Quels critères comptent ensuite, et dans quel ordre ?
- La stabilité de l’offre. Un outil dont le modèle sous-jacent ou la tarification change tous les six mois coûte en réapprentissage.
- Le comportement hors ligne, pour les équipes qui travaillent sur des sites sans connexion ouverte.
- L’intégration à l’environnement existant, qui décide de l’adoption réelle bien plus que la qualité des suggestions.
- La possibilité de restreindre par dépôt, pour exclure le code le plus sensible sans priver toute l’équipe de l’outil.
Un modèle local peut-il servir d’assistant de code en entreprise ?
Un assistant de code qui tourne sur le poste ne pose aucune question de transfert, et il est devenu utilisable pour la complétion courante, la génération de tests et la reformulation. Ce n’est plus une position de principe.
Sur la complétion de ligne, la génération de tests unitaires et la reformulation de code, un modèle local de taille moyenne suffit. Ces trois usages représentent l’essentiel du volume quotidien.
Sur la compréhension d’une base de code entière ou le raisonnement sur une architecture, l’écart avec un grand modèle distant reste net.
La configuration mixte est donc la même que celle recommandée ailleurs : local pour le volume et le sensible, distant pour les cas difficiles sur du code qui peut sortir. Les conditions de déploiement sont détaillées dans petits modèles sur poste, et la logique d’ensemble dans modèles ouverts et souveraineté.
Que faut-il décider en interne avant de choisir un assistant de code ?
Avant de choisir un assistant de code, l’organisation doit décider quels dépôts ont le droit de sortir, et qui en décide. Sans cette décision, aucun choix d’outil n’est instruit.
La plupart des organisations ont des niveaux de sensibilité très différents entre leurs dépôts : un site vitrine, un back-office métier, un composant sous contrat client, un algorithme propriétaire. Les traiter uniformément conduit soit à interdire partout, soit à autoriser partout.
La décision utile classe les dépôts en trois catégories :
Repère de travail que j’utilise sur mes missions : La décision utile classe les dépôts en trois catégories : ce qui peut sortir sans condition, ce qui peut sortir sous contrat de non-rétention, ce qui ne sort pas. Une demi-journée avec le responsable technique et le juridique.
Une demi-journée avec le responsable technique et le juridique.
Cette classification ressemble à celle des actions d’un agent par réversibilité, et pour la même raison : elle transforme une question de principe en règle applicable. Voir le périmètre avant l’autonomie.
Quelle question écarte le plus d’offres en une phrase ?
« Le code envoyé sert-il à améliorer vos modèles, et pouvez-vous l’exclure par contrat ? » Une réponse évasive à la seconde partie suffit à écarter l’offre pour tout dépôt sensible.
Comment conduire le choix d’un assistant de code, étape par étape ?
Le choix d’un assistant de code se conduit en cinq étapes, de la classification des dépôts à la décision de généralisation, et la démonstration commerciale n’arrive qu’en troisième position. L’ordre compte plus que le détail de chaque étape.
- Classer les dépôts en trois catégories de sensibilité, comme décrit plus haut, et nommer celui qui tranche les cas litigieux.
- Envoyer les quatre questions par écrit aux fournisseurs présélectionnés, et écarter ceux dont les réponses ne couvrent pas la catégorie de dépôts visée.
- Faire la démonstration sur un dépôt réel de la première catégorie, avec des développeurs de l’équipe plutôt qu’avec l’avant-vente.
- Lancer un essai sur un échantillon d’une équipe, en relevant dès le départ le taux d’acceptation et le temps de revue.
- Décider de la généralisation sur ces deux mesures, et consigner la décision dans la fiche du système, sur le modèle de la fiche d’un système d’IA.
Les deux premières étapes éliminent souvent la moitié des candidats avant que la qualité de complétion ait été regardée. C’est le résultat attendu : elles portent sur ce qui ne se rattrape pas après la signature.
Quand le choix touche des dépôts sensibles ou un contexte réglementé, ces étapes gagnent à être instruites dans un audit IA qui couvre aussi les autres usages de modèles dans l’organisation.
Quelles erreurs fréquentes commettent les organisations en choisissant un assistant de code ?
Les erreurs fréquentes dans le choix d’un assistant de code consistent presque toutes à décider sur la démonstration plutôt que sur le contrat et l’usage mesuré. Elles sont faciles à éviter si on les nomme avant.
- Choisir sur un comparatif public de qualité de complétion, alors que l’écart entre outils de tête est le critère le moins stable.
- Laisser chaque équipe choisir son outil, ce qui multiplie les contrats, les trajets de code et les politiques de rétention à suivre.
- Interdire partout faute de classification, ce qui pousse les développeurs vers des usages personnels non encadrés.
- Mesurer le nombre de lignes générées, chiffre flatteur qui ne dit rien du temps gagné.
- Ne pas former à la relecture : un code proposé par un modèle se relit avec la même exigence qu’un code écrit par un collègue, ce qu’une formation IA centrée sur l’outil réellement déployé doit couvrir.
Chacune de ces erreurs se corrige après coup, mais à un coût : changer d’outil impose un réapprentissage, et revenir sur une autorisation trop large est politiquement plus difficile que de l’accorder progressivement.
Que faut-il mesurer après le déploiement d’un assistant de code ?
Après le déploiement d’un assistant de code, il faut mesurer le taux d’acceptation des suggestions et le temps passé en revue, pas le nombre de lignes générées. Ce dernier chiffre est le plus mis en avant et le moins utile.
Le taux d’acceptation dit si l’outil produit du code que l’équipe garde. Un taux faible signale un mauvais réglage de contexte, pas nécessairement un mauvais outil.
Le temps de revue est le contrepoids indispensable : un assistant qui fait écrire plus vite et relire plus longtemps ne fait pas gagner de temps. C’est le point développé dans l’article suivant de cette série.
Ces deux mesures se relèvent sur un échantillon, en une semaine, et elles suffisent à décider d’une généralisation. Le principe de mesure est le même que dans mesurer l’adoption, pas la satisfaction : ce qui compte est l’usage réel à six semaines, pas l’enthousiasme initial. Pour comparer deux outils sur le même code, un jeu de tâches fixe vaut mieux que l’impression des développeurs, selon la méthode de construire un jeu de tests en une journée.
Questions fréquentes
Quel critère décide vraiment du choix d’un assistant de code en entreprise ?
Le trajet du code : ce qui est envoyé, ce qui est conservé, combien de temps, et si cela sert à entraîner. La qualité de complétion est le critère le moins discriminant entre outils de tête.
Faut-il un modèle local pour un assistant de code ?
Pour la complétion, les tests unitaires et la reformulation, il suffit et règle la question du transfert. Pour raisonner sur une base entière, l’écart avec un grand modèle distant reste net. La configuration mixte combine les deux selon la sensibilité du dépôt.
Que décider avant de choisir un outil ?
Quels dépôts ont le droit de sortir, en trois catégories : sans condition, sous contrat de non-rétention, jamais. Sans cette classification, aucun choix d’outil n’est instruit. Elle se fait en une demi-journée avec le responsable technique et le juridique.
Que mesurer après le déploiement ?
Le taux d’acceptation des suggestions et le temps passé en revue. Le nombre de lignes générées est le chiffre le plus mis en avant et le moins utile.
Le code envoyé à un assistant peut-il servir à entraîner les modèles du fournisseur ?
Cela dépend de l’offre et du contrat. Certaines offres l’excluent par défaut, d’autres seulement sur demande, d’autres pas du tout. Il faut obtenir une exclusion écrite pour tout dépôt qui n’est pas public.
Peut-on autoriser un assistant de code sur une partie seulement des dépôts ?
Oui, et c’est la configuration recommandée. La possibilité de restreindre l’outil par dépôt fait partie des critères de choix, parce qu’elle permet d’exclure le code le plus sensible sans priver toute l’équipe de l’outil.
Sources
- Productivity Assessment of Neural Code Completion : le taux d'acceptation des suggestions prédit le mieux la productivité perçue, Ziegler et al., GitHub, arXiv, mai 2022.
- Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity : développeurs expérimentés 19 % plus lents avec l'IA, Becker et al., METR, arXiv, juillet 2025.
- The Impact of AI on Developer Productivity : Evidence from GitHub Copilot, Peng et al., arXiv, février 2023.
- Fiche de transparence des suggestions en ligne de GitHub Copilot : code autour du curseur et onglets ouverts envoyés au modèle, GitHub Docs.