Qu’est-ce qu’un petit modèle sur poste, et que change-t-il pour la confidentialité ?
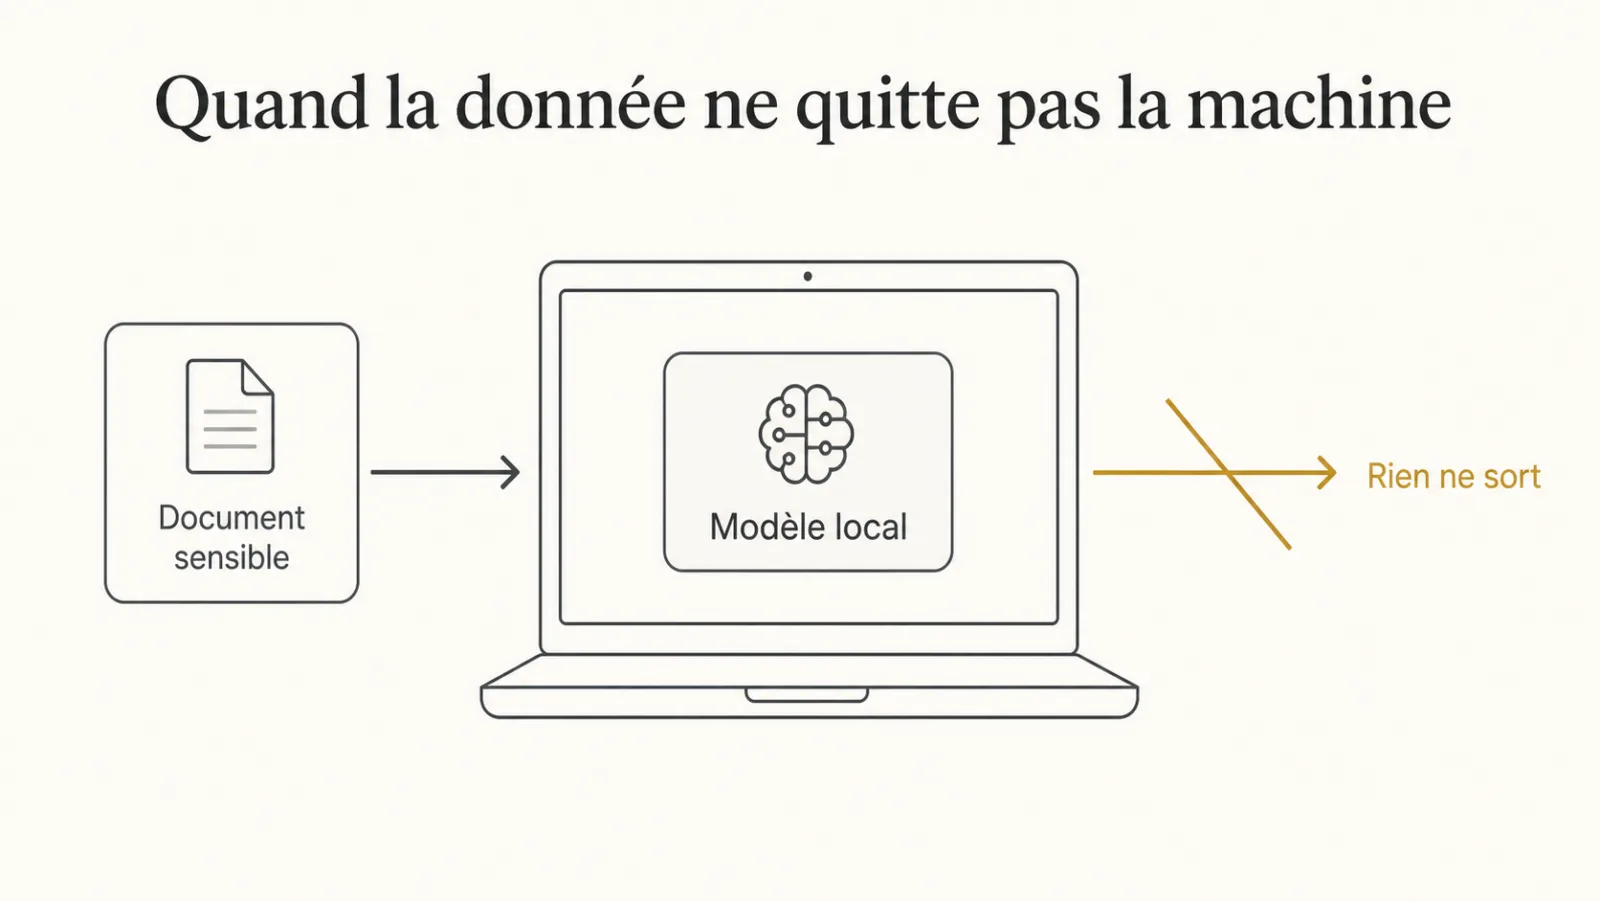
Un petit modèle sur poste est un modèle de langue de quelques milliards de paramètres qui tourne directement sur l’ordinateur de l’utilisateur, si bien qu’aucune donnée traitée ne quitte la machine. C’est une propriété structurelle, pas une garantie contractuelle.
Concrètement, le modèle est un fichier installé sur le poste, exécuté par un moteur d’inférence local, et appelé par une application comme le serait un service distant. La différence tient au trajet : la requête, le document et la réponse restent sur le disque et dans la mémoire de l’ordinateur. Il n’y a pas d’appel réseau vers un fournisseur.
La différence est considérable en discussion avec une direction juridique ou un responsable de la sécurité. Un traitement local ne demande ni analyse de transfert, ni clause de localisation, ni engagement de non-conservation. Il n’y a rien à encadrer, là où un service externe oblige à instruire les questions posées dans ce qu’on a le droit de mettre dans un prompt.
Cette propriété ouvre des usages qui restaient bloqués : traiter un document contenant des données de santé, préparer une note à partir d’un dossier contentieux, résumer des échanges internes sensibles. Elle prolonge l’arbitrage ouvert par l’arrivée de modèles compacts et performants, décrit dans le petit modèle change l’arbitrage.
Quelles tâches un modèle de poste sait-il traiter correctement ?
Un modèle de poste traite à un niveau utilisable l’extraction, la classification, la reformulation et le résumé court, mais pas l’analyse complexe ni le raisonnement en plusieurs étapes. Cette frontière s’est déplacée mais elle existe toujours.
Les tâches structurées passent bien parce que la réponse attendue est courte et contrainte. Extraire une date, classer un document, anonymiser un texte, reformuler dans un registre donné : un modèle de quelques milliards de paramètres y suffit.
Le résumé court fonctionne aussi, à condition de ne pas dépasser quelques pages en entrée.
Ce qui ne passe pas : le raisonnement en plusieurs étapes, l’analyse de cohérence entre documents, la synthèse d’un dossier volumineux. Ces tâches demandent un modèle et une fenêtre que le poste de travail ne fournit pas.
| Tâche | Modèle sur poste | Grand modèle via API |
|---|---|---|
| Extraire un champ (date, montant, partie) | Suffisant | Surdimensionné |
| Classer un document dans une typologie | Suffisant | Surdimensionné |
| Anonymiser un texte avant envoi | Suffisant, et seul acceptable sur données protégées | Pose la question du transfert |
| Reformuler dans un registre donné | Suffisant | Suffisant |
| Résumer quelques pages | Utilisable | Meilleur |
| Synthétiser un dossier volumineux | Hors de portée | Adapté |
| Vérifier la cohérence entre plusieurs documents | Hors de portée | Adapté |
La frontière se vérifie sur le jeu de tests, comme toujours, et elle se déplace à chaque génération. C’est le raisonnement de l’écart se resserre sur les tâches structurées.
Dans quels usages le modèle local s’impose-t-il ?
- L’anonymisation avant envoi, où le modèle local prépare ce qui partira ensuite. Voir anonymiser avant d’envoyer.
- Le tri de documents sensibles, où la classification décide de l’orientation sans que le contenu circule.
- Le travail hors ligne, en déplacement ou sur un site sans connexion fiable.
- Les démonstrations en contexte contraint, où l’on peut montrer sans faire signer quoi que ce soit.
Quelles limites pratiques faut-il poser avant de déployer un modèle local ?
La principale limite d’un modèle local est que sa performance dépend de la machine de chaque utilisateur, ce qui crée une hétérogénéité que les systèmes centralisés n’ont pas. C’est le principal obstacle au déploiement à grande échelle.
Un même traitement peut prendre quelques secondes sur un poste récent et une minute sur un poste de trois ans. L’expérience varie donc fortement d’un collaborateur à l’autre, sans que rien dans l’application ne l’explique.
S’y ajoute la question du déploiement : installer et mettre à jour un modèle sur plusieurs centaines de postes est un chantier d’administration classique, avec ses contraintes propres. Le fichier du modèle pèse plusieurs gigaoctets, sa version doit être connue pour chaque poste, et une mise à jour se planifie comme celle de n’importe quel logiciel.
Et une limite plus subtile : les traces d’usage restent sur les postes, ce qui complique la journalisation centrale exigée par ailleurs. Il faut décider explicitement ce qui remonte, les métadonnées d’usage, pas le contenu, et le documenter. Les principes de cette remontée sont ceux de l’observabilité des systèmes d’IA, appliqués à un parc dispersé plutôt qu’à un serveur unique.
Comment construire une architecture mixte entre modèle local et API ?
L’architecture mixte confie au modèle local tout ce qui touche aux données protégées et à une API l’analyse complexe sur le reste, ce qui donne plus de souveraineté réelle qu’un projet d’hébergement centralisé. Elle est aussi plus rapide à mettre en place.
Le modèle local sert de premier étage. Il classe, extrait, anonymise. Ce qu’il produit, un texte débarrassé de ses identifiants, ou une catégorie, peut ensuite partir vers un service externe si la tâche l’exige.
La mise en place suit un ordre simple :
- Classer les traitements selon la nature des données qu’ils manipulent : protégées, internes, publiques.
- Affecter chaque traitement à un étage : local pour les données protégées, distant pour l’analyse complexe sur des données qui peuvent sortir.
- Définir le contrat entre les deux étages : ce que le premier étage produit et ce qui, seul, a le droit de franchir la frontière.
- Tester ce contrat sur des cas réels, en vérifiant qu’aucun identifiant ne passe dans ce qui part.
- Prévoir le mode dégradé : ce que l’utilisateur peut encore faire quand le second étage est indisponible.
Cette architecture a une propriété appréciable : elle dégrade proprement. Si le service externe est indisponible, le premier étage continue de fonctionner et l’utilisateur garde une capacité réduite plutôt qu’aucune.
Elle suppose la même couche d’abstraction que le reste, ce qui permet de faire évoluer chaque étage indépendamment. C’est le principe posé dans la couche qui rend le modèle remplaçable, et il rejoint la logique de modèles ouverts et souveraineté : la souveraineté est une décision d’architecture avant d’être un choix de fournisseur.
Quel test faire avant tout déploiement large ?
Faire tourner le modèle sur le poste le plus ancien du parc, pas sur celui du développeur. La performance sur cette machine détermine l’expérience réelle et décide si le déploiement est envisageable.
Comment évaluer un modèle de poste avant de le généraliser ?
Évaluer un modèle de poste consiste à mesurer sa qualité sur les tâches réelles de l’organisation et sa vitesse sur les machines réelles du parc, deux mesures qui se font séparément. La première dit si le modèle convient, la seconde si le parc le supporte.
La qualité se mesure comme pour n’importe quel modèle : un jeu de cas représentatifs, avec la réponse attendue, rejoué à chaque changement. La méthode de construire un jeu de tests en une journée s’applique telle quelle. Une direction juridique qui veut classer ses courriers entrants prendra cinquante courriers réels déjà classés et comparera.
La vitesse se mesure sur un échantillon du parc : le poste le plus récent, un poste médian, le poste le plus ancien encore en service. On relève le temps de traitement de chaque cas du jeu de tests et la mémoire occupée pendant le traitement.
Les critères de décision tiennent en trois questions :
- La qualité sur le jeu de tests atteint-elle le seuil fixé avant l’essai ?
- Le temps de traitement sur le poste le plus ancien reste-t-il acceptable pour l’usage visé ?
- Le modèle laisse-t-il assez de mémoire aux applications que l’utilisateur garde ouvertes ?
Si l’une des trois réponses est négative, le déploiement large attend, ou se limite aux postes qui passent le test.
Quelles erreurs fréquentes faut-il éviter avec un modèle local ?
Les erreurs fréquentes avec un modèle local viennent presque toutes d’une confusion entre ce qui fonctionne sur la machine du développeur et ce qui fonctionne sur le parc réel. Elles se repèrent tôt si on les connaît.
- Tester sur un poste de développeur puis découvrir la lenteur au moment du déploiement.
- Confier au modèle local une synthèse de dossier qu’il ne sait pas faire, puis conclure que le local ne marche pas.
- Oublier la mise à jour : des postes qui tournent sur des versions différentes du modèle donnent des résultats différents sur le même document.
- Ne rien journaliser, ce qui interdit de savoir si l’outil est utilisé et sur quelles tâches.
- Laisser croire que tout est local alors qu’une partie du traitement part vers une API, ce qui détruit la confiance le jour où l’utilisateur le découvre.
La dernière erreur est la plus coûteuse. L’interface doit indiquer clairement, pour chaque fonction, si le traitement reste sur le poste ou non. C’est aussi un point qu’un audit IA examine en priorité, parce qu’il conditionne tout le reste du dossier de conformité.
Que change un modèle local pour la formation des équipes ?
Un modèle installé sur le poste de travail rend l’expérimentation possible sans autorisation préalable, ce qui accélère considérablement l’apprentissage collectif des équipes. C’est un effet secondaire important.
Dans une organisation contrainte, essayer quelque chose demande en général une validation : quelles données, quel service, quel contrat. Cette friction, légitime, empêche l’exploration.
Un modèle local supprime la friction pour toute une classe d’essais. Un collaborateur peut tester une idée sur ses propres documents sans engager quoi que ce soit, et c’est ainsi que les meilleurs cas d’usage émergent.
Cela suppose une règle claire sur ce qui reste local et ce qui ne l’est pas, et un minimum de littératie pour que chacun sache faire la différence, ce qui rejoint l’obligation de littératie passée inaperçue. C’est le sujet de former à tenir un système, pas à utiliser un outil, et celui des formations IA construites sur les outils réellement déployés.
Questions fréquentes
Quelles tâches un modèle de poste traite-t-il correctement ?
L’extraction, la classification, la reformulation, l’anonymisation et le résumé court. Le raisonnement en plusieurs étapes et l’analyse de cohérence entre documents restent hors de portée. La frontière se vérifie sur un jeu de tests propre à l’organisation.
Quel est le principal obstacle au déploiement d’un modèle local ?
L’hétérogénéité du parc : un même traitement prend quelques secondes sur un poste récent et une minute sur un poste ancien, sans que rien dans l’application ne l’explique à l’utilisateur. Le test sur le poste le plus ancien du parc tranche la question.
Comment journaliser un traitement local ?
En décidant explicitement ce qui remonte, les métadonnées d’usage, jamais le contenu, et en le documentant. C’est un point à traiter au cadrage, pas après le déploiement.
Faut-il choisir entre modèle local et API ?
Non. Un modèle local en premier étage pour les données protégées, une API pour l’analyse complexe sur ce qui peut sortir. Cette architecture dégrade proprement en cas d’indisponibilité du service externe.
Un modèle local supprime-t-il toute obligation de conformité ?
Il supprime les questions de transfert et de conservation chez un tiers, pas les autres. Le traitement de données personnelles reste un traitement, avec sa finalité, sa durée et ses droits d’accès. Il faut aussi documenter ce que le système fait et ce qu’il ne fait pas.
Comment savoir si le parc informatique peut faire tourner un modèle local ?
En mesurant le temps de traitement et la mémoire occupée sur trois postes : le plus récent, un poste médian et le plus ancien encore en service. Si le poste le plus ancien rend l’usage pénible, le déploiement se limite aux machines qui passent le test.
Sources
- Phi-3 Technical Report: A Highly Capable Language Model Locally on Your Phone, Microsoft, arXiv, avril 2024.
- Updates to Apple's On-Device and Server Foundation Language Models, modèle local d'environ 3 milliards de paramètres, Apple, 9 juin 2025.
- Gemma 3 Technical Report, modèles ouverts de 1 à 27 milliards de paramètres, Google DeepMind, arXiv, mars 2025.