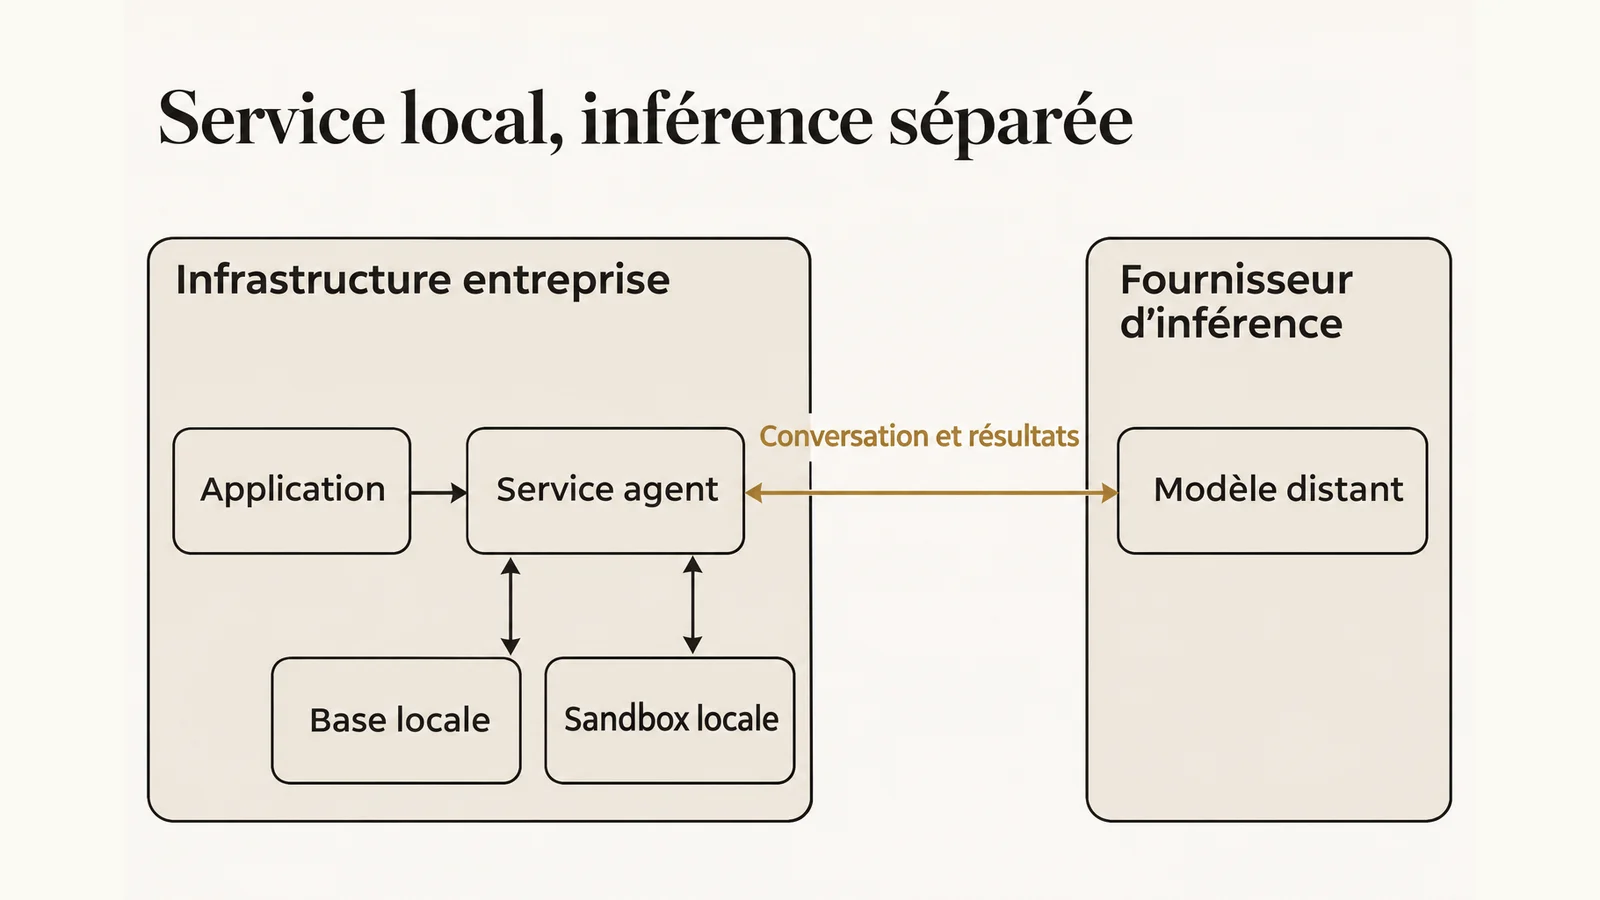
L’auto-hébergement de Claude Managed Agents consiste à exploiter le service agent et ses environnements d’exécution sur son infrastructure, tout en envoyant les appels au modèle vers un fournisseur d’inférence. Le lieu de stockage des sessions et le lieu de traitement par le modèle sont donc deux décisions distinctes.
Cette séparation intéresse une DSI qui veut maîtriser l’exploitation et les données conservées. Elle exige aussi de regarder ce qui traverse la frontière réseau. Voici l’annonce et les prérequis vérifiés, puis une méthode originale d’évaluation proposée par Anand Candassamy. Aucune installation ni validation de production n’est revendiquée ici.
Que propose Anthropic avec les Managed Agents auto-hébergés ?
Vérifié le 18 novembre 2026 : Anthropic annonce depuis le 12 novembre l’auto-hébergement du service Managed Agents, avec un accès à demander à son équipe commerciale.
Les notes de version du 12 novembre annoncent le service complet sur votre infrastructure, pas uniquement les sandboxes. Elles précisent que le fournisseur des appels modèle est choisi par l’organisation, Anthropic étant celui utilisé par défaut. L’annonce ne constitue pas une preuve d’accès immédiat pour toutes les organisations.
La documentation de l’auto-hébergement distingue les lieux d’exécution suivants. Le tableau décrit l’architecture documentée, pas une certification de confidentialité ni une équivalence fonctionnelle totale entre offres.
| Configuration | Service agent | Sandboxes et outils | Inférence |
|---|---|---|---|
| Sandboxes cloud par défaut | Anthropic | Anthropic | Anthropic |
| Sandboxes auto-hébergées seules | Anthropic | Votre infrastructure | Anthropic |
| Managed Agents auto-hébergés | Votre infrastructure | Votre infrastructure | Anthropic ou fournisseur choisi |
Dans la dernière configuration, le service contient l’API, la boucle agent et le stockage des agents, sessions et historiques. Le modèle n’est pas installé sur votre serveur du seul fait que ce service l’est. C’est la distinction centrale pour cadrer le projet.
Quelles données restent locales et lesquelles sont envoyées au modèle ?
Les sessions conservées sur votre infrastructure restent distinctes du contenu des requêtes modèle, qui comprend la conversation ainsi que les entrées et résultats des outils.
La page Data and access précise que le serveur contacte Anthropic quand la Claude API est son fournisseur d’inférence. Un autre fournisseur reçoit les appels à sa place. Elle indique aussi qu’Anthropic n’a pas d’accès distant au serveur ni à son journal.
Cette même page documente les destinations configurables : MCP, Git, identité, secrets et télémétrie notamment. Le réseau des workers constitue un périmètre séparé. Les sessions restent en base jusqu’à suppression ; cette suppression ne retire pas automatiquement sauvegardes et traces exportées. Les conditions du fournisseur s’appliquent aux échanges modèle.
Méthode proposée : cartographier le contenu réellement envoyé, sans assimiler un fichier local à une donnée nécessairement transmise. Identifier quels extraits rejoignent la conversation et quels résultats d’outils contiennent des informations sensibles. Notre article sur les petits modèles sur poste et les données locales aide à formuler une exigence de traitement strictement local, différente de l’hébergement du service.
Quels sont les prérequis pour démarrer un essai ?
Le démarrage documenté suppose une archive accessible sur demande, des identifiants d’inférence et un environnement Docker adapté ; le quickstart ne constitue pas un déploiement de production.
Le quickstart officiel demande l’archive de la release, une clé Claude API pour son parcours par défaut, Docker Engine récent avec le plugin Compose, openssl et le CLI ant. Il décrit un hôte x86-64 ou Arm avec au moins deux CPU, avec un ajustement prévu sur une machine plus petite.
Le premier démarrage nécessite des accès réseau à Docker Hub, aux dépôts Alpine et aux releases GitHub. La pile Compose est réservée au développement et sert du HTTP ; Anthropic recommande les deux charts Helm de la release pour la production. La documentation de l’auto-hébergement demande PostgreSQL 16 ou ultérieur ; sans base, les données en mémoire disparaissent au redémarrage.
Notre recommandation consiste à inventorier ces prérequis avant de demander un environnement d’essai. Le dossier doit nommer le responsable de la base, des secrets, du réseau et des mises à jour. Les capacités et limites de l’archive obtenue restent à vérifier : aucune configuration n’a été installée pour cet article.
Une sandbox auto-hébergée suffit-elle pour garder tout chez soi ?
Une sandbox auto-hébergée déplace l’exécution des outils, mais laisse le service agent chez Anthropic ; ce choix ne répond donc pas à toutes les exigences de localisation.
La documentation des sandboxes auto-hébergées décrit un worker local qui récupère les tâches, exécute les outils et renvoie leurs résultats au service. Les entrées et sorties continuent à circuler côté Anthropic. La page présente cette fonction en bêta.
Pour son quickstart, elle demande notamment un hôte Linux ou macOS avec /bin/bash et un accès HTTPS sortant. Elle recommande de garder la clé Claude API hors de l’hôte worker. Ces prérequis concernent ce parcours sandbox ; ils ne remplacent pas ceux du service complet.
Notre méthode de choix commence par l’exigence à satisfaire : exécuter un outil près des applications internes, conserver l’historique sur son infrastructure ou contrôler le fournisseur d’inférence. Écrire cette exigence évite de choisir l’option au nom le plus rassurant. La distinction entre agent et simple appel au modèle aide également à vérifier si une orchestration persistante est réellement nécessaire.
Quelles responsabilités de sécurité passent à votre équipe ?
L’auto-hébergement impose de traiter le serveur, la base et les workers comme des composants d’exploitation, avec des responsabilités explicites et des frontières de confiance vérifiées.
La documentation précise que le shell dispose des permissions et du réseau du worker : le worker ne crée pas lui-même l’isolation. Celle-ci dépend du conteneur ou de la machine qui l’accueille. Le fonctionnement documenté ne doit donc pas être confondu avec un confinement automatique de n’importe quel hôte.
Le guide Secure your deployment recommande de limiter le réseau, réduire les outils activés, protéger les identifiants, encadrer les actions risquées et prévoir des limites ainsi qu’un arrêt. Ses recommandations doivent être appliquées en tenant compte du mode d’hébergement retenu.
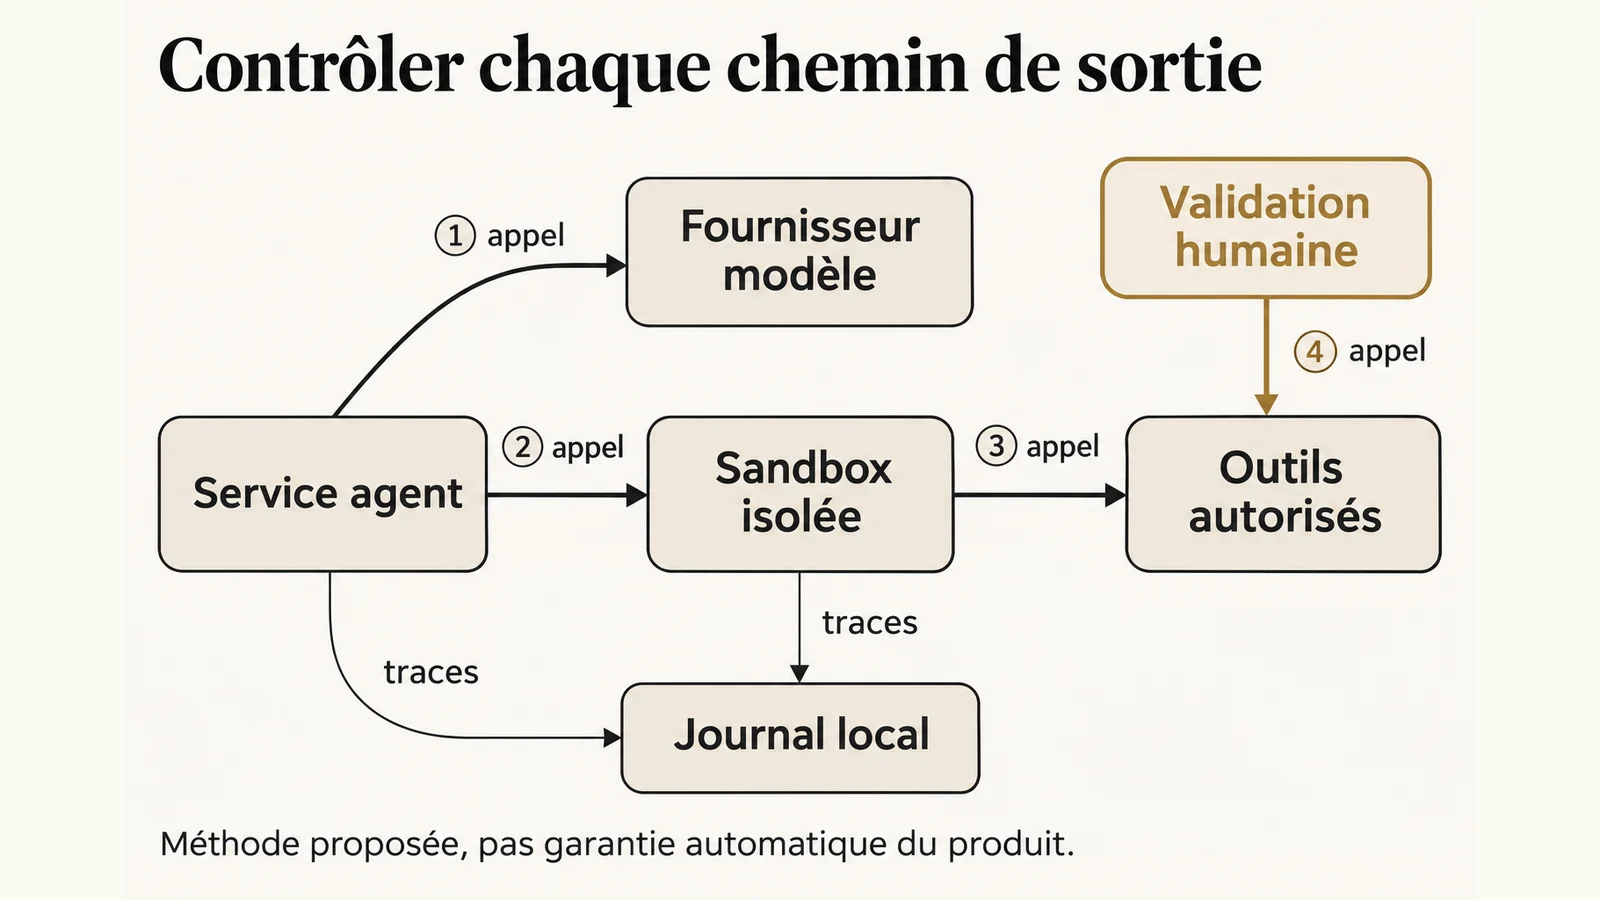
Méthode proposée : associer chaque pouvoir de l’agent à un responsable capable de le retirer. Documenter l’accès lecture, l’écriture, l’exécution de commandes et les communications externes. Tester un refus pour chaque chemin sensible. Notre protocole sur l’injection de prompt indirecte complète cette recette avec des contenus hostiles préparés dans un environnement autorisé.
Comment vérifier les flux sans utiliser de données sensibles ?
Une recette de flux peut commencer avec des documents artificiels et des marqueurs reconnaissables, afin d’observer les transmissions sans exposer de véritables dossiers métier.
La séquence suivante est une méthode originale proposée, pas un test déjà exécuté ni une exigence Anthropic. Les données de recette doivent être explicitement autorisées pour les destinations employées.
- Préparer un document artificiel avec un contenu facilement identifiable.
- Définir ce que l’outil peut lire et ce que le modèle doit recevoir.
- Exécuter une tâche limitée et relever les événements disponibles.
- Comparer les requêtes et les sorties observables au périmètre prévu.
- Révoquer un accès, interrompre la session et vérifier le comportement.
- Examiner les copies conservées et documenter leur suppression.
Si un proxy masque le contenu, il faut signaler cette limite plutôt que conclure à l’absence de données transmises. La preuve recherchée relie une action, son résultat et une destination identifiable.
La même discipline s’applique aux connecteurs. La recette de sécurité MCP permet de vérifier les permissions et la révocation de ces dépendances. Un accès réseau autorisé ne doit pas devenir une autorisation implicite de transmettre n’importe quel contenu.
Comment préparer l’exploitation avant une mise en production ?
La décision de production devrait reposer sur une capacité de restauration, de mise à jour et de contrôle des accès, en plus d’une réponse métier satisfaisante.
Méthode proposée : produire une fiche d’exploitation qui indique qui maintient le service, qui restaure la base et qui intervient si un worker reste bloqué. Préparer le scénario où l’inférence distante est indisponible : l’utilisateur doit savoir si sa tâche attend, échoue ou nécessite une reprise.
Conserver une configuration de référence et faire passer les évolutions par la même recette. Le changement peut concerner le modèle, les instructions, le serveur ou les outils ; chacun doit pouvoir être identifié dans les preuves. Notre démarche pour migrer un agent sans régression structure ce contrôle.
Tester aussi la restauration et l’effacement comme des opérations distinctes. Une restauration techniquement réussie n’établit pas que tous les droits et toutes les tâches reprennent correctement. Le résultat attendu est une décision d’exploitation explicite, avec des limites connues, plutôt qu’une simple capture d’une conversation réussie.
Quand choisir le service complet plutôt que les seules sandboxes ?
Le service complet se justifie si une exigence vérifiable porte sur son exploitation ou son stockage et si l’équipe peut assumer les responsabilités correspondantes.
Notre grille de décision propose de confronter trois documents : exigence métier, carte des flux et fiche d’exploitation. Si le besoin porte seulement sur l’exécution d’un outil interne, étudier d’abord le périmètre nécessaire. Si le besoin exige une inférence strictement locale, ne pas conclure que cette annonce y répond.
Il faut également obtenir les conditions d’accès, de licence et de support applicables à votre organisation. Cet article ne déduit aucun prix, aucune garantie contractuelle et aucune certification du mot « auto-hébergé ». Les conditions non confirmées restent des réserves de décision.
Pour préparer cette discussion, les tests avant adoption des agents Claude donnent un cadre complémentaire. Le bon résultat peut être un pilote limité, un report ou une autre architecture. La décision devient défendable lorsqu’elle relie une contrainte précise à une preuve, un responsable et un moyen de revenir en arrière.
Questions fréquentes
Claude Managed Agents auto-hébergé installe-t-il le modèle chez moi ?
Non. La documentation sépare le service et les sandboxes du fournisseur d’inférence. Héberger le service ne prouve pas que le modèle s’exécute localement. Il faut examiner la destination réelle des appels.
Les résultats des outils peuvent-ils quitter mon infrastructure ?
Oui. Les appels modèle comprennent la conversation, les entrées et les résultats d’outils. Notre recommandation est d’observer les contenus intégrés aux requêtes avant d’autoriser des documents sensibles.
Le téléchargement est-il ouvert immédiatement à tout le monde ?
Les notes de version demandent de contacter l’équipe Anthropic pour obtenir l’accès. Cet article ne confirme ni votre éligibilité ni les conditions commerciales de votre organisation.
Peut-on utiliser le quickstart Compose en production ?
Le quickstart le présente comme un environnement de développement. Le passage en production demande une architecture d’exploitation et une recette adaptées ; le fonctionnement d’une session de démonstration ne suffit pas.
Une sandbox locale empêche-t-elle toutes les fuites ?
Non. Il faut examiner les appels au modèle, les sorties réseau des outils et les copies dans les journaux. Notre méthode traite ces chemins séparément et demande une preuve de refus pour les destinations interdites.
Quelle preuve demander avant de valider le projet ?
Un dossier reliant tâche métier, flux autorisés, résultat attendu, refus, arrêt et restauration. Cette proposition de recette ne remplace ni les conditions du fournisseur ni la validation de votre équipe sécurité.
Sources
- Anthropic, notes de version du 12 novembre 2026, lues le 18 novembre.
- Anthropic, Self-hosted Claude Managed Agents, lu le 18 novembre 2026.
- Anthropic, quickstart du service auto-hébergé, lu le 18 novembre 2026.
- Anthropic, Data and access, lu le 18 novembre 2026.
- Anthropic, Self-hosted sandboxes, lu le 18 novembre 2026.
- Anthropic, Secure your deployment, lu le 18 novembre 2026.
Analyse et méthode proposées par Anand Candassamy au 18 novembre 2026.