Qu’est-ce que la fenêtre d’un million de jetons de Gemini 1.5 ?
Le 15 février 2024, Google présente Gemini 1.5 Pro avec une fenêtre standard de 128 000 jetons et un million accessible à un groupe restreint en préversion privée. L’ordre de grandeur dépasse ce que la plupart des organisations ont besoin de traiter en une fois.
La fenêtre de contexte désigne la quantité de texte, d’image ou de son qu’un modèle peut recevoir dans une seule requête. Il faut toutefois lire l’annonce avec précision : la fenêtre standard de Gemini 1.5 Pro est de 128 000 jetons, et le million n’est ouvert qu’en préversion privée, à un groupe restreint de développeurs et d’entreprises. Google donne comme équivalences pour le million plus de 700 000 mots, une heure de vidéo ou onze heures d’audio, selon le type de contenu.
À ce niveau, la question cesse d’être « est-ce que mon document tient » pour devenir « est-ce que le modèle exploite réellement ce que je lui donne ». Ce n’est pas la même question, et la réponse n’est pas garantie par l’annonce.
Une fenêtre est une capacité d’entrée. Ce que le modèle en fait, s’il retrouve un fait placé au milieu, s’il relie deux informations distantes de mille pages, relève de la mesure, pas de la spécification. La même prudence valait déjà pour les cent mille jetons de Claude 2.
Pourquoi une fenêtre annoncée n’est-elle pas une fenêtre exploitable ?
Une fenêtre annoncée indique ce que le modèle accepte en entrée, alors qu’une fenêtre exploitable désigne ce qu’il retrouve et utilise correctement sur vos propres documents, et l’écart entre les deux ne se connaît qu’en le mesurant. Les tests publiés par les fournisseurs ne suffisent pas à le connaître.
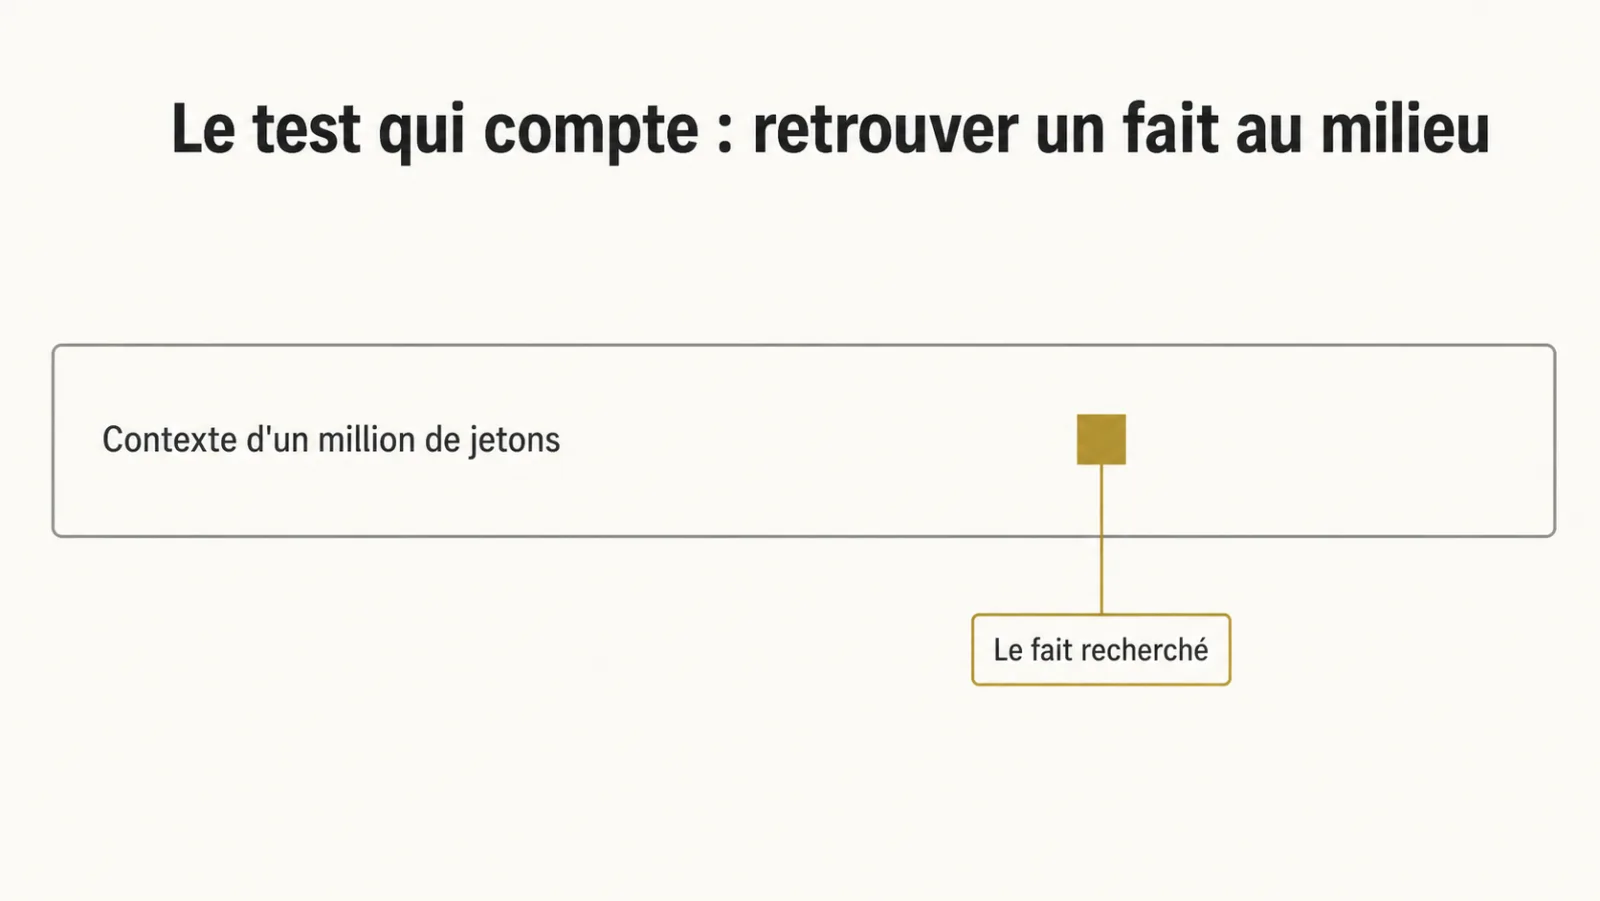
Google met en avant un test dit de « l’aiguille dans la botte de foin » : une phrase isolée est cachée dans un très long contexte, et le modèle doit la retrouver. Selon l’annonce, Gemini 1.5 Pro la retrouve dans 99 % des cas jusqu’à un million de jetons. Cette performance revendiquée porte sur une tâche contrôlée de récupération ; elle ne démontre pas la qualité d’une synthèse métier.
Vos documents posent d’autres difficultés. Le fait utile ressemble à ses voisins, il se répète avec des variantes d’une version à l’autre, et la question demande souvent de relier deux passages éloignés plutôt que d’en retrouver un seul. Les travaux de Liu et ses coauteurs publiés en 2023 sous le titre « Lost in the Middle » ont montré, sur les modèles qu’ils étudiaient, qu’une information placée au milieu d’un long contexte était moins bien exploitée que celle placée au début ou à la fin.
Rien ne dit que Gemini 1.5 reproduit ce défaut, et rien ne dit qu’il l’évite sur vos contenus. C’est précisément ce que le test doit établir.
Comment tester l’exploitation d’un long contexte ?
Le test de la fenêtre exploitable consiste à placer un fait vérifiable à différentes profondeurs d’un contexte construit avec vos documents réels, à poser une question qui en dépend, puis à compter les échecs par position. Ce protocole explore certaines limites ; ajoutez des questions métier avant de valider l’usage.
La méthode est simple à mettre en œuvre :
- Constituer un contexte long à partir de documents réels du domaine visé, de la taille que l’usage prévu enverra vraiment.
- Insérer une phrase factuelle inventée mais plausible, rédigée dans le style des documents, pour qu’elle ne se distingue pas de son environnement.
- Poser une question qui dépend de ce fait, formulée comme un utilisateur la poserait, sans reprendre les mots exacts de la phrase insérée.
- Déplacer la phrase au début, au quart, au milieu, aux trois quarts et à la fin, en répétant chaque position plusieurs fois.
- Ajouter un test à deux faits, placés loin l’un de l’autre, dont la réponse exige la combinaison.
- Noter le taux d’échec par position et la latence observée, puis conserver le protocole pour le rejouer.
Les résultats varient selon le modèle et selon le type de contenu. Comparez un contexte homogène et un ensemble de documents disparates, sans présumer lequel réussira le mieux. C’est pourquoi le test se fait sur vos documents et non sur un texte de démonstration.
Ce protocole doit être rejoué à chaque changement de modèle, au même titre que le reste du jeu de tests décrit dans l’évaluation continue.
Quels usages examiner avec une très grande fenêtre ?
Une très grande fenêtre permet d’essayer des analyses globales sans récupérer chaque passage au préalable, mais chaque usage doit rester compatible avec les droits et les résultats observés.
- Analyser une base de code qui tient dans la fenêtre pour en produire une cartographie ou repérer des incohérences, sans découpage préalable.
- Traiter un dossier volumineux d’un seul tenant : un dossier d’appel d’offres, un dossier patient, un dossier contentieux.
- Comparer des versions distantes d’un même document, en conservant les références de chaque version.
- Réduire la complexité d’architecture sur les corpus de taille moyenne, en remplaçant une chaîne de récupération par un envoi direct. Voir le RAG, la seule architecture qui tienne.
Combien coûte une requête qui remplit un million de jetons ?
Le coût d’un million de jetons doit être calculé avec le tarif effectivement applicable au service, et l’annonce de Gemini 1.5 ne suffit pas à établir votre facture. Au 15 février 2024, ne reprenez pas un tarif publié ultérieurement.
On peut construire un scénario avec un autre tarif connu, sans le présenter comme celui de Gemini. L’entrée de GPT-4 Turbo a été annoncée à 0,01 dollar pour mille jetons en novembre 2023. Par simple multiplication, un million représenterait dix dollars d’entrée à ce prix ; GPT-4 Turbo n’accepte toutefois pas cette taille de contexte. L’exemple est un calcul hypothétique, auquel il faudrait ajouter la sortie.
Comparez le coût du contexte complet au coût d’extraits ciblés, avec le nombre réel de requêtes. Mesurez aussi la latence : Google annonce travailler à l’améliorer, sans que cela fixe un délai garanti pour vos documents.
La capacité maximale n’est pas une obligation de remplissage. Le raisonnement économique est développé dans une grande fenêtre reste une facture.
Comment décider si la fenêtre pleine convient au parcours ?
La fenêtre pleine convient au parcours seulement si les tests de qualité, de coût et de délai réussissent sur les documents et les demandes réellement prévus. Un traitement ponctuel peut accepter plus d’attente qu’une conversation. Comparez néanmoins les options avant d’imposer la récupération ciblée à tous les cas.
Quand préférer la fenêtre pleine à une chaîne de récupération ?
Une fenêtre complète peut éviter une chaîne de récupération pour un corpus qui tient dans la limite disponible, mais son intérêt dépend de la qualité, du volume et du coût observés. Il faut savoir reconnaître cette classe.
Elle regroupe par exemple une documentation produit, un référentiel réglementaire, un manuel technique : quelques centaines de pages, qui changent rarement. Pour ces corpus, envoyer l’ensemble à chaque requête peut être plus simple, moins coûteux à construire que de bâtir une chaîne de récupération, avec ses choix de découpage des documents et son index à maintenir.
Le critère de bascule est le rapport entre le coût de la fenêtre pleine, multiplié par le nombre de requêtes, et le coût de construction et de maintenance d’une chaîne de récupération. Peu de pages et peu de requêtes font pencher la balance vers la fenêtre pleine ; un gros volume de requêtes ou un corpus qui dépasse la fenêtre la ramène vers la récupération. Le seuil exact dépend de vos tarifs et de vos volumes, et il se calcule.
| Critère | Fenêtre pleine | Récupération ciblée |
|---|---|---|
| Taille du corpus | Tient largement dans la fenêtre | Dépasse la fenêtre ou grossit vite |
| Fréquence des requêtes | Faible, traitements ponctuels ou par lot | Élevée, usage interactif |
| Latence acceptable | À mesurer sur le contexte complet | À mesurer avec recherche et génération |
| Stabilité du corpus | Change rarement | Mis à jour souvent |
| Type de question | Vue d’ensemble, comparaison de passages éloignés | Fait précis, passage localisé |
| Effort d’ingénierie | Faible au départ | Découpage, index et tests à maintenir |
Ce calcul mérite d’être fait explicitement au cadrage, plutôt que de construire une architecture par réflexe. C’est l’un des points qu’examine un audit de système d’IA avant tout passage en production.
Quelles erreurs faussent l’évaluation d’une grande fenêtre ?
Les erreurs qui faussent l’évaluation d’une grande fenêtre de contexte consistent presque toutes à tester sur un cas plus facile que l’usage réel, puis à généraliser le résultat. Elles sont évitables dès la conception du test.
- Reprendre le test du fournisseur au lieu de construire le sien : ses résultats ne couvrent pas automatiquement les ambiguïtés de vos documents.
- Tester une seule position du fait inséré, ce qui laisse les autres profondeurs sans contrôle.
- Poser la question avec les mots exacts de la phrase insérée, ce qui transforme un test de compréhension en simple recherche de chaîne.
- Ignorer la latence et le coût pendant le test, alors qu’ils décident de l’usage possible autant que la qualité.
- Conclure une fois pour toutes : un changement de version du modèle peut modifier le résultat, d’où l’intérêt de garder le protocole.
Ces erreurs sont les mêmes que celles qui font échouer beaucoup de prototypes au moment de passer en production, détaillées dans sortir du prototype, les cinq verrous.
Une formation à l’IA peut apprendre à distinguer capacité annoncée, résultat d’essai et décision d’architecture.
Quelles questions poser avant d’utiliser le million de jetons ?
Une fenêtre d’un million de jetons est-elle entièrement exploitable ?
Pas nécessairement. Google revendique un résultat favorable dans son test contrôlé de récupération. Les documents réels ajoutent contradictions et questions de synthèse. Testez plusieurs positions, contenus et types de demande avant de conclure pour votre usage.
Comment tester la fenêtre exploitable ?
En insérant un fait vérifiable à différentes profondeurs d’un contexte long constitué de vos documents réels, puis en le redemandant avec d’autres mots. Un second test, à deux faits éloignés, vérifie la capacité à relier des passages. Le taux d’échec par position donne directement la réponse.
Le million de jetons est-il disponible pour tout le monde ?
Non, pas à l’annonce. La fenêtre standard de Gemini 1.5 Pro est de 128 000 jetons, et le million n’est ouvert qu’en préversion privée à un groupe restreint de développeurs et d’entreprises. Il faut en tenir compte avant de bâtir une architecture qui en dépend.
Quand la fenêtre pleine est-elle préférable au RAG ?
Elle peut convenir à un corpus contenu dans la fenêtre et peu interrogé, si les essais confirment qualité, coût et délai acceptables. Comparez ces résultats à la récupération ciblée sans supposer une option toujours supérieure.
Peut-on utiliser la fenêtre pleine en conversation ?
Cela dépend des délais observés et du budget du parcours. L’annonce ne suffit pas à exclure toute conversation ni à valider l’interactivité. Mesurez des requêtes représentatives et prévoyez le comportement en cas d’attente excessive.
Une grande fenêtre rend-elle le RAG inutile ?
Non. Le contexte complet peut simplifier certains projets, mais la récupération reste une option pour sélectionner des passages, appliquer les droits et gérer des fonds volumineux. Le choix doit être testé avec les contraintes du système.