Une panne Outlook est une interruption de consultation, de synchronisation ou de traitement des messages dont la cause peut appartenir au poste, au compte ou au service de messagerie. La première décision consiste à isoler ce périmètre avant de modifier la configuration.
Quand la messagerie alimente un agent IA, des demandes peuvent rester en attente et des actions être rejouées. Voici le diagnostic, puis la méthode proposée par Anand Candassamy pour maîtriser la reprise.
Quel est l’état des correctifs et comment vérifier une panne Microsoft 365 ?
Vérifié le 14 novembre 2026 : Microsoft déclare résolu l’incident Microsoft 365 des 12 et 13 novembre ; consultez toujours l’état de service de votre organisation avant toute réparation locale.
Microsoft oriente les administrateurs vers État de santé > État des services dans le centre d’administration. Si celui-ci est inaccessible, sa page publique de statut constitue un autre point de consultation. Lors de cette vérification documentaire, cette page exigeait JavaScript et ne permettait pas de lire un bulletin précis. Aucune cause, durée ou résolution de panne du 12 novembre n’est donc avancée ici.
Lors de la première rédaction, le 13 novembre, cette page ne livrait pas de bulletin lisible. Le 14 novembre, son encart Microsoft 365 (Consumer) publie un statut final « Service restored » : l’incident « Users may be unable to access or perform several actions in Microsoft 365 services » a commencé le jeudi 12 novembre 2026 à 10 h 05 UTC et pris fin le vendredi 13 novembre 2026 à 16 h 10 UTC, une fois les services rétablis et le retard de messages traité. Microsoft n’y publie ni cause ni rapport post-incident ; aucune cause n’est donc avancée ici, et le bulletin de votre propre organisation reste la référence pour votre périmètre.
Comment savoir si Outlook est en panne chez Microsoft ou sur mon poste ?
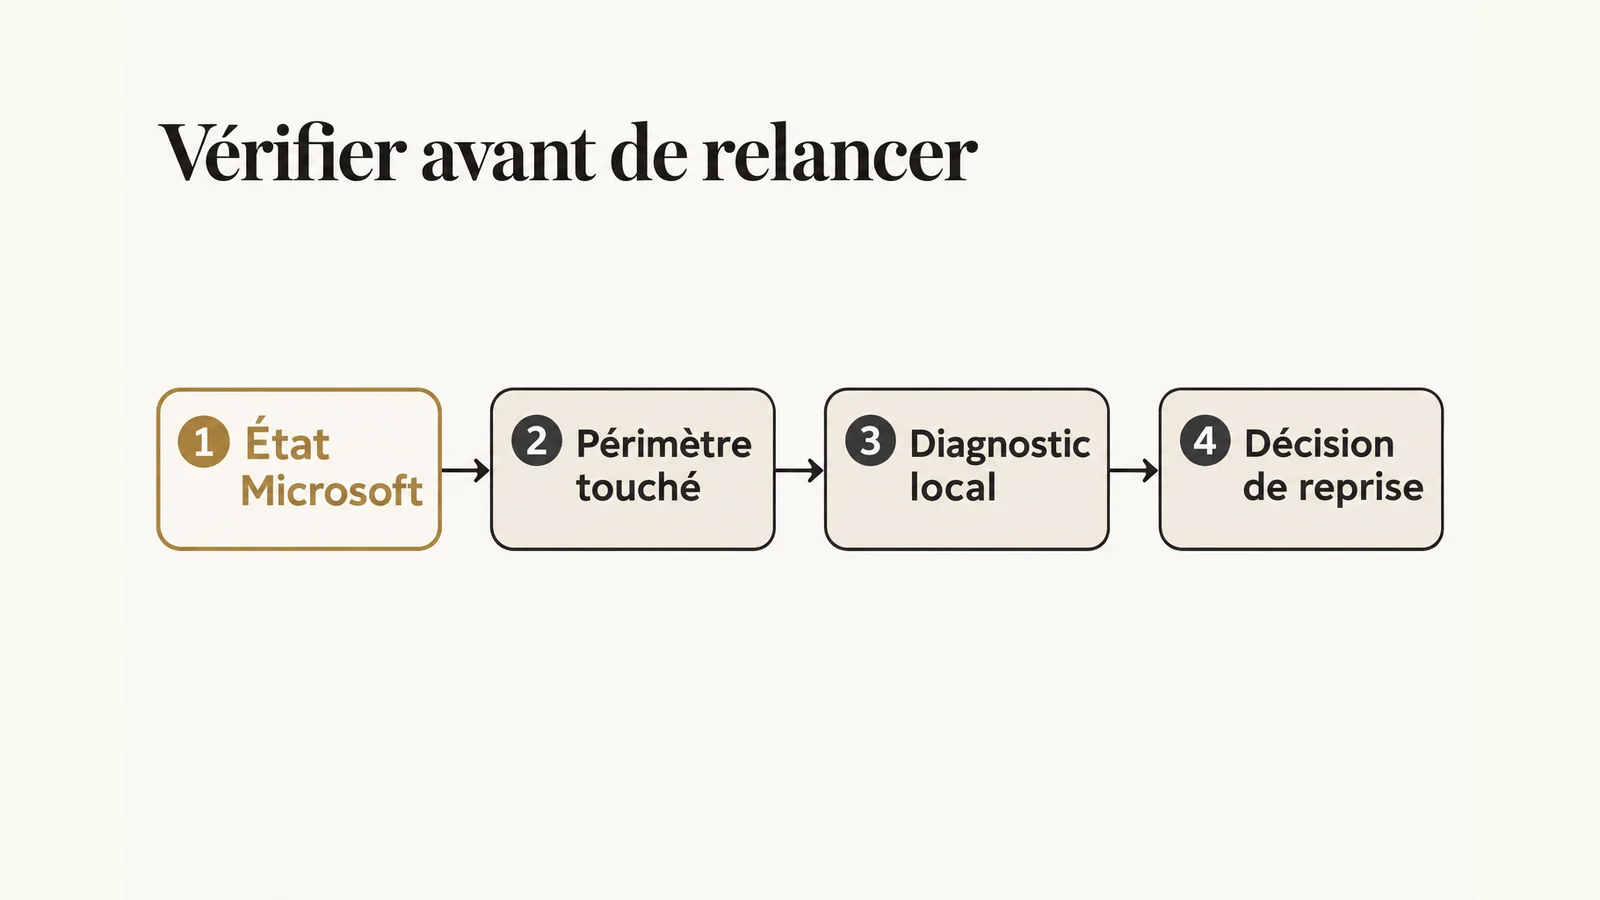
Comparez le même compte sur plusieurs accès autorisés, puis comparez les utilisateurs touchés, afin de formuler une hypothèse précise sans transformer un indice en certitude.
Cette grille est une méthode de triage proposée par Anand, pas un diagnostic automatique Microsoft. Notez ce qui échoue : ouvrir Outlook, s’authentifier, consulter un message récent ou envoyer une réponse. Un écran visible ne prouve pas que les nouveaux messages arrivent. Utilisez un message de test neutre et vérifiez sa réception effective.
| Observation | Hypothèse à explorer | Vérification utile | Première décision |
|---|---|---|---|
| Application bloquée, web utilisable | Poste ou client | Même compte, même opération | Repli web autorisé |
| Plusieurs utilisateurs touchés | Service ou dépendance commune | État officiel et périmètre réseau | Centraliser le signalement |
| Un compte touché partout | Compte ou accès | Erreur exacte et droits | Escalader au support interne |
| Agent en échec, messagerie utilisable | Connecteur ou appel API | Code HTTP et opération | Isoler le traitement |
Gardez une variable stable pendant chaque comparaison. Changer simultanément de compte, de réseau et de client rend le résultat peu exploitable. L’analyse du coût d’un incident IA aide à prioriser ensuite les fonctions métier réellement interrompues.
Que faire immédiatement quand Outlook ne fonctionne plus ?
Préservez les demandes en cours, choisissez un canal de travail autorisé et suspendez les envois incertains avant de multiplier les tentatives ou les changements techniques.
Le repli doit correspondre au résultat du diagnostic. Outlook web peut aider si le client seul est affecté ; il ne constitue pas une garantie face à une indisponibilité du service commun. La procédure ci-dessous relève de la méthode Anand. Elle vise surtout à éviter que chaque collaborateur improvise sa propre reprise.
- Relever le symptôme, le compte concerné et le dernier fonctionnement constaté.
- Prévenir le référent interne par un canal déjà approuvé et accessible.
- Mettre les demandes urgentes dans un suivi partagé autorisé, avec un responsable.
- Conserver les brouillons et identifier les messages dont l’envoi reste incertain.
- Informer les équipes du mode de travail retenu et du prochain point de situation.
Lorsqu’une personne reprend manuellement une demande habituellement automatisée, elle doit le signaler dans ce suivi. Sinon, le retour du connecteur peut déclencher une seconde réponse. Les limites à fixer avant l’autonomie d’un agent s’appliquent aussi pendant ce fonctionnement temporaire.
Pourquoi une panne de messagerie peut-elle bloquer un agent IA ?
Un agent chargé de lire des messages ou d’y répondre dépend de chaque accès nécessaire à sa tâche, même lorsque son modèle reste disponible.
Prenons un scénario illustratif : une boîte partagée reçoit une demande, un connecteur récupère la pièce jointe, puis un agent prépare une réponse soumise à validation. Si la récupération échoue, lancer la rédaction avec le seul objet du message change la qualité du travail. La réponse peut sembler cohérente tout en ignorant le document décisif.
La méthode proposée consiste à représenter ces dépendances et à définir, pour chacune, le résultat attendu en cas d’échec. Une pièce indisponible doit produire une demande suspendue identifiable. Un brouillon incomplet doit rester distinct d’une proposition prête à valider. La définition d’un agent en entreprise permet de préciser quelles étapes appartiennent réellement à son périmètre.
Pour chaque tâche, nommez aussi la personne qui peut décider d’un traitement manuel. Ce choix n’appartient pas implicitement au modèle. La continuité exige une autorité opérationnelle, un accès aux informations nécessaires et une trace de la décision, autant qu’un connecteur capable de redémarrer.
Comment gérer les erreurs Microsoft Graph sans aggraver la panne ?
Traitez les erreurs selon leur code et respectez les délais de reprise documentés, puis encadrez les tentatives par une règle métier explicite.
Microsoft Graph distingue notamment authentification invalide, accès refusé et indisponibilité temporaire dans sa documentation des erreurs. Rejouer une demande privée de droits ne répare pas son autorisation. Conservez le code structuré reçu pour orienter le traitement ; le texte descriptif ne doit pas devenir la condition technique dont dépend le programme.
Pour une limitation HTTP 429, Microsoft recommande de respecter Retry-After. Sans cet en-tête, sa documentation de limitation recommande un espacement exponentiel des tentatives. Dans un lot, la réponse globale peut être HTTP 200 alors que certaines requêtes reçoivent un code 429. Reprenez chaque requête échouée selon son Retry-After, fourni dans le contenu JSON ; un nouveau lot peut attendre le plus long délai indiqué. Les SDK ne relancent pas automatiquement ces requêtes limitées au sein d’un lot.
Méthode Anand : définir un budget de reprise compatible avec l’urgence de la demande, puis transférer les échecs persistants à une file d’examen. Une relance technique autorisée ne donne pas le droit d’envoyer indéfiniment une réponse devenue périmée. La recette d’un agent en production doit couvrir ces décisions.
Comment reprendre les messages sans envoyer de réponses en double ?
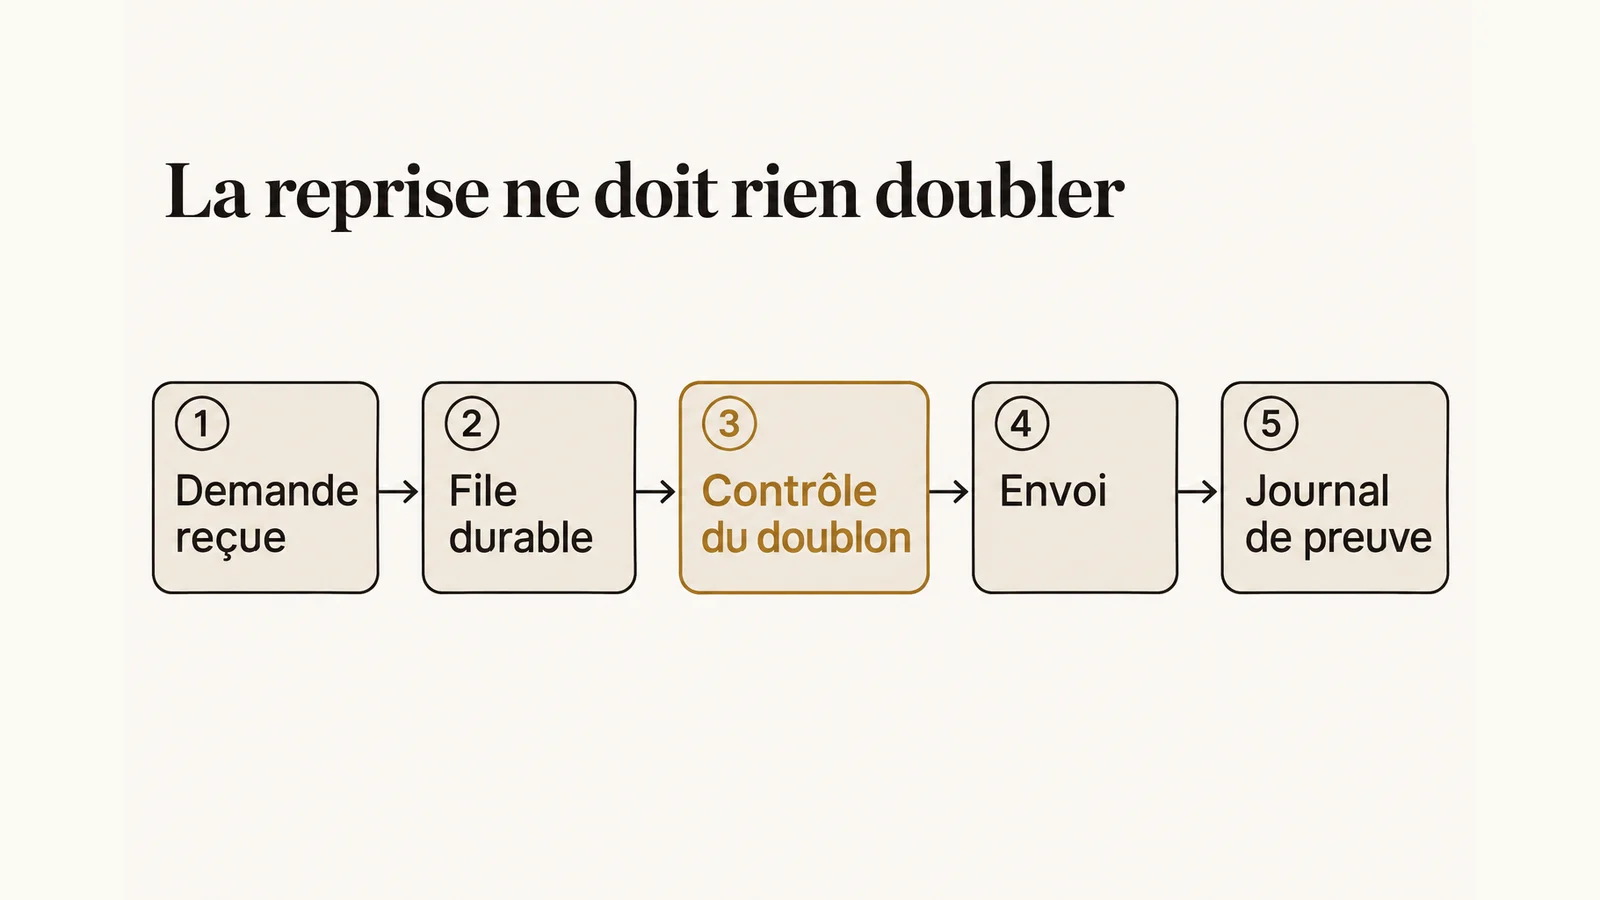
Conservez l’identité de chaque opération et vérifiez son résultat avant de la rejouer, particulièrement lorsqu’une interruption laisse planer un doute sur un envoi.
L’idempotence désigne ici une propriété recherchée : répéter une demande de traitement ne doit pas multiplier son effet métier. Il s’agit d’un objectif d’architecture proposé par Anand, pas d’une garantie générale de Microsoft Graph. Un délai dépassé après une demande d’envoi peut laisser le connecteur sans preuve suffisante pour conclure à un échec.
Dans le scénario illustratif d’une boîte commerciale, associez la demande entrante, la réponse préparée et la décision d’envoi à un identifiant interne stable. Enregistrez séparément les états « préparé », « validé », « envoi demandé » et « résultat confirmé ». Si la connexion tombe au mauvais moment, placez l’opération en rapprochement plutôt que de recréer immédiatement une réponse.
Ce rapprochement peut exiger une vérification humaine des traces disponibles. L’état « incertain » est utile : il rend visible une situation qui serait autrement transformée en faux succès ou en faux échec. Les tests de reprise des agents et robots prolongent cette logique en couvrant les interruptions au milieu d’un parcours.
Quelles preuves garder pendant une panne Outlook ?
Gardez un journal qui relie symptômes, décisions et résultats sans recopier inutilement les messages, afin de pouvoir expliquer la reprise et traiter les désaccords.
La méthode Anand recommande de séparer le journal de service du journal métier. Le premier conserve le compte technique concerné, l’opération, le code reçu et la tentative suivante prévue. Le second indique quelle demande attend, qui en est responsable et si une intervention manuelle a déjà eu lieu. Leur rapprochement doit rester possible par identifiant.
Évitez de faire circuler des captures contenant une boîte entière pour documenter une erreur ponctuelle. Une trace ciblée, lisible par les personnes habilitées, suffit souvent à l’investigation. Ne consignez pas les secrets d’accès dans ce journal. L’objectif est de comprendre le parcours de la demande, pas de constituer une copie parallèle de la messagerie.
Préparez enfin un message interne distinguant les fonctions disponibles, les tâches suspendues et les décisions attendues. « Outlook fonctionne de nouveau » ne dit rien du stock accumulé ni des dossiers repris manuellement. Une communication utile précise ce qui a été vérifié et ce qui reste à rapprocher avant clôture.
Quand peut-on relancer les agents après le retour d’Outlook ?
Relancez les traitements lorsque le parcours métier et les opérations incertaines ont été vérifiés, avec une capacité de suspension conservée pendant la reprise.
La méthode proposée commence par une demande de test maîtrisée : réception, accès aux pièces, préparation, validation, puis résultat de l’action. Faites ensuite reprendre un ensemble limité de tâches suivies. Le choix de cet ensemble dépend de leur sensibilité et du contrôle disponible, sans seuil universel prétendument imposé par l’éditeur.
Avant de vider la file, éliminez les demandes déjà traitées manuellement et réévaluez celles dont le contexte a changé. Une proposition commerciale peut avoir expiré ; un rendez-vous peut avoir été déplacé. La présence d’une tâche dans la file prouve une intention passée, pas la pertinence actuelle de son exécution.
Clôturez après rapprochement des demandes restantes et attribution des exceptions. Pour préparer ce travail en amont, un audit du système IA peut examiner dépendances, mécanismes de reprise et preuves attendues. Le livrable recherché est une procédure exécutable par l’équipe lorsque la messagerie et l’automatisation ne reviennent pas au même rythme.
Que vérifier encore en cas de panne Outlook ?
Une application Outlook qui s’ouvre prouve-t-elle que tout fonctionne ?
Non. Vérifiez une opération complète avec un message neutre : réception récente, consultation et résultat de l’envoi. Dans la méthode proposée, cette preuve est distincte de la simple ouverture de l’application.
Faut-il réinstaller Outlook dès la première erreur ?
Commencez par isoler le périmètre et consulter le référent informatique. Une modification du poste sans hypothèse documentée peut compliquer la comparaison et ne résout pas nécessairement la dépendance indisponible.
Le Message Center remplace-t-il l’état des services ?
Microsoft présente le Message Center comme un outil de préparation aux changements. Pour un dysfonctionnement en cours, consultez d’abord l’état des services et rattachez le signalement au périmètre réellement touché.
Un agent peut-il continuer à rédiger pendant la panne ?
La méthode proposée l’autorise seulement si les informations nécessaires restent disponibles et si le résultat est clairement identifié. Une pièce jointe manquante doit empêcher de présenter un brouillon comme complet.
Faut-il rejouer toute la file après le rétablissement ?
Non. Rapprochez les opérations incertaines, retirez les demandes déjà prises en charge et réévaluez les tâches périmées avant leur exécution. Une reprise aveugle peut reproduire des actions manuelles.
Microsoft a-t-elle confirmé la panne du 12 novembre 2026 ?
Oui. Sa page publique de statut indique un incident Microsoft 365 du 12 novembre 2026 à 10 h 05 UTC au 13 novembre 2026 à 16 h 10 UTC, avec un statut final « Service restored ». Elle ne donne ni cause ni rapport post-incident.
Sources
Les pages Microsoft ci-dessous fondent les indications sur le statut, les changements et les erreurs ; les procédures métier relèvent de la méthode proposée.
Lecture effectuée le 13 novembre 2026, statut final de l’incident relu le 14 novembre 2026. Aucun tableau de bord privé ni bulletin propre à une organisation n’a été consulté.
Les exemples de file, de journal et de rapprochement constituent des choix de conception à adapter au système concerné.
Analyse et méthode proposées par Anand Candassamy au 13 novembre 2026.