Le RAG (Retrieval-Augmented Generation, ou génération augmentée par récupération) consiste à rechercher des passages pertinents dans un corpus de documents, puis à les fournir à un modèle de langage pour qu’il réponde à partir d’eux, et non de sa seule mémoire. Le modèle ne devient pas plus savant : il reçoit, à chaque question, les extraits qui lui permettent de répondre et de citer sa source.
C’est aujourd’hui l’architecture la plus répandue pour brancher une IA générative sur les documents d’une entreprise : procédures, contrats, documentation technique, base de connaissances. Ce guide en donne la définition, l’origine, le fonctionnement étape par étape, l’arbitrage avec le fine-tuning et le contexte long, six cas d’usage, les causes d’échec et la façon de l’évaluer.
Qu’est-ce que le RAG en intelligence artificielle ?
En intelligence artificielle, le RAG est une architecture qui combine un moteur de recherche documentaire et un modèle génératif : le premier retrouve les passages utiles, le second rédige la réponse en s’appuyant sur eux.
Un modèle de langage seul répond avec ce qu’il a appris pendant son entraînement. Il ignore vos documents internes, ne connaît rien de postérieur à sa date de coupure et peut produire une réponse plausible mais fausse. Le RAG corrige ces trois défauts sans toucher au modèle : la connaissance reste dans le corpus, on la met à jour en mettant à jour les documents.
Deux mémoires coexistent donc. La mémoire paramétrique, stockée dans les poids du modèle, apporte la langue, le raisonnement et la culture générale. La mémoire non paramétrique, l’index documentaire, apporte les faits propres à l’entreprise. La qualité d’un RAG dépend surtout de la seconde, ce qui explique pourquoi le RAG reste l’architecture qui tient quand les modèles changent.
D’où vient le RAG et qui l’a inventé ?
Le terme RAG vient de l’article « Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks » de Patrick Lewis et ses coauteurs, déposé sur arXiv en mai 2020 et accepté à la conférence NeurIPS 2020.
L’article associe un modèle génératif pré-entraîné, la mémoire paramétrique, à un index vectoriel dense de Wikipédia, la mémoire non paramétrique, interrogé par un retriever neuronal. Les auteurs proposent deux variantes : RAG-Sequence, qui s’appuie sur les mêmes passages pour toute la réponse, et RAG-Token, qui peut puiser dans des passages différents à chaque mot généré. Deux bénéfices annoncés restent les arguments du RAG en entreprise : tracer la provenance d’une réponse et mettre à jour la connaissance sans réentraîner.
Ce travail prolonge celui de Karpukhin et ses coauteurs sur la recherche dense de passages (DPR), publié la même année à EMNLP 2020, qui montrait qu’un retriever fondé sur des vecteurs appris dépassait un moteur lexical BM25 de 9 à 19 points sur la précision des 20 premiers passages retrouvés, sur les jeux de questions-réponses étudiés. Le RAG d’entreprise actuel garde le principe mais n’entraîne plus le modèle avec le moteur : il lui transmet les passages dans sa consigne.
Comment fonctionne un RAG, étape par étape ?
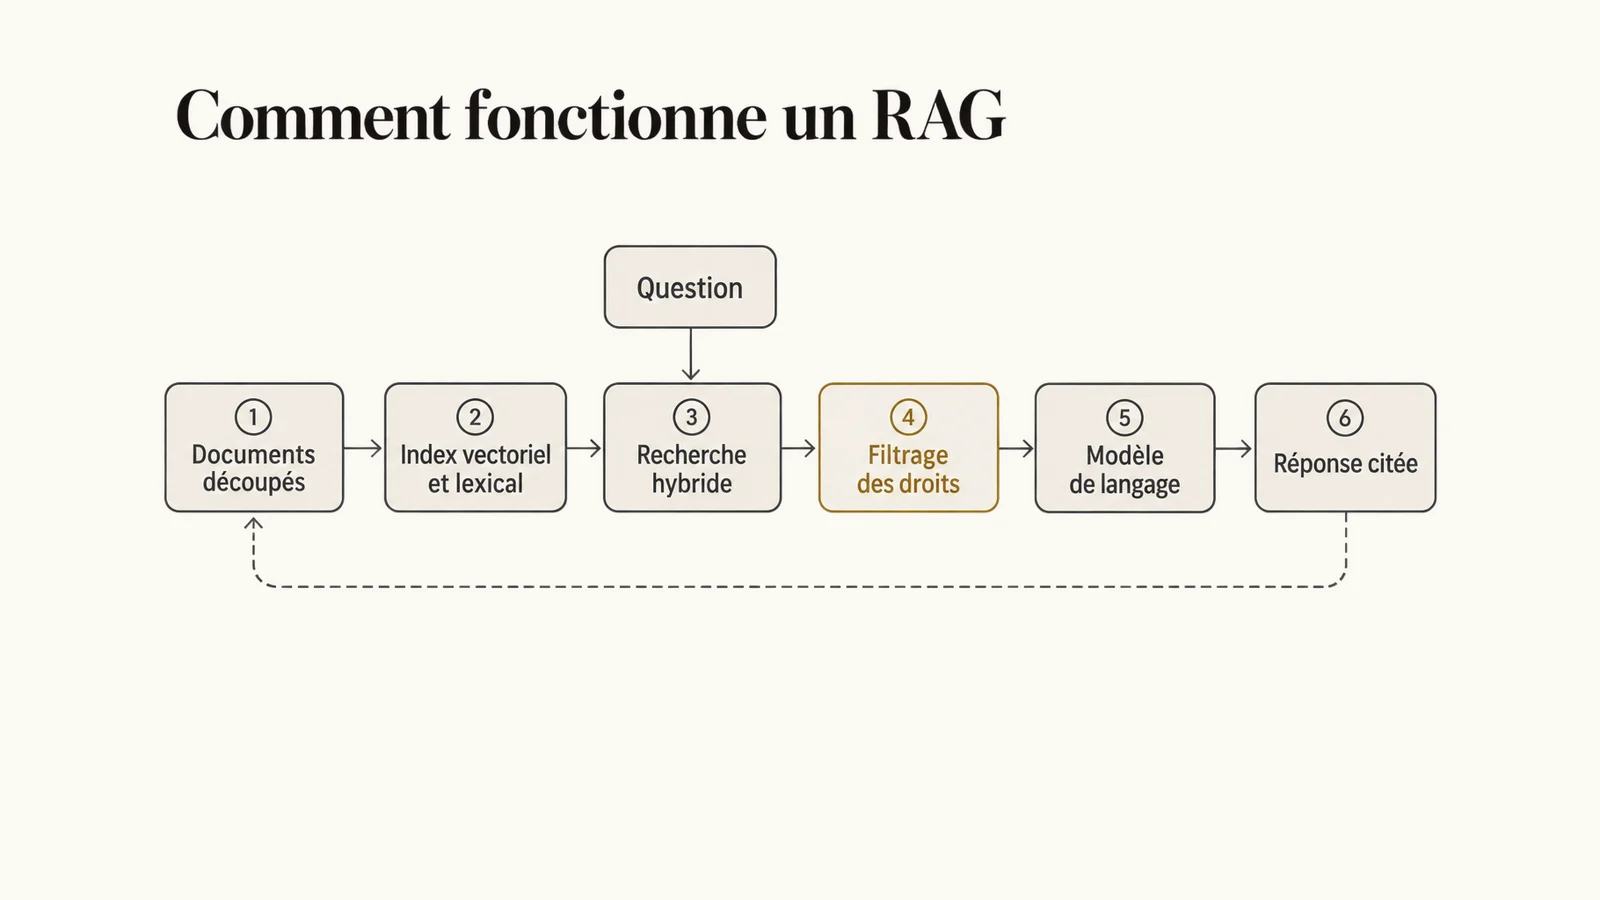
Un RAG fonctionne en deux temps : une préparation du corpus faite à l’avance, puis, à chaque question, une recherche, un filtrage et une génération sourcée. Sept étapes, dont aucune n’est facultative en production.
- Ingestion. Les documents sont collectés depuis leurs sources (GED, intranet, wiki, partages de fichiers), convertis en texte et accompagnés de leurs métadonnées : auteur, date, version, et surtout droits d’accès.
- Découpage. Chaque document est divisé en passages (chunks) assez courts pour être précis et assez longs pour rester compréhensibles seuls. C’est le choix qui décide de tout : un tableau coupé en deux ou une clause séparée de son exception produit des réponses fausses.
- Vectorisation et index. Chaque passage est transformé en vecteur par un modèle d’embeddings, qui place les textes de sens voisin à proximité les uns des autres ; les embeddings expliqués à une direction détaillent ce mécanisme. Les vecteurs sont stockés dans un index, avec un index lexical en parallèle.
- Recherche hybride. La question est vectorisée à son tour, puis on interroge les deux index : la recherche sémantique retrouve les reformulations, la recherche par mots-clés retrouve les références exactes, codes et noms propres. Les deux listes sont fusionnées et souvent reclassées ; voir la recherche hybride.
- Filtrage des droits. Seuls les passages que l’utilisateur a le droit de lire sont conservés, avant toute génération. Un filtrage fait après coup laisse déjà fuir l’information dans la réponse : il faut filtrer avant de répondre.
- Génération. Les meilleurs passages sont insérés dans la consigne du modèle, avec l’instruction de répondre uniquement à partir d’eux et de dire qu’il ne sait pas quand ils ne suffisent pas.
- Citation. La réponse renvoie aux passages utilisés, avec un lien vers le document source, pour que l’utilisateur vérifie en un clic.
Les étapes 1 à 3 suivent chaque modification du corpus ; les étapes 4 à 7 s’exécutent à chaque question.
Quelle différence entre RAG, fine-tuning et contexte long ?
Le RAG apporte au modèle des connaissances qui changent, le fine-tuning lui apprend un comportement stable, et le contexte long lui fait lire un volume borné de documents en entier. Trois outils pour trois besoins.
| Critère | RAG | Fine-tuning | Contexte long |
|---|---|---|---|
| Ce que l’on modifie | Les documents fournis à chaque question | Les poids du modèle | La quantité de texte envoyée |
| Mise à jour d’un fait | Immédiate, en réindexant le document | Nouvel entraînement | Immédiate, en renvoyant le document |
| Citation des sources | Native, passage par passage | Impossible de façon fiable | Possible, moins précise |
| Respect des droits d’accès | Par filtrage avant génération | Impossible une fois appris | À gérer document par document |
| Coût par question | Faible, seuls quelques passages sont envoyés | Faible après entraînement | Croît avec le volume envoyé |
| Choisir quand | Corpus large, vivant, à droits multiples | Format, ton, tâche répétitive spécialisée | Quelques documents à analyser en entier |
L’arbitrage se joue souvent sur le coût total : RAG ou fine-tuning, l’arbitrage par le coût en détaille le calcul. Quant au contexte long, une fenêtre plus grande ne garantit pas une lecture égale : l’étude « Lost in the Middle » (Liu et al., 2023) observe que les modèles exploitent mieux une information placée au début ou à la fin du contexte qu’au milieu. C’est pourquoi la fenêtre de contexte cesse d’être un argument dès que le corpus dépasse quelques documents.
Quels sont les cas d’usage du RAG en entreprise ?
Le RAG s’impose partout où des collaborateurs cherchent une réponse précise dans un volume de documents trop grand pour être lu, et où la réponse doit pouvoir être vérifiée à la source. Six cas d’usage reviennent le plus souvent.
- Assistant de procédures internes : RH, achats, qualité, sécurité. Le collaborateur pose sa question en langage courant et obtient l’article de procédure applicable, avec son lien.
- Support client et service après-vente : l’agent de support interroge fiches produit, notices et historique des incidents résolus, et rédige une réponse sourcée qu’il relit avant envoi.
- Documentation technique et maintenance : un technicien retrouve la procédure d’intervention d’un équipement par sa référence exacte, cas typique où la recherche par mots-clés complète la recherche sémantique.
- Analyse contractuelle et juridique : retrouver les clauses de résiliation, de responsabilité ou de révision de prix dans un portefeuille de contrats, en citant le contrat et l’article.
- Réponse aux appels d’offres : retrouver dans les réponses passées, les références et les fiches de compétences les éléments réutilisables pour un nouveau dossier.
- Conformité et veille réglementaire : interroger un corpus de textes, de politiques internes et d’avis, en exigeant la référence exacte de chaque affirmation.
Dans chacun de ces cas, la valeur vient surtout de la citation, principe d’où découlent les garde-fous d’un chatbot RAG.
Pourquoi un RAG donne-t-il de mauvaises réponses ?
Un RAG échoue presque toujours avant le modèle : un corpus obsolète, un découpage maladroit, des droits mal propagés ou l’absence d’évaluation expliquent l’essentiel des mauvaises réponses.
Le corpus d’abord. Trois versions d’une même procédure, des documents périmés, des PDF scannés sans texte : le moteur retrouve fidèlement des passages faux, et le modèle ignore quelle version fait foi si les métadonnées ne le disent pas.
Le découpage ensuite. Un passage trop court perd son contexte (« ce délai » sans dire lequel), un passage trop long dilue l’information utile. Les tableaux, listes et renvois entre articles sont les premières victimes.
Les droits ensuite. L’OWASP classe parmi les dix risques majeurs des applications à base de LLM les faiblesses des vecteurs et embeddings (LLM08:2025), dont la fuite d’informations entre utilisateurs qui partagent un même index ; il recommande des bases vectorielles qui tiennent compte des permissions et un cloisonnement strict des données.
L’évaluation enfin. Sans jeu de questions de référence, personne ne sait si une modification du découpage ou du modèle a amélioré ou dégradé le système. C’est la cause la plus fréquente du constat que l’assistant invente sur vos propres documents : une partie des réponses inventées vient de passages mal retrouvés, que personne ne mesurait.
Comment évaluer un RAG ?
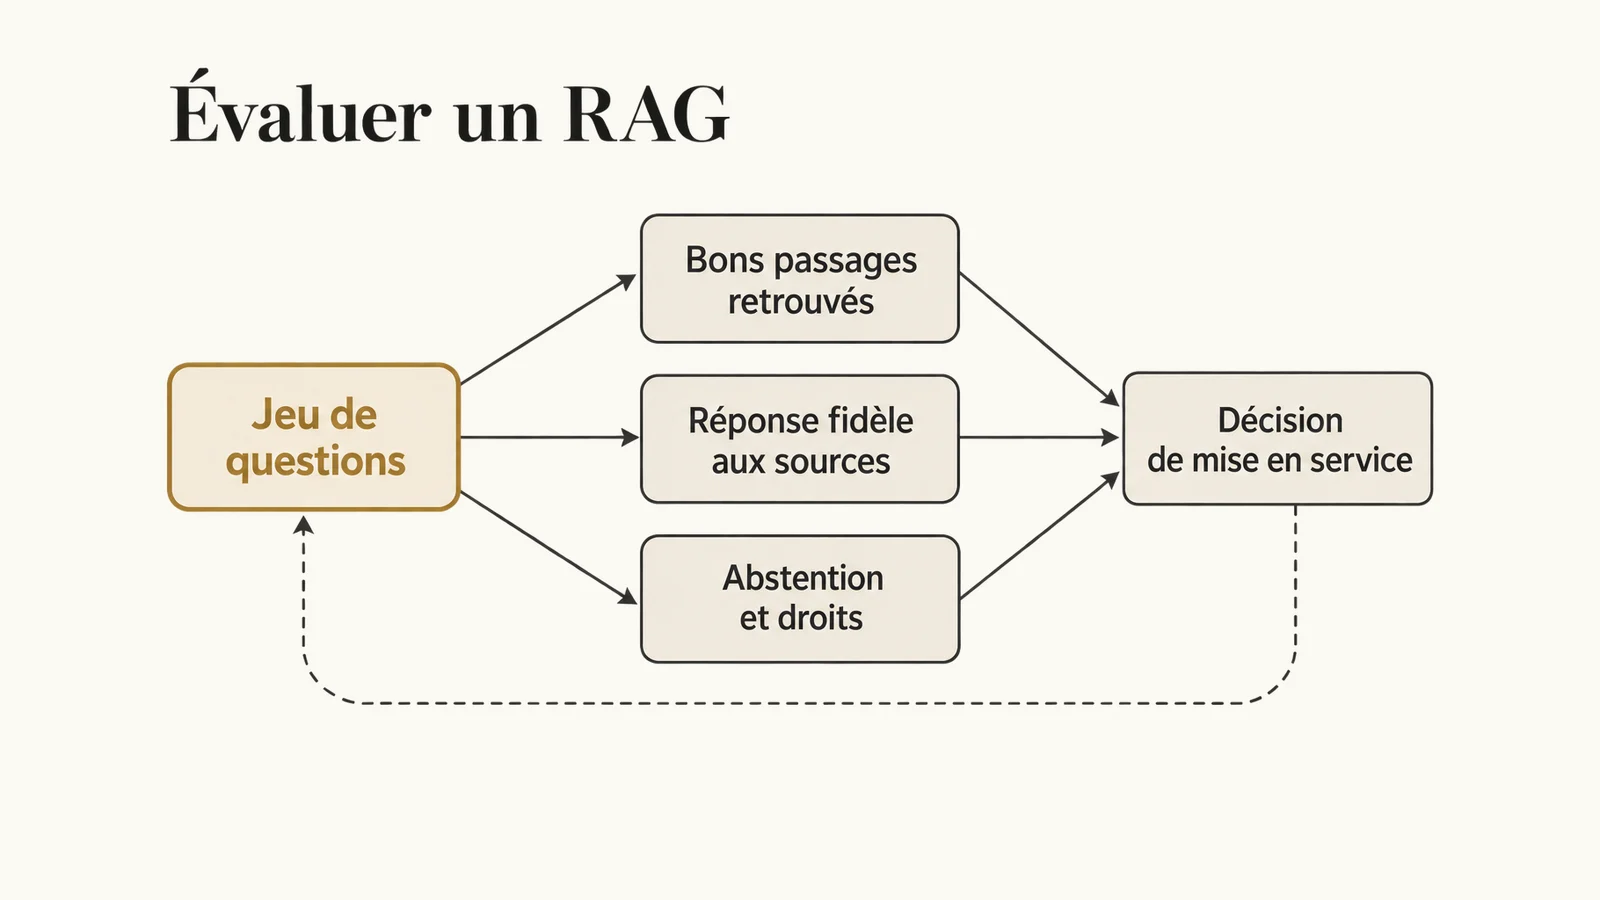
On évalue un RAG en mesurant séparément la recherche et la génération sur un jeu de questions de référence : la recherche a-t-elle retrouvé les bons passages, et la réponse s’appuie-t-elle fidèlement sur eux ?
Séparer les deux est indispensable : une réponse fausse peut venir d’un passage manquant, ou d’un bon passage mal exploité, et les corrections diffèrent. Le cadre Ragas (Es et al., 2023) propose trois mesures sans réponse de référence rédigée à la main : la fidélité (part des affirmations de la réponse que le contexte retrouvé permet d’établir), la pertinence de la réponse vis-à-vis de la question et la pertinence du contexte (part utile des passages retrouvés).
La méthode que je recommande tient en quatre gestes. Constituer un jeu de questions réelles, posées par les futurs utilisateurs, avec pour chacune le ou les documents qui contiennent la réponse ; un jeu de tests se construit en une journée. Mesurer le taux de questions dont le bon document figure parmi les passages retrouvés. Mesurer la fidélité des réponses, par relecture humaine sur un échantillon puis par un modèle évaluateur calibré sur cette relecture. Inclure des questions sans réponse dans le corpus et des questions hors droits, pour vérifier que le système sait s’abstenir et ne divulgue rien.
Ce jeu se rejoue ensuite à chaque changement de modèle, de découpage ou de corpus : c’est l’évaluation continue, le chaînon manquant de la plupart des projets.
Par où commencer un projet RAG en entreprise ?
Un projet RAG commence par un périmètre documentaire restreint, un groupe d’utilisateurs identifié et un jeu de questions de référence, avant tout choix d’outil ou de modèle.
Le bon premier périmètre est un corpus maîtrisé, dont un responsable sait dire quelle version fait foi, et des utilisateurs qui posent souvent les mêmes types de questions. On mesure, on corrige, puis on élargit.
Pour un système déjà en service, un audit IA d’entreprise de type « système existant » applique exactement cette grille : jeu de tests, mesure de la recherche et de la génération, vérification des droits et plan de correction. Les équipes qui veulent construire et maintenir leur RAG elles-mêmes peuvent passer par une formation IA centrée sur l’évaluation.
Questions fréquentes
Que veut dire RAG en IA ?
RAG signifie Retrieval-Augmented Generation, en français génération augmentée par récupération. Le système recherche des passages pertinents dans un corpus de documents, puis les fournit à un modèle de langage pour qu’il réponde à partir d’eux et cite ses sources.
Le RAG supprime-t-il les hallucinations ?
Non. Il les réduit lorsque les bons passages sont retrouvés et que le modèle a l’instruction de s’abstenir quand ils ne suffisent pas. Un passage mal retrouvé ou mal découpé produit encore des réponses fausses, d’où la nécessité de mesurer la recherche et la fidélité séparément.
Faut-il une base de données vectorielle pour faire un RAG ?
Non. Un RAG a besoin d’un mécanisme de récupération des documents utiles, qui peut être lexical, vectoriel ou hybride. Une base vectorielle dédiée est une possibilité, pas une obligation. Le choix dépend du corpus, des références exactes à retrouver et des résultats mesurés sur un jeu de questions.
Quelle différence entre RAG et fine-tuning ?
Le RAG fournit au modèle, à chaque question, les documents utiles sans le modifier ; le fine-tuning modifie ses poids pour lui apprendre un comportement. Le RAG convient aux connaissances qui changent et aux sources à citer, le fine-tuning à un format ou une tâche stable.
Un RAG respecte-t-il les droits d’accès aux documents ?
Seulement si on le conçoit ainsi : les droits doivent être portés par les métadonnées de chaque passage et appliqués avant la génération. L’OWASP recommande des bases vectorielles qui tiennent compte des permissions et un cloisonnement strict entre groupes d’utilisateurs.
Comment savoir si un RAG fonctionne bien ?
En le testant sur un jeu de questions réelles dont on connaît les documents sources : on mesure si les bons passages sont retrouvés, si la réponse leur est fidèle, et si le système s’abstient quand le corpus ne contient pas la réponse.
Sources
- Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, arXiv 2005.11401, NeurIPS 2020.
- Karpukhin et al., Dense Passage Retrieval for Open-Domain Question Answering, arXiv 2004.04906, EMNLP 2020.
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, arXiv 2307.03172.
- Es et al., Ragas: Automated Evaluation of Retrieval Augmented Generation, arXiv 2309.15217.
- OWASP Top 10 for LLM Applications 2025, LLM08:2025 Vector and Embedding Weaknesses.
- Microsoft Learn, récupération lexicale, vectorielle et hybride pour un RAG, mise à jour le 4 août 2026.
Analyse et méthode proposées par Anand Candassamy au 13 octobre 2026.