Une recette de migration de modèle est un ensemble de cas, de critères et de preuves permettant de décider si un nouveau modèle peut reprendre un usage existant. Elle porte sur le service rendu, les données utilisées et les actions autorisées.
Claude Fable 5.2 et Gemini 4 Carbon donnent des raisons de réexaminer certains usages. Leur disponibilité ne justifie pas une bascule générale. Les faits éditeurs sont regroupés ci-dessous ; la suite présente une méthode proposée par Anand Candassamy pour comparer les résultats, mesurer le travail humain et garder une possibilité de retour.
Claude Fable 5.2 et Gemini 4 Carbon sont-ils disponibles en entreprise ?
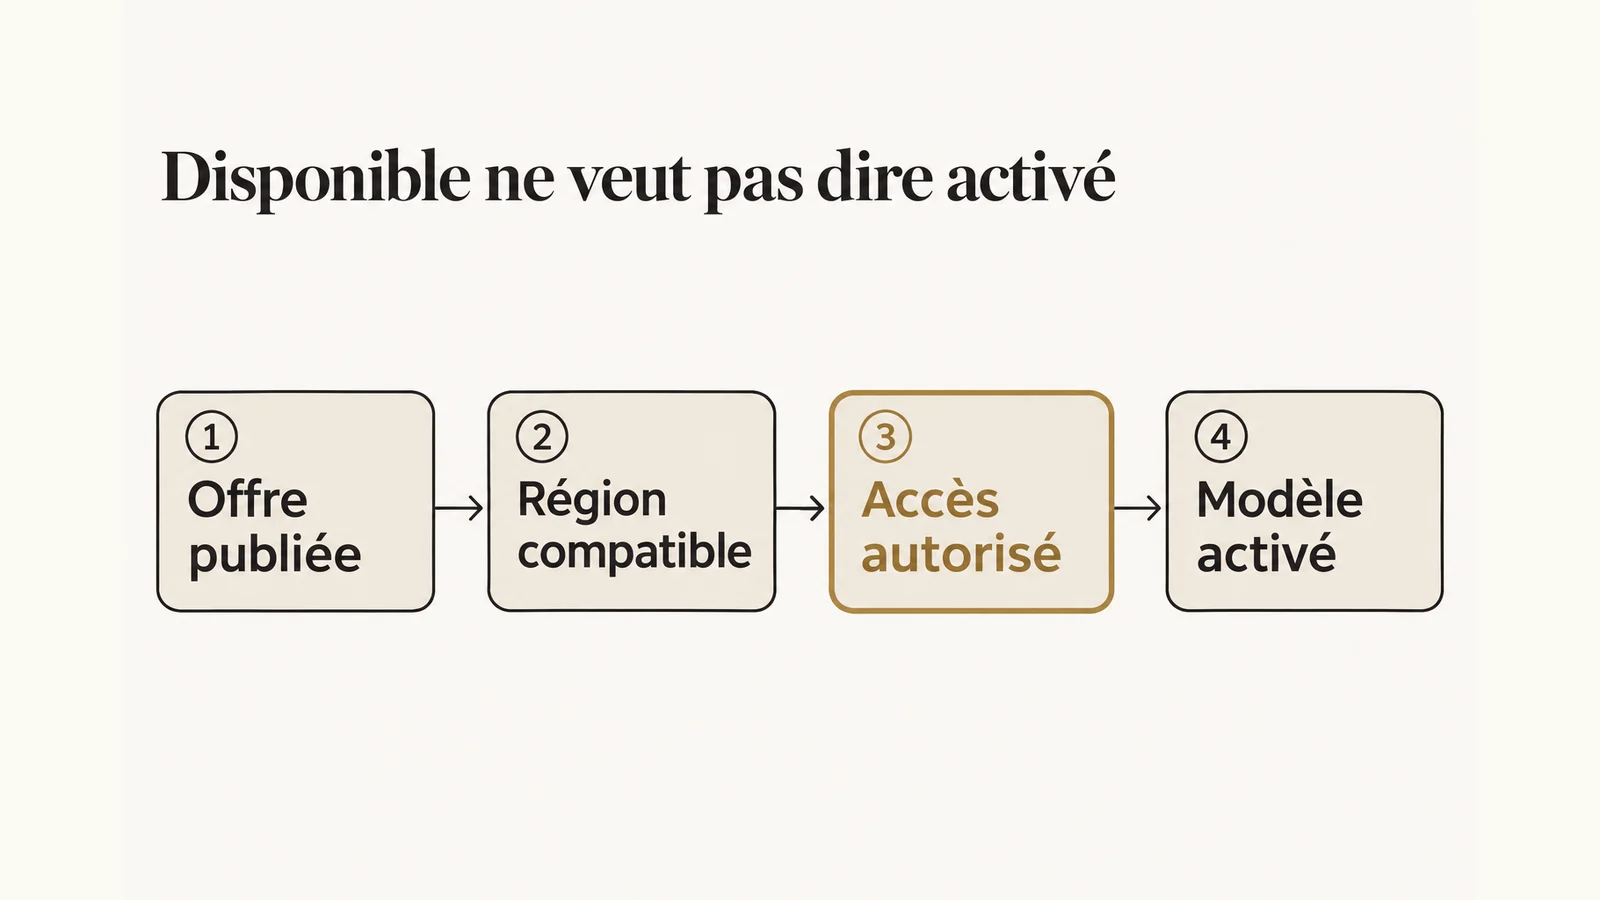
Vérifié le 13 novembre 2026 : les annonces confirment la disponibilité de Fable 5.2 et de Carbon, avec des conditions d’accès propres aux plateformes.
L’annonce Anthropic du 9 novembre indique Fable 5.2 sur ses plateformes, ainsi que chez AWS, Google Cloud et Microsoft Azure. Elle donne l’identifiant Claude Platform claude-fable-5-2. Mythos 5.2 relève de programmes de vérification pour les organisations concernées, notamment en cybersécurité et sciences du vivant.
Les notes Google du 10 novembre annoncent Carbon en disponibilité générale dans Gemini Enterprise : applications web et mobile, Workflow Builder et outils de développement IA. Les multirégions indiquées sont global, us et eu, avec résidence des données et traitement ML dans us et eu. Cela ne démontre pas la configuration de votre application.
| Point à vérifier | Claude Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| Périmètre annoncé | Plateformes Anthropic et clouds cités | Gemini Enterprise et surfaces indiquées |
| Accès effectif | Vérifier compte et plateforme | Vérifier application et réglages |
| Cas particulier | Mythos soumis à vérification | Activation variable selon la surface |
| Preuve proposée | Appel identifié et résultat conservé | Réglage consigné et essai utilisateur |
Pourquoi Gemini 4 Carbon peut-il être absent du sélecteur ?
Dans Gemini Enterprise, rendre un modèle disponible et permettre sa sélection sont des réglages distincts que l’administrateur doit vérifier dans le contexte de l’application.
Les notes Google indiquent Carbon désactivé par défaut dans les applications web et mobile. Pour les outils de développement, elles précisent une activation par défaut pour les utilisateurs licenciés lorsque la sélection de modèles Antigravity reste celle par défaut ; une liste personnalisée exige une sélection administrative. Ce réglage ne se généralise pas à toutes les interfaces.
La documentation de gestion des fonctions, liée depuis ces notes, décrit le sélecteur et les commandes de disponibilité. Elle avertit aussi qu’un modèle non pris en charge dans une région nationale peut être routé vers global après confirmation, sous réserve des politiques applicables.
La méthode proposée consiste à consigner l’application, la région et le compte de test avant toute activation. Faites vérifier la destination attendue par le responsable des données. Un modèle qui apparaît dans un menu répond à une question d’accès ; il reste à établir quels dossiers il pourra consulter et quelles actions il pourra déclencher.
Quel usage choisir pour comparer ces modèles sans disperser les tests ?
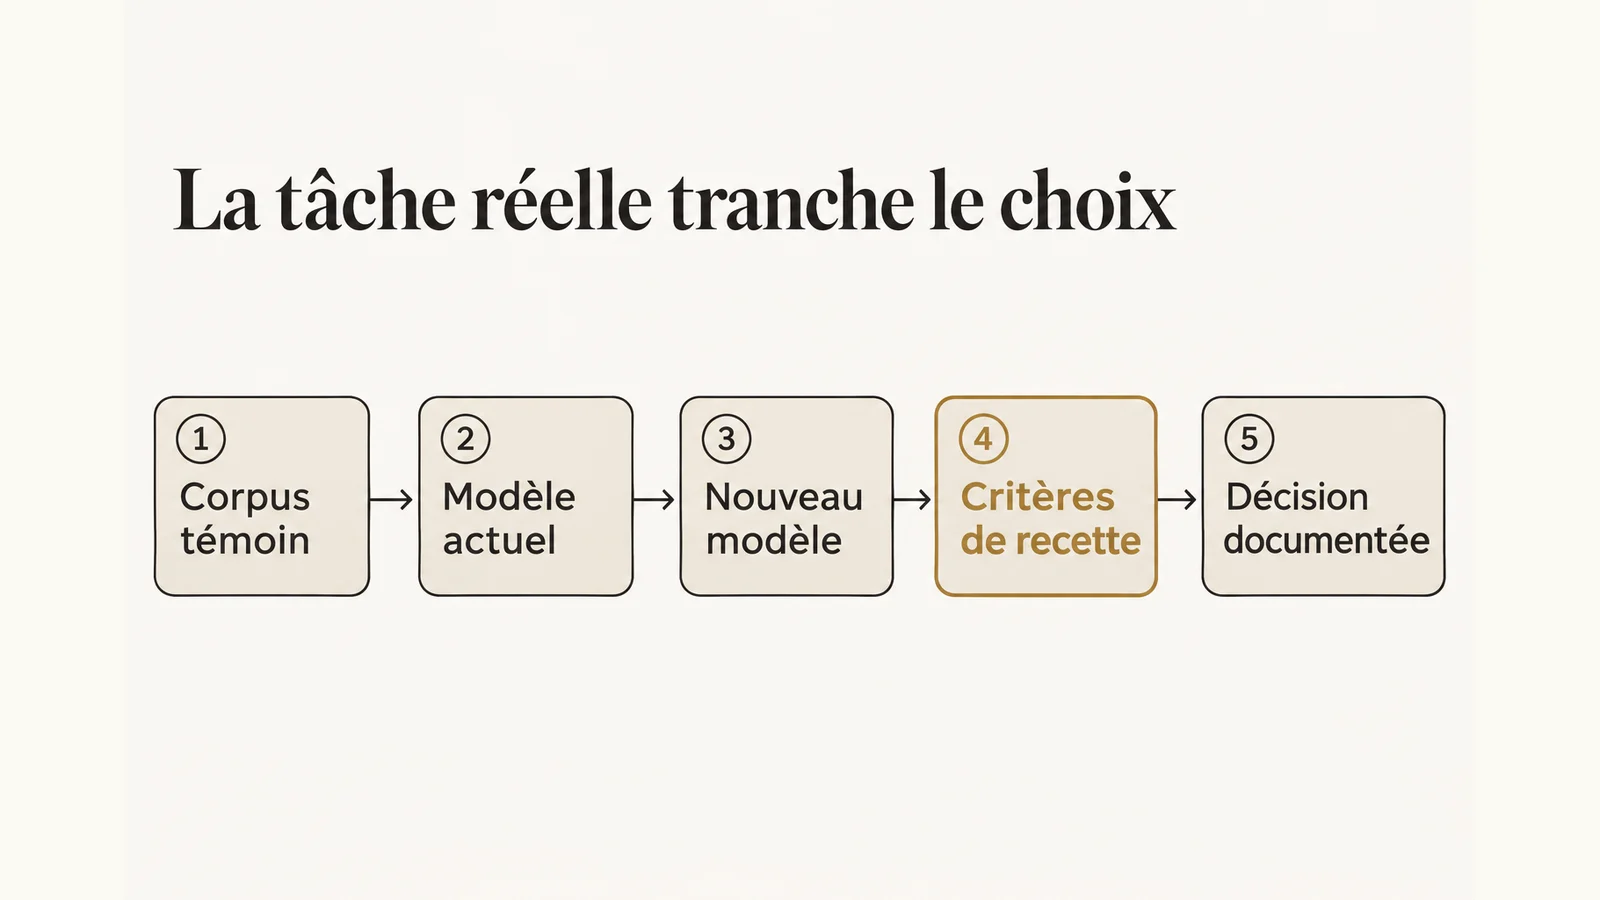
Choisissez une tâche existante dont le résultat peut être vérifié par un responsable métier, avec des données autorisées et une procédure de référence conservée.
Un scénario proposé serait la préparation d’une synthèse de dossier. Définissez les pièces disponibles, les informations obligatoires et les éléments qui doivent rester inconnus. Le résultat attendu peut exiger une réponse structurée, des références retrouvables et une demande de clarification lorsque les documents se contredisent. Vous disposez ainsi d’un objet précis à comparer.
Séparez les usages de consultation et ceux qui exécutent une action. Produire un brouillon pour un humain et modifier une fiche dans un outil métier ne demandent pas la même décision de mise en service. Commencez par le périmètre qui permet d’observer le résultat sans entraîner de conséquence difficile à reprendre.
Le dossier sur Gemini 4 Argon et les tests d’adoption permet de prolonger ce cadrage. Si une tâche n’a ni propriétaire, ni critère de réussite, sa migration risque surtout de déplacer l’incertitude. Écrivez d’abord ce qui rendrait le service acceptable pour la personne qui devra utiliser sa réponse.
Comment construire une comparaison équitable avec le modèle en place ?
La comparaison proposée conserve les mêmes dossiers, les mêmes droits et les mêmes critères métier, tout en documentant les adaptations nécessaires à chaque intégration.
Préparez un jeu figé comprenant des cas ordinaires, des documents incomplets, des contradictions et des demandes hors périmètre. Pour chacun, notez les faits attendus, les erreurs bloquantes et les réponses acceptables. Un cas incomplet doit notamment vérifier que le modèle n’invente pas une pièce manquante pour satisfaire la consigne.
Ne modifiez pas simultanément le modèle, la recherche documentaire et les permissions sans pouvoir distinguer leurs effets. Si un changement d’intégration est indispensable, décrivez-le. Faites relire les sorties selon la même grille, en masquant leur provenance lorsque cela est réalisable. Examinez aussi les écarts entre plusieurs exécutions d’un même dossier. Conservez la consigne exacte et les documents transmis pour chaque essai. Lorsque la recherche retourne une autre pièce, signalez cet écart avant d’attribuer la différence au seul modèle.
Le guide construire un jeu de tests en une journée aide à préparer cette matière. Les tests de migration GPT-6.1 Sol prolongent la logique : comparer un service complet, puis expliquer les différences observées. Les résultats restent propres à votre protocole et ne deviennent pas un classement général des modèles.
Quels critères permettent de décider qu’une réponse est utilisable ?
Une réponse utilisable respecte les sources, le format attendu et les limites du dossier, tout en demandant un effort de vérification compatible avec le métier.
Dans la grille proposée, distinguez une erreur de présentation d’une erreur susceptible de changer une décision. Une référence absente, une somme calculée sur le mauvais périmètre ou une affirmation tirée d’un document obsolète doivent rester visibles séparément. Une note moyenne peut masquer un défaut bloquant ; gardez la liste des échecs et leur conséquence.
Mesurez aussi le travail de l’utilisateur : temps pour retrouver les pièces, corriger les passages et accepter le livrable. Une rédaction plus élégante peut exiger davantage de vérifications. À l’inverse, une réponse plus courte mais traçable peut mieux servir le processus. Ces appréciations doivent venir de la personne chargée de la validation. Pour rendre ce jugement exploitable, demandez au relecteur de distinguer les corrections de forme des corrections de fond et de citer la pièce qui justifie chaque désaccord. Vous pourrez alors expliquer une préférence au lieu de la résumer par « cette réponse semble meilleure ».
Le dossier de preuve d’une réponse IA aide à relier les conclusions aux documents. Pour un assistant outillé, contrôlez en plus l’action réellement réalisée. La phrase « dossier mis à jour » n’est acceptable que si la modification autorisée peut être retrouvée et attribuée dans le système concerné.
Comment évaluer le coût sans extrapoler les prix de Google ?
La méthode proposée mesure le coût d’un résultat accepté, en séparant consommation technique, reprises et vérification humaine, sans déduire un tarif Google de cette annonce.
Anthropic annonce 8 dollars par million de jetons en entrée et 40 en sortie pour Fable 5.2 et Mythos 5.2 ; son mode rapide optionnel est affiché à 16 et 80 dollars. Ces montants publiés ne constituent pas votre facture contractuelle. Relevez l’offre et la plateforme effectivement utilisées avant tout calcul.
Pour Google, les notes de disponibilité consultées ne suffisent pas à établir le prix de votre configuration. Demandez les conditions applicables au compte et gardez cette ligne « à confirmer » tant qu’elles manquent. Une simulation doit nommer ses hypothèses et ne pas présenter une consommation supposée comme une mesure réelle.
Dans les essais, recueillez les consommations disponibles, les appels aux outils, les reprises et le temps de validation. Comparez ensuite des tâches acceptées de même nature. Le guide mesurer le coût par fonctionnalité permet d’organiser ces observations. Un tarif unitaire devient utile lorsqu’il est relié au travail réellement terminé.
Comment déployer progressivement et prévoir un retour au modèle précédent ?
Une migration maîtrisée définit les usages autorisés, les conditions d’arrêt et la configuration de retour avant de modifier le comportement du service utilisé en production.
La procédure proposée ci-dessous sert à rendre la décision réversible. Elle doit intégrer les contraintes réelles de votre application : format de sortie, historique conversationnel, disponibilité de la version précédente et conséquences des actions déjà effectuées. Un retour de configuration ne défait pas une opération métier accomplie.
- Nommer le responsable de la décision et figer le périmètre du pilote.
- Conserver les paramètres, consignes et versions des connecteurs de référence.
- Exécuter les cas comparés et documenter les erreurs bloquantes.
- Autoriser uniquement les tâches acceptées, avec validation humaine si nécessaire.
- Surveiller les écarts, les reprises et les retours des utilisateurs.
- Tester le retrait du nouveau modèle et vérifier la reprise du service attendu.
L’architecture décrite dans rendre le modèle remplaçable éclaire cette séparation. Vérifiez notamment qu’un connecteur ne dépend pas silencieusement d’un format particulier. Une migration partielle peut être une décision complète : conserver certains usages sur leur configuration actuelle et n’adopter le nouveau modèle que là où la recette le justifie.
Quelles questions trancher avant une migration de modèle ?
Faut-il remplacer immédiatement le modèle actuel ?
Non. La méthode proposée demande un résultat meilleur ou plus adapté sur un usage défini, avec des critères connus. La disponibilité commerciale ne remplace pas cette décision métier.
Mythos 5.2 est-il accessible comme Fable 5.2 ?
Anthropic distingue leurs conditions d’accès. Pour Mythos, l’annonce renvoie à des programmes de vérification. Confirmez votre éligibilité avant de construire un usage qui dépend de cet accès.
Carbon est-il automatiquement activé pour tous ?
Les notes Google distinguent les applications et les outils de développement. Contrôlez la surface, la licence et les réglages administratifs de votre environnement avant de conclure à un accès effectif.
Peut-on comparer les réponses sur un seul exemple ?
Un exemple aide à explorer un usage. Pour décider, la méthode proposée demande aussi des dossiers incomplets, des refus attendus et des cas difficiles, évalués avec la même grille.
Quel tarif Google utiliser dans le budget ?
Utilisez les conditions confirmées pour votre offre et votre compte. Les notes de disponibilité seules ne permettent pas de chiffrer votre configuration ni d’en déduire une hausse tarifaire.
Que faire si le pilote reste ambigu ?
Conservez les résultats et nommez la question non résolue : qualité, accès, coût ou intégration. Proposez un essai ciblé avant d’élargir le périmètre ou de modifier les critères.
Quelles sources établissent la disponibilité et les réglages annoncés ?
Les sources Anthropic et Google ci-dessous établissent les faits de disponibilité et d’administration ; les critères de décision et scénarios d’essai constituent la méthode proposée.
Ces pages ont été ouvertes le 13 novembre 2026. La documentation d’administration Google est directement liée depuis les notes de version consultées.
Aucun résultat de benchmark n’est repris ici. Les tarifs contractuels, l’accès effectif et les paramètres de votre environnement restent à confirmer avant une migration.
Analyse et méthode proposées par Anand Candassamy au 13 novembre 2026.