GPT-6.2 désigne ici deux modèles OpenAI, Astra et Sol. Une recette de modèle est une comparaison reproductible de leurs résultats sur des tâches métier, avec des critères fixés avant les essais. Le bon choix dépend du travail accepté, du coût complet et des actions autorisées.
OpenAI présente Astra pour les travaux exigeants et Sol pour les usages courants. Cela donne une hypothèse de départ, pas un verdict sur votre application. Les faits documentaires ci-dessous sont distingués de la méthode proposée : aucun benchmark interne ni gain de productivité ne sont présentés comme mesurés.
GPT-6.2 est-il disponible dans ChatGPT ou seulement dans Codex ?
Vérifié le 18 novembre 2026 : GPT-6.2 Astra et Sol sont en déploiement dans ChatGPT Work et Codex, sans ajout au Chat classique.
Le centre d’aide OpenAI précise que l’accès dépend du forfait, des permissions de l’espace et de l’avancement du déploiement. Il ne faut donc pas annoncer une disponibilité générale dans toutes les conversations ChatGPT ni déduire une liste exhaustive de forfaits d’une annonce API.
Méthode proposée : demander au responsable du pilote de noter le produit utilisé, le compte de test, le modèle effectivement sélectionnable et les droits accordés. Une capture du sélecteur atteste un accès pour ce compte ; elle ne démontre ni disponibilité universelle ni conformité de l’usage prévu.
Cette séparation évite de comparer un assistant Work équipé de connecteurs avec un appel API isolé. Avant le choix technique, le cadre de migration de GPT-6.1 Sol aide à formuler la tâche et ses critères de réussite.
Quels sont le prix et le contexte de GPT-6.2 Astra et Sol ?
Les fiches API annoncent le même contexte maximal pour les deux modèles, mais des tarifs distincts qui ne suffisent pas à prévoir une facture applicative.
Les valeurs suivantes proviennent des fiches Astra et Sol. Tarifs texte Standard en dollars par million de jetons, hors options et outils.
| Paramètre API | Astra | Sol |
|---|---|---|
| Entrée non mise en cache | 8 $ | 2 $ |
| Sortie | 40 $ | 10 $ |
| Fenêtre de contexte | 1 050 000 jetons | 1 050 000 jetons |
| Entrée maximale | 922 000 jetons | 922 000 jetons |
| Sortie maximale | 128 000 jetons | 128 000 jetons |
Au-delà de 272 000 jetons d’entrée, chaque fiche annonce le doublement des tarifs d’entrée et de cache, et un coefficient de 1,5 sur la sortie pour toute la requête. Les tarifs de base ne décrivent donc pas un long traitement complet.
Méthode proposée : relever la consommation facturée, les reprises et le travail humain nécessaire jusqu’au livrable accepté. Comparer ce total par tâche utile. Un modèle moins cher par jeton peut devenir moins intéressant si le résultat exige davantage de corrections.
Quand faut-il choisir Astra plutôt que Sol ?
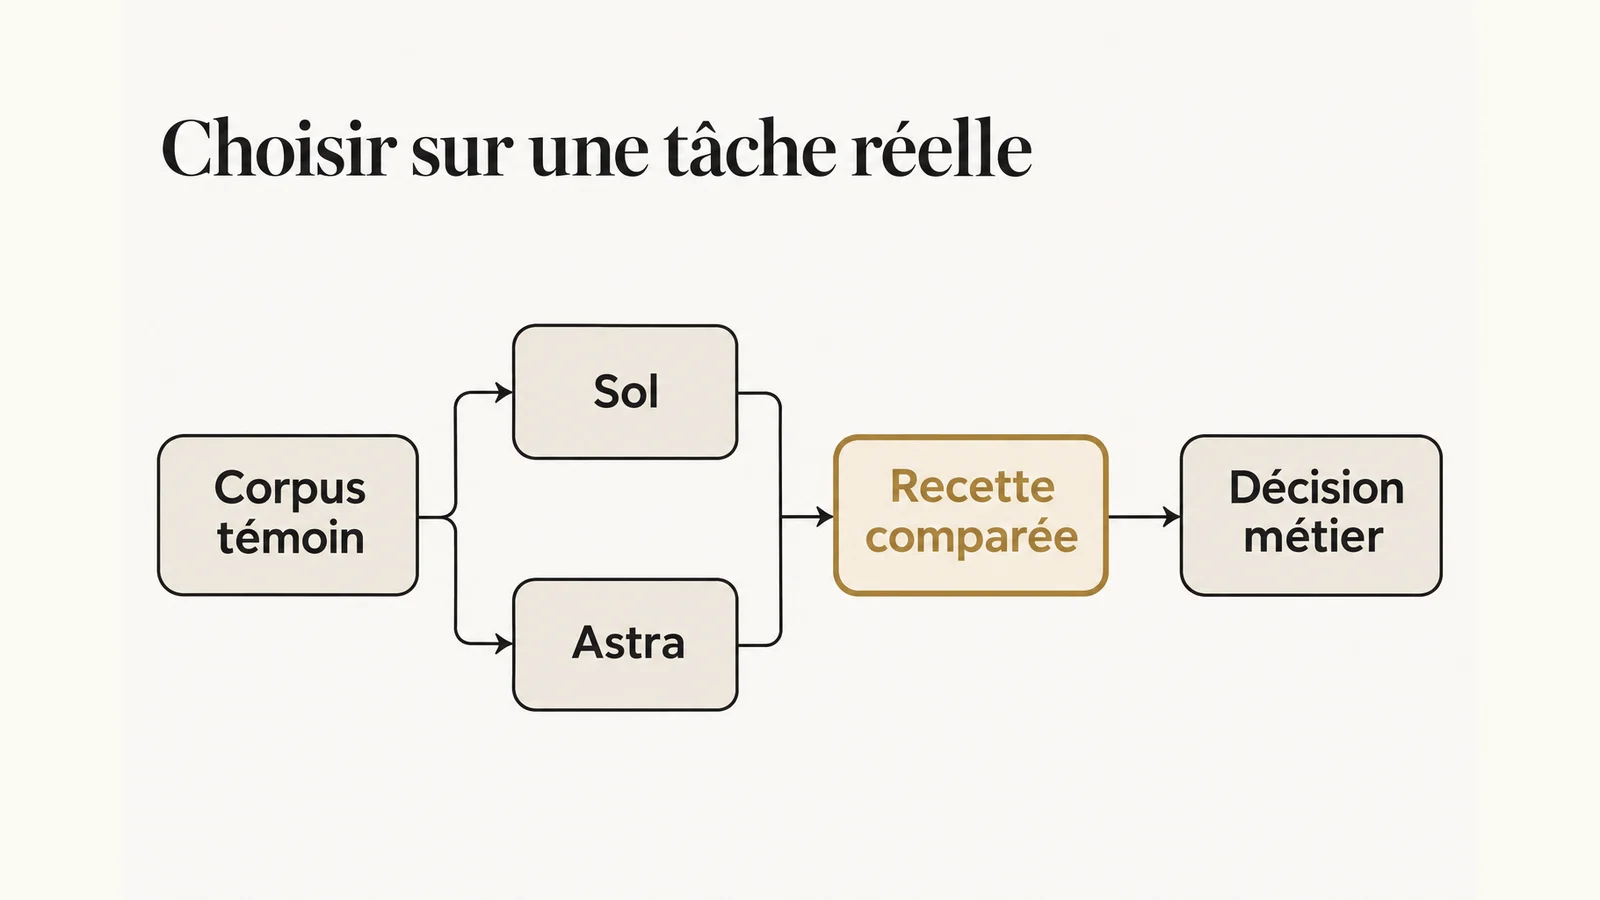
Astra doit être traité comme un candidat pour les tâches difficiles, tandis que Sol fournit un candidat de référence pour les travaux récurrents.
Cette orientation reprend le changelog du 17 novembre, sans garantir une supériorité sur votre corpus. La méthode suivante est une proposition d’Anand : partir de situations où une erreur coûte réellement du temps, bloque une décision ou crée un risque.
Pour une synthèse documentaire, comparer la fidélité aux pièces, les contradictions repérées et les informations manquantes signalées. Pour du code, vérifier le comportement demandé, les modifications inutiles et les tests effectivement exécutés. Pour un agent, examiner les actions réalisées et les demandes d’autorisation, pas seulement le commentaire final.
Organiser une lecture sans afficher le nom du modèle permet de réduire le poids de la réputation dans le jugement. Garder les cas où les deux échouent : ils peuvent révéler une consigne ambiguë, une source absente ou un outil inadapté. La comparaison des modèles de novembre prolonge cette logique de recette, sans servir de source aux faits OpenAI présentés ici.
Faut-il utiliser Responses API pour les outils de GPT-6.2 ?
Le changelog confirme Responses et Chat Completions pour les deux modèles, mais exige Responses API pour les appels d’outils avec GPT-6.2.
Il signale aussi des changements de conservation du raisonnement quand le préfixe conversationnel est modifié et de traitement du champ instructions. Les fiches modèles indiquent que le réglage de raisonnement none est refusé. Ces points justifient une revue de l’intégration avant de changer uniquement l’identifiant du modèle.
Méthode proposée : isoler les tests de conversation, les sorties structurées et les appels d’outils. Garder un exemple attendu pour chaque contrat : champs obligatoires, types acceptés, erreurs gérées et comportement si l’outil ne répond pas. Une réponse rédigée correctement ne valide pas une transaction métier.
Prévoir également le cas où le modèle propose une action dont les paramètres sont incomplets. L’application doit pouvoir interrompre le parcours, demander une précision et conserver la demande initiale. La recette des intégrations MCP fournit un prolongement pour travailler sur les permissions et la compatibilité des outils.
Que disent les seuils de sécurité de la system card GPT-6.2 ?
OpenAI classe les deux modèles au seuil Critical en cybersécurité et High en capacités biologiques et chimiques, selon son propre cadre Preparedness.
La system card datée du 17 novembre, également relue dans sa copie locale, place Astra au seuil High pour l’auto-amélioration de l’IA ; Sol reste en dessous. Elle rapporte aussi des régressions dans le signalement d’obstacles connus. Ces résultats appartiennent aux évaluations de l’éditeur, pas à un audit de votre système.
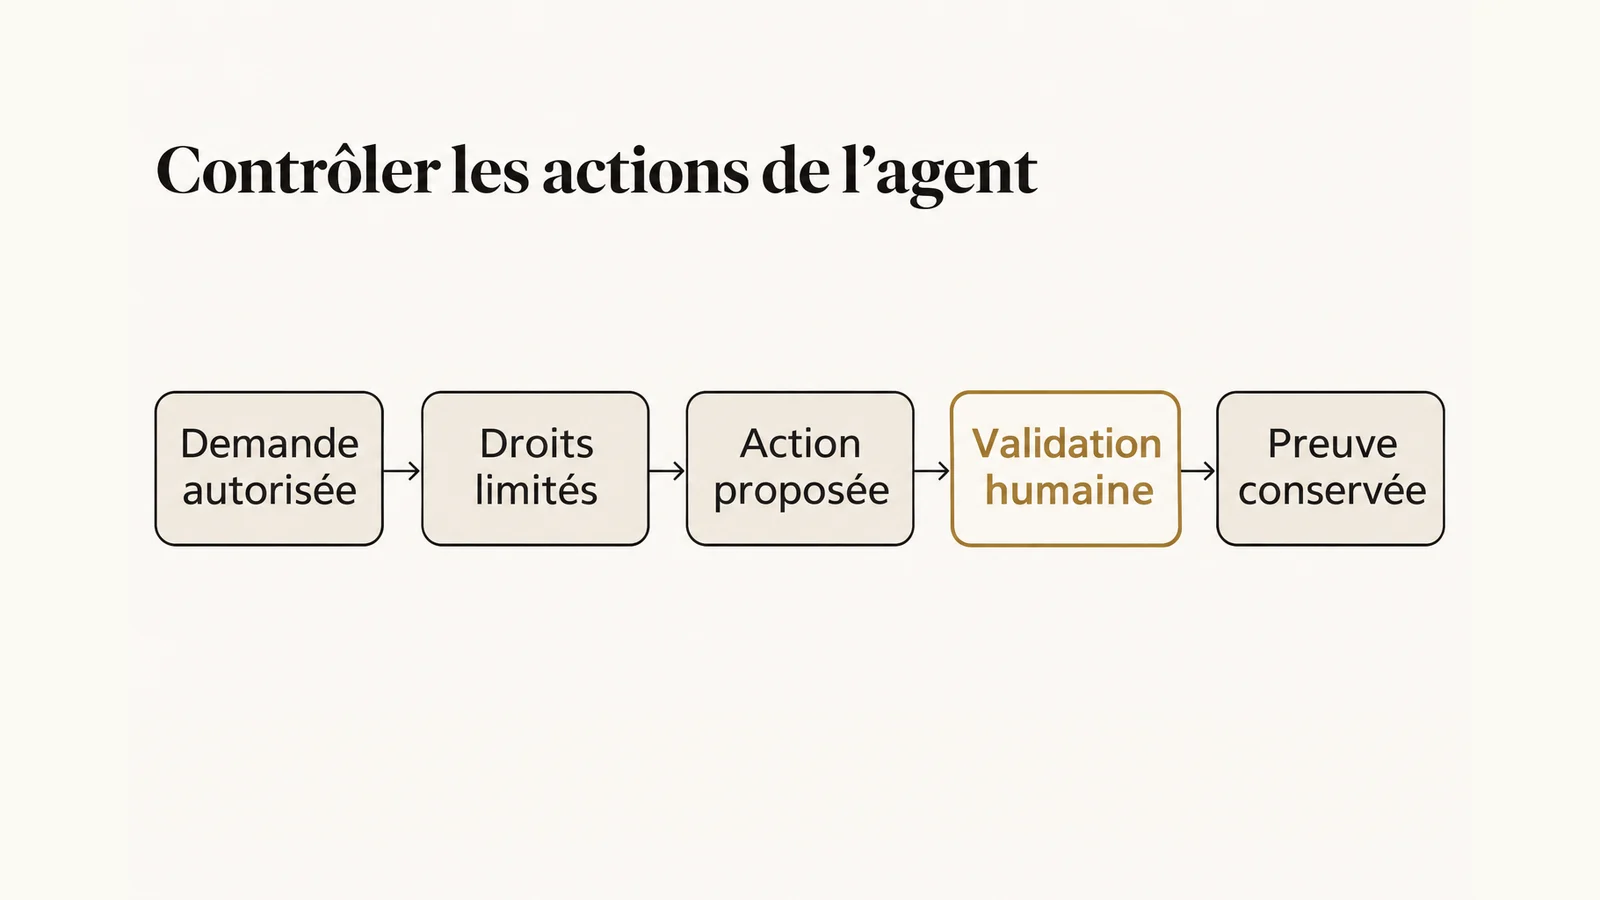
Méthode proposée : traduire cette lecture en contrôles observables. Un agent de développement doit déclarer les vérifications impossibles, distinguer un test prévu d’un test passé et montrer les changements réellement enregistrés. Le compte rendu doit permettre au relecteur de retrouver la preuve annoncée.
Limiter les droits et garder une validation avant une action sensible constitue un choix d’architecture proposé ici. Ce n’est ni une garantie tirée du seuil Preparedness ni une mesure de performance. Les scénarios d’injection indirecte permettent d’éprouver la séparation entre contenu consulté et instruction autorisée.
Comment organiser un test comparatif sans inventer de benchmark ?
Une comparaison utile fixe les critères avant les essais, conserve les échecs et distingue la qualité de la réponse de la validité des actions.
La procédure ci-dessous est une méthode originale proposée, pas un protocole officiel OpenAI. Elle vise une décision locale et explicable, sans extrapoler une performance générale depuis quelques démonstrations.
- Décrire la tâche et les erreurs qui la rendent inacceptable.
- Préparer des cas représentatifs avec leurs pièces autorisées et leurs réponses attendues.
- Comparer les candidats avec des outils et permissions équivalents.
- Examiner les résultats sans masquer les abandons, reprises et interventions humaines.
- Documenter les écarts et décider du périmètre réellement acceptable.
Inclure des dossiers incomplets, des instructions contradictoires dans une pièce et une indisponibilité d’outil. Ce sont des cas de recette proposés, pas des incidents attribués à GPT-6.2. Le responsable métier doit préciser quand l’agent doit demander une aide humaine. La qualité d’une abstention peut compter davantage que l’élégance d’une réponse assurée mais invérifiable.
Comment comparer les modèles quand les résultats varient ?
La comparaison doit conserver les variations observées et chercher leur conséquence métier, plutôt que retenir uniquement la démonstration la plus convaincante de chaque modèle.
Méthode proposée : rejouer les cas sensibles avec leurs entrées conservées et consigner les différences qui changent une décision. Une variation de style peut être acceptable ; une modification de destinataire, de montant ou de permission ne relève pas du même risque. Les critères doivent refléter cette différence.
Si un essai échoue, distinguer ce qui vient de la donnée, de l’outil et de la réponse produite. Conserver la trace initiale avant de corriger le scénario. Sinon, la comparaison risque d’évaluer des conditions différentes tout en affichant un résultat commun. La méthode de migration sans régression sert aussi à structurer ce suivi des écarts.
Faire enfin relire les cas litigieux par le responsable du processus. Le développeur peut constater une sortie valide techniquement alors que le métier refuse son interprétation. Cette divergence devient une décision à documenter, sans fabriquer un score global qui la masquerait. Un pilote utile indique aussi les usages encore exclus.
Comment décider du passage en production après le pilote ?
Le passage en production doit dépendre d’une décision documentée sur un périmètre précis, avec un responsable capable de suspendre les actions si nécessaire.
Méthode proposée : conserver un dossier de décision comprenant le modèle testé, les réglages, la version des consignes, les outils accessibles, les résultats relus et les limites acceptées. Le choix peut rester différent selon la tâche. Aucun routage automatique entre Astra et Sol n’est supposé validé par ce seul article.
Définir ensuite ce qui déclenche une nouvelle recette : modification des instructions, ajout d’un outil, changement de source documentaire ou évolution du modèle. Chaque événement doit renvoyer vers les scénarios susceptibles de changer, plutôt que vers une répétition aveugle de toutes les démonstrations.
Enfin, comparer la sortie attendue au travail effectivement livré. Un agent qui annonce une vérification sans preuve doit rester un cas à corriger. Un audit IA peut servir à structurer ce dossier : objectifs, tests, corrections et décision d’ouverture, avec des responsabilités explicites.
Questions fréquentes
GPT-6.2 est-il disponible dans le Chat classique ?
Le centre d’aide indique que ce déploiement concerne Work et Codex et ne l’ajoute pas au Chat classique. La visibilité dépend aussi du compte et des permissions.
Astra est-il toujours meilleur que Sol ?
Aucune conclusion universelle n’est établie ici. Comparer la réussite métier, les erreurs bloquantes et le coût complet sur les mêmes dossiers avant de choisir.
Le contexte maximal garantit-il une lecture exhaustive ?
La taille annoncée est une capacité technique. La méthode proposée consiste à vérifier les pièces utilisées et les omissions, sans assimiler volume accepté et exactitude du résultat.
Peut-on garder Chat Completions avec des outils ?
Pour GPT-6.2, le changelog exige Responses API pour les appels d’outils. Il faut revoir le parcours concerné, puis tester son contrat métier.
Le seuil Critical signifie-t-il une faille dans mon application ?
Non. Il décrit une catégorie de capacités dans le cadre de l’éditeur. La sécurité de votre application demande une évaluation de ses accès et actions.
Quel document garder après le test ?
Un dossier reliant les cas, critères, sorties, actions, corrections humaines et décision. Cette trace permet de réévaluer le choix quand l’intégration évolue.
Sources
Analyse et méthode proposées par Anand Candassamy au 18 novembre 2026.