Un modèle de substitution est une approximation d'un simulateur coûteux, entraînée sur ses sorties, qui répond en quelques millisecondes là où le calcul complet prend des minutes ou des heures. On le trouve aussi sous les noms de surrogate model, de métamodèle ou de modèle réduit. Il ne remplace pas la physique : il en apprend une image fidèle sur un domaine précis, et seulement là.
Cet article décrit la méthode : choisir une famille de modèles, construire le plan d'expériences, délimiter le domaine d'usage, quantifier l'incertitude et mesurer l'accélération honnêtement. Il se termine par la question trop rarement posée : quand faut-il garder le simulateur.
Qu'est-ce qu'un modèle de substitution, exactement ?
Un modèle de substitution est une fonction rapide qui associe aux paramètres d'entrée d'un simulateur une estimation de ses sorties, apprise à partir d'un nombre fini de simulations de référence. Le simulateur reste la vérité de terrain : le substitut en est une copie compressée.
Le simulateur de départ (éléments finis, mécanique des fluides, thermique) résout des équations aux dérivées partielles sur un maillage fin : précis, mais coûteux à chaque appel. Le substitut prend en entrée les mêmes paramètres (géométrie, conditions aux limites, propriétés des matériaux, consignes) et renvoie soit quelques grandeurs d'intérêt, soit un champ complet. Sa qualité se juge sur trois critères : l'erreur par rapport au simulateur, le domaine sur lequel cette erreur est garantie, et la capacité à signaler quand il ne sait pas.
Pourquoi le modèle de substitution rend-il un jumeau numérique utilisable en temps réel ?
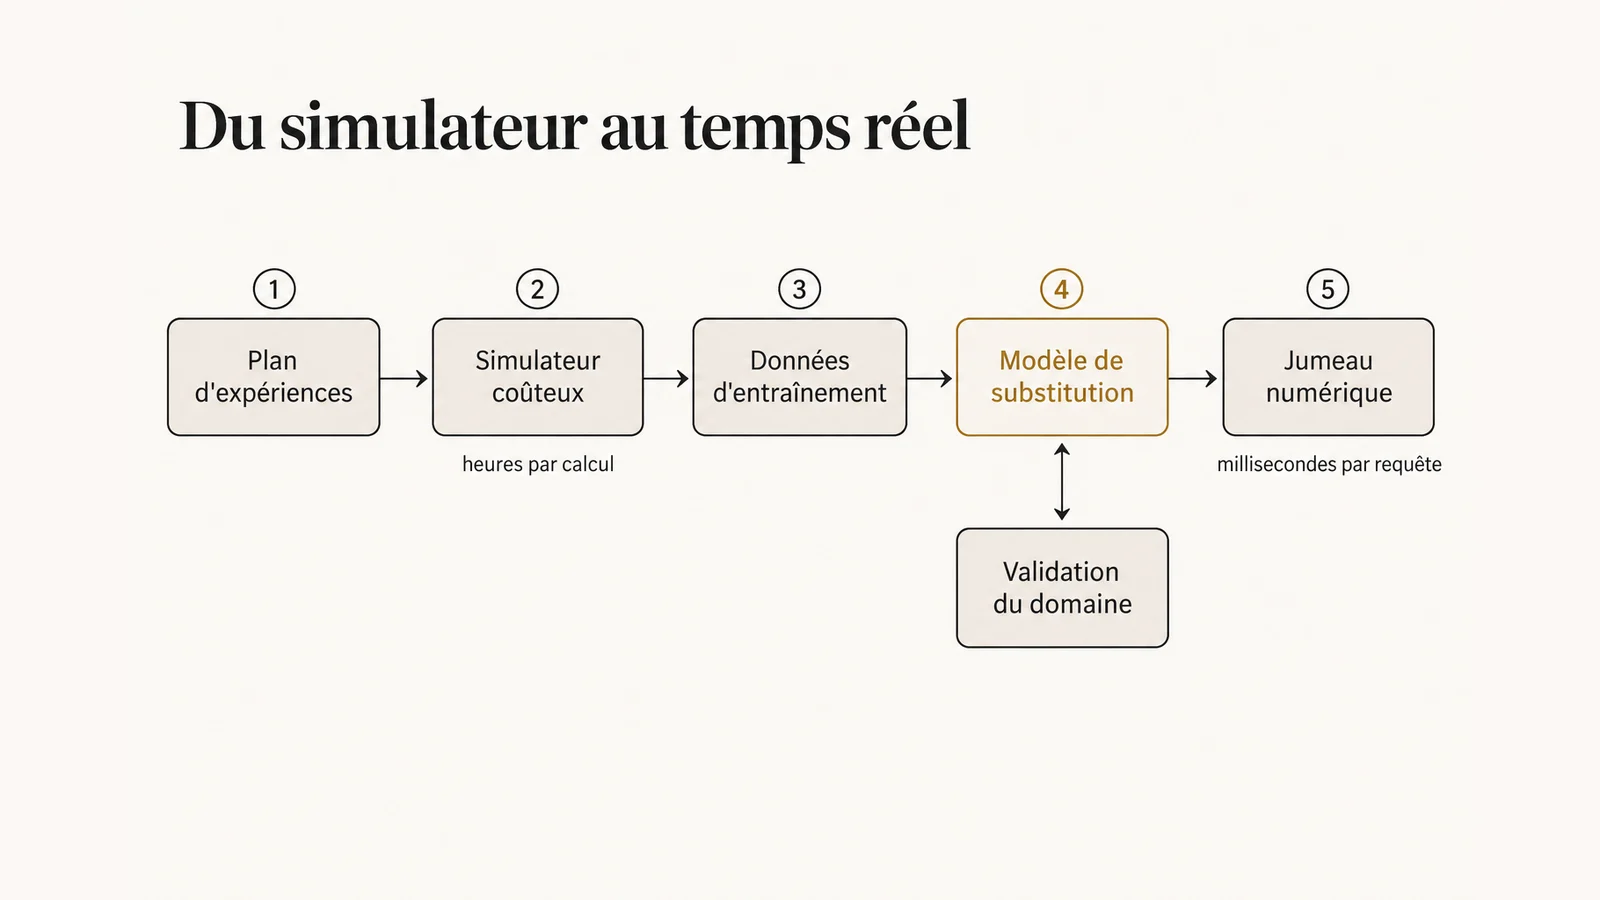
Un jumeau numérique doit répondre au rythme de l'installation qu'il représente, et seul un modèle de substitution tient cette contrainte de latence quand la physique sous-jacente est coûteuse à calculer. Sans lui, le jumeau reste un outil d'étude hors ligne.
Un jumeau numérique qui alimente une décision d'exploitation, un réglage de consigne ou une alerte doit produire une réponse en quelques millisecondes à quelques secondes. Le substitut reçoit l'état mesuré, renvoie l'état prédit, et laisse le simulateur complet aux études de fond. La page jumeau numérique : définition et exemples détaille cette architecture.
La contrainte de latence est le sujet qu'Anand Candassamy a étudié dans sa thèse de doctorat en intelligence artificielle, soutenue le 26 septembre 2025 à l'Université Grenoble Alpes, consacrée à l'apprentissage profond en temps réel. La leçon qui en ressort est simple : le budget de temps se fixe avant le choix du modèle, et chaque milliseconde se mesure sur le matériel cible, pas sur la station de développement. Le parcours qui relie cette thèse au déploiement est raconté dans soutenir une thèse et déployer en entreprise.
C'est aussi le substitut qui rend possible l'usage le plus courant du jumeau, la maintenance prédictive : comparer en continu ce que la physique prévoit à ce que les capteurs mesurent suppose de recalculer la prévision à chaque nouvelle mesure.
Quelles familles de méthodes choisir pour un modèle de substitution ?
Le choix de la famille dépend du nombre de simulations disponibles, de la dimension des entrées et de la forme des sorties : aucune méthode n'est la meilleure partout. Le tableau résume les cinq familles les plus utilisées.
| Famille | Principe | Atouts | Limites |
|---|---|---|---|
| Krigeage (processus gaussiens) | Interpolation statistique entre points simulés | Fonctionne avec peu de simulations, fournit une incertitude native | Coût cubique en nombre de points, peu adapté aux nombreuses entrées et aux champs complets |
| Réduction de modèle (POD) | Projection sur une base réduite extraite de clichés de simulation | Garde la structure physique, très rapide une fois la base construite | Base linéaire mal adaptée au transport, aux chocs et aux changements de régime |
| Réseaux de neurones classiques | Régression directe des sorties à partir des entrées | Souples, rapides en inférence, gèrent des entrées nombreuses | Gourmands en données, aucune garantie physique, pas d'incertitude native |
| PINN | Réseau dont la perte pénalise le résidu des équations | Intègre la physique, utile en problème inverse et avec peu de données | Entraînement délicat sur les problèmes raides ou multi-échelles, souvent un modèle par configuration |
| Opérateurs neuronaux (Fourier Neural Operator) | Apprentissage d'une application entre espaces de fonctions | Couvre une famille paramétrique d'équations, prédit des champs entiers | Demande beaucoup de solutions d'entraînement, conçu d'abord pour des grilles régulières |
Le krigeage reste la référence quand chaque simulation coûte cher et que les entrées sont peu nombreuses. Le cadre statistique a été posé pour les expériences numériques par Sacks, Welch, Mitchell et Wynn en 1989. La POD, popularisée en mécanique des fluides par Berkooz, Holmes et Lumley, convient aux champs qui se décomposent bien sur quelques modes dominants.
Les PINN, introduits par Raissi, Perdikaris et Karniadakis en 2019, ajoutent les équations à la fonction de perte : le réseau est puni quand sa sortie viole la physique. Les opérateurs neuronaux, dont le Fourier Neural Operator de Li et ses coauteurs, apprennent non pas une solution mais l'opérateur qui envoie un jeu de paramètres vers une solution. Je commence presque toujours par un krigeage ou une POD comme référence avant d'envisager un réseau : si le modèle simple suffit, le réseau n'apporte que de la maintenance.
Comment construire le plan d'expériences ?
Le plan d'expériences décide de la qualité du substitut avant même l'entraînement : il doit couvrir tout le domaine d'usage avec le moins de simulations possible. Un échantillonnage mal réparti laisse des zones vides où le modèle extrapole sans le dire.
L'hypercube latin, proposé par McKay, Beckman et Conover en 1979, découpe chaque variable d'entrée en intervalles de même probabilité et place exactement un point par intervalle et par variable. Chaque dimension est ainsi couverte uniformément, même avec peu de points, ce que ne garantit pas un tirage aléatoire simple.
En pratique, je recommande trois étapes. D'abord, fixer les bornes de chaque paramètre avec les experts métier, en incluant les conditions dégradées qui intéressent l'exploitation. Ensuite, générer un premier plan par hypercube latin optimisé pour maximiser la distance entre points. Enfin, enrichir de façon adaptative : ajouter des simulations là où l'incertitude du substitut est la plus forte ou là où la réponse varie brutalement.
Réservez dès le départ un jeu de simulations de test que le modèle ne verra jamais, tiré indépendamment du plan d'entraînement. Sans ce jeu, toute mesure d'erreur reste une mesure d'ajustement.
Comment valider le domaine d'usage et l'extrapolation ?
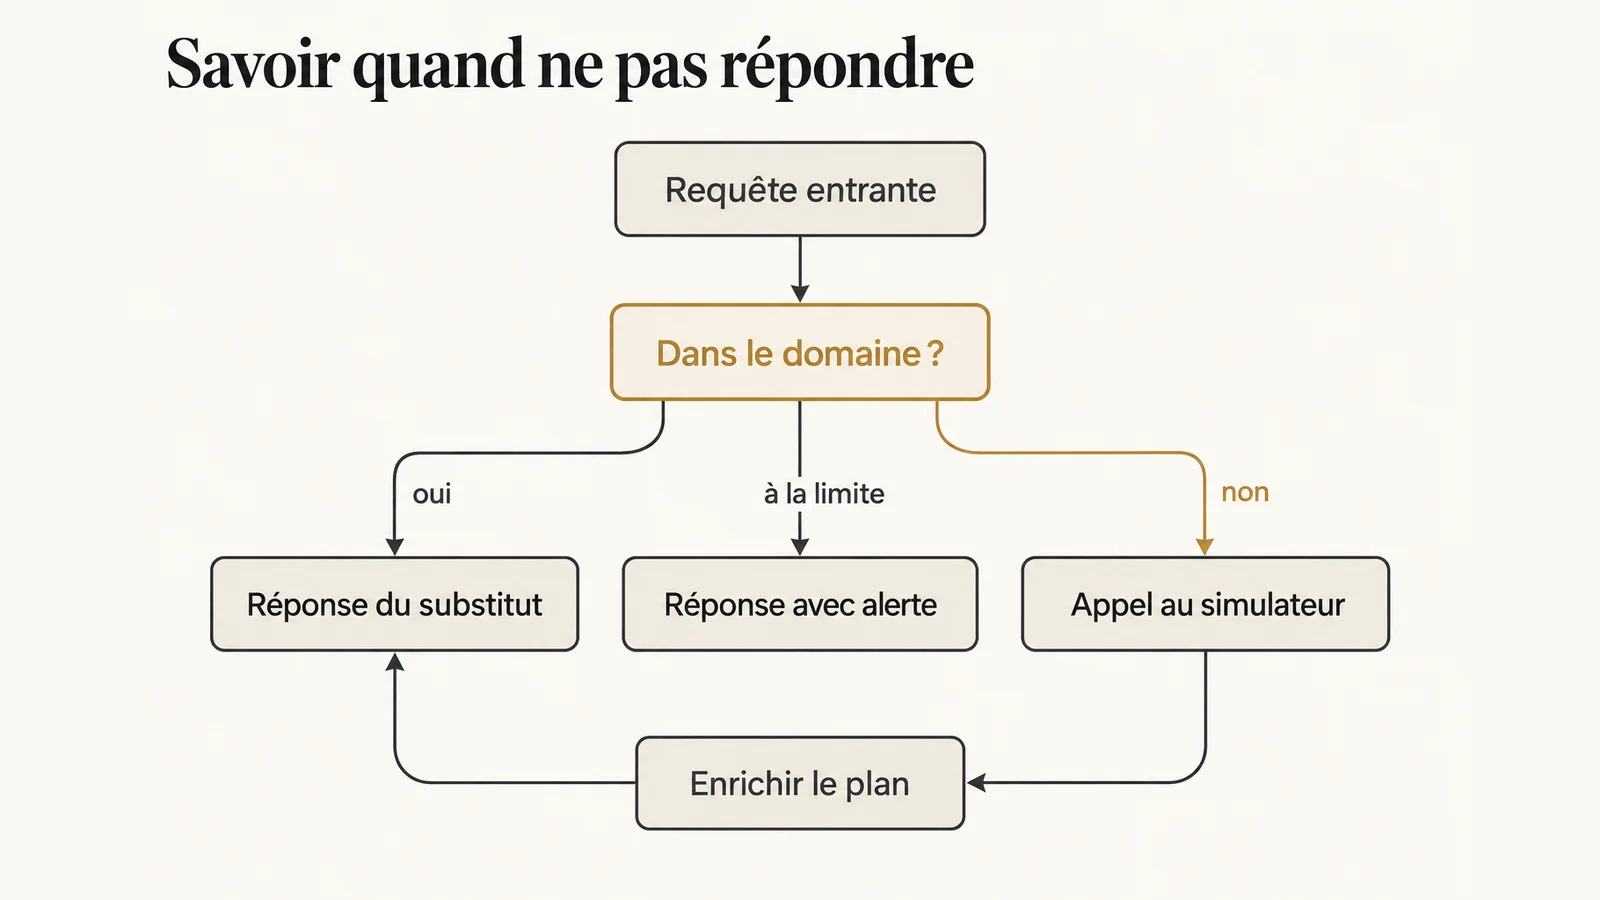
Un modèle de substitution n'est valide que dans l'enveloppe des simulations qui l'ont entraîné, et cette enveloppe doit être écrite, vérifiée à chaque requête et refusée au-delà. L'erreur moyenne sur le jeu de test ne dit rien de ce qui se passe hors de cette enveloppe.
La validation se fait sur trois niveaux. Le premier est statistique : erreur sur le jeu de test, distribution des erreurs et pire cas, pas seulement la moyenne. Le deuxième est physique : conservation de la masse ou de l'énergie, respect des bornes, symétries attendues. Le troisième est opérationnel : comparaison avec des mesures réelles de l'installation, ce qui relève de la calibration du jumeau numérique.
L'extrapolation est le risque principal. Un réseau de neurones renvoie toujours un nombre, même pour une entrée qu'il n'a jamais approchée. Le garde-fou consiste à tester chaque requête contre le domaine d'entraînement (bornes, distance au plus proche voisin, densité locale) et à basculer vers le simulateur ou vers une alerte quand la requête sort de l'enveloppe. La méthode complète est détaillée dans valider le domaine d'une simulation physique par IA.
Le domaine se surveille ensuite en production : l'installation vieillit, les consignes changent, et des entrées autrefois rares deviennent courantes. Une évaluation continue détecte cette dérive avant qu'elle ne se traduise en mauvaise décision.
Comment quantifier l'incertitude d'un modèle de substitution ?
Un substitut utile renvoie une prédiction accompagnée d'un intervalle, parce que la décision qui en découle dépend autant de la confiance que de la valeur. Une valeur seule, sans incertitude, ne permet pas de savoir quand le modèle se trompe.
Le krigeage fournit cette incertitude par construction : la variance prédite grandit loin des points simulés. Pour un réseau de neurones, il faut l'ajouter, par exemple avec un ensemble de modèles aux initialisations différentes dont la dispersion sert d'indicateur.
L'incertitude doit être calibrée : un intervalle annoncé à 90 % doit contenir la valeur du simulateur dans environ 90 % des cas du jeu de test. Un modèle trop confiant est plus dangereux qu'un modèle imprécis, parce qu'il supprime l'alerte.
L'écart entre substitut et simulateur se réduit en ajoutant des simulations. L'écart entre simulateur et réel, lui, relève de la calibration sur mesures.
Comment mesurer honnêtement l'accélération d'un modèle de substitution ?
L'accélération réelle d'un substitut se calcule en incluant le coût de génération des données d'entraînement, et elle n'existe qu'au-delà d'un nombre d'appels qu'il faut chiffrer avant de lancer le projet. Comparer seulement le temps d'une requête au temps d'une simulation surestime systématiquement le gain.
Le calcul complet additionne le temps de toutes les simulations du plan d'expériences, le temps d'entraînement et de réglage, puis le temps d'inférence multiplié par le nombre de requêtes. Il se compare au temps du simulateur multiplié par ce même nombre de requêtes. Le point d'équilibre est le nombre d'appels à partir duquel le substitut devient rentable.
À titre purement illustratif : si une simulation dure une heure et que le plan d'expériences en demande cinq cents, le substitut doit être appelé plus de cinq cents fois avant d'avoir seulement rendu le temps de calcul investi, sans compter l'entraînement. Pour un jumeau interrogé en continu, ce seuil est vite franchi. Pour une étude ponctuelle de vingt cas, il ne l'est jamais.
L'article du Fourier Neural Operator indique une méthode jusqu'à trois ordres de grandeur plus rapide que les solveurs traditionnels : ce chiffre porte sur l'inférence, à précision donnée sur les problèmes testés. Pour lire ce type de promesse, appliquez la grille de lire une promesse de multiplicateur : même matériel, même précision, comparaison avec un solveur à maillage plus grossier de même erreur, et coût des données inclus.
Quand ne faut-il pas faire de modèle de substitution ?
Il ne faut pas construire de modèle de substitution quand le simulateur est déjà assez rapide, quand le nombre d'appels prévu ne rembourse pas les données, ou quand les requêtes sortiront régulièrement du domaine d'entraînement. Dans ces trois cas, le substitut ajoute un risque sans apporter de gain.
Deux autres cas doivent faire renoncer : une décision de sûreté ou de certification qui exige le calcul réglementaire, et un système dont la physique change souvent (nouvelle géométrie, nouveau matériau), qui impose de régénérer les données à chaque évolution.
Avant de construire un substitut, je vérifie toujours les alternatives plus simples : un maillage plus grossier, un modèle physique simplifié, une table précalculée ou un calcul parallélisé. Si l'une d'elles tient la latence demandée, elle est préférable, parce qu'elle reste explicable et ne demande ni réentraînement ni surveillance de dérive.
Questions fréquentes
Quelle différence entre modèle de substitution et métamodèle ?
Les deux termes désignent la même chose : un modèle d'un modèle, qui approxime les sorties d'un simulateur. « Métamodèle » domine en statistique, « surrogate model » en ingénierie et en apprentissage automatique. Le terme « modèle réduit » vise plus spécifiquement les méthodes de projection comme la POD.
Un PINN a-t-il besoin de données de simulation ?
Pas nécessairement. Un réseau de neurones informé par la physique peut s'entraîner uniquement sur le résidu des équations et les conditions aux limites. Ajouter des mesures améliore souvent la convergence, et le PINN est particulièrement utile pour les problèmes inverses où l'on cherche des paramètres inconnus à partir d'observations.
Combien de simulations faut-il pour entraîner un modèle de substitution ?
Il n'existe pas de nombre universel : il dépend de la dimension des entrées, de la régularité de la réponse et de la famille de modèle. Un krigeage peut suffire avec quelques dizaines de points sur peu de paramètres, alors qu'un opérateur neuronal demande en général beaucoup plus de solutions. La bonne pratique consiste à partir d'un plan initial en hypercube latin et à l'enrichir tant que l'erreur sur le jeu de test baisse.
Un modèle de substitution peut-il extrapoler ?
Il ne le fait pas de façon fiable. Hors de l'enveloppe des simulations d'entraînement, l'erreur n'est plus contrôlée, et un réseau de neurones renvoie une valeur plausible sans signaler le problème. Il faut donc tester chaque requête contre le domaine d'entraînement et basculer vers le simulateur quand elle en sort.
Qu'apporte le Fourier Neural Operator par rapport à un réseau classique ?
Le Fourier Neural Operator apprend une application entre espaces de fonctions plutôt qu'une correspondance entre vecteurs fixes. Il peut ainsi traiter une famille entière d'équations paramétriques et prédire des champs complets. Ses auteurs montrent qu'il peut être évalué à une résolution différente de celle de l'entraînement, ce qu'un réseau classique sur grille fixe ne permet pas.
Le modèle de substitution remplace-t-il le simulateur ?
Non. Le simulateur reste la référence qui produit les données d'entraînement, valide le substitut et répond aux requêtes hors domaine. Le substitut ne fait que rendre cette physique accessible au rythme du temps réel, sur un domaine délimité.
Sources
- Raissi, Perdikaris, Karniadakis, « Physics-informed neural networks », Journal of Computational Physics, vol. 378, 2019, p. 686-707.
- Li et al., « Fourier Neural Operator for Parametric Partial Differential Equations », arXiv 2010.08895, ICLR 2021.
- McKay, Beckman, Conover, « Comparison of Three Methods for Selecting Values of Input Variables in the Analysis of Output from a Computer Code », Technometrics, vol. 21, n° 2, 1979, p. 239-245.
- Sacks, Welch, Mitchell, Wynn, « Design and Analysis of Computer Experiments », Statistical Science, vol. 4, n° 4, 1989.
- Berkooz, Holmes, Lumley, « The Proper Orthogonal Decomposition in the Analysis of Turbulent Flows », Annual Review of Fluid Mechanics, vol. 25, 1993, p. 539-575.
Analyse et méthode proposées par Anand Candassamy au 10 octobre 2026.