La maintenance prédictive consiste à estimer, à partir des données d'un équipement, le moment où il va défaillir, pour intervenir juste avant. Le jumeau numérique y ajoute un modèle de l'équipement, souvent physique, qui sert de référence : il dit comment la machine devrait se comporter dans les conditions du moment, et l'écart entre ce comportement attendu et la mesure devient le signal de dégradation.
Sur le papier, l'association est évidente. En production, la plupart des difficultés ne viennent pas de l'algorithme : elles viennent des pannes trop rares pour apprendre, d'un historique de maintenance mal renseigné, de capteurs qui dérivent et d'alertes que personne n'est chargé de traiter. Cet article décrit ce qui tient réellement une fois le pilote terminé, et la méthode que je recommande pour y arriver.
Que fait la maintenance prédictive, et qu'y ajoute le jumeau numérique ?
La maintenance prédictive estime quand un équipement va défaillir à partir de ses données ; le jumeau numérique y ajoute le modèle physique qui explique l'écart entre le comportement attendu et le comportement mesuré.
Un modèle prédictif seul apprend des corrélations : telle combinaison de vibrations et de températures a précédé des pannes. Il peut être performant, mais il reste muet sur la cause et fragile dès que les conditions d'exploitation sortent de ce qu'il a vu. Le jumeau numérique, au sens de la norme ISO 23247 pour la fabrication, est une représentation numérique d'un élément observable, synchronisée avec lui. Il fournit le comportement nominal attendu pour une charge, une vitesse, une température ambiante données.
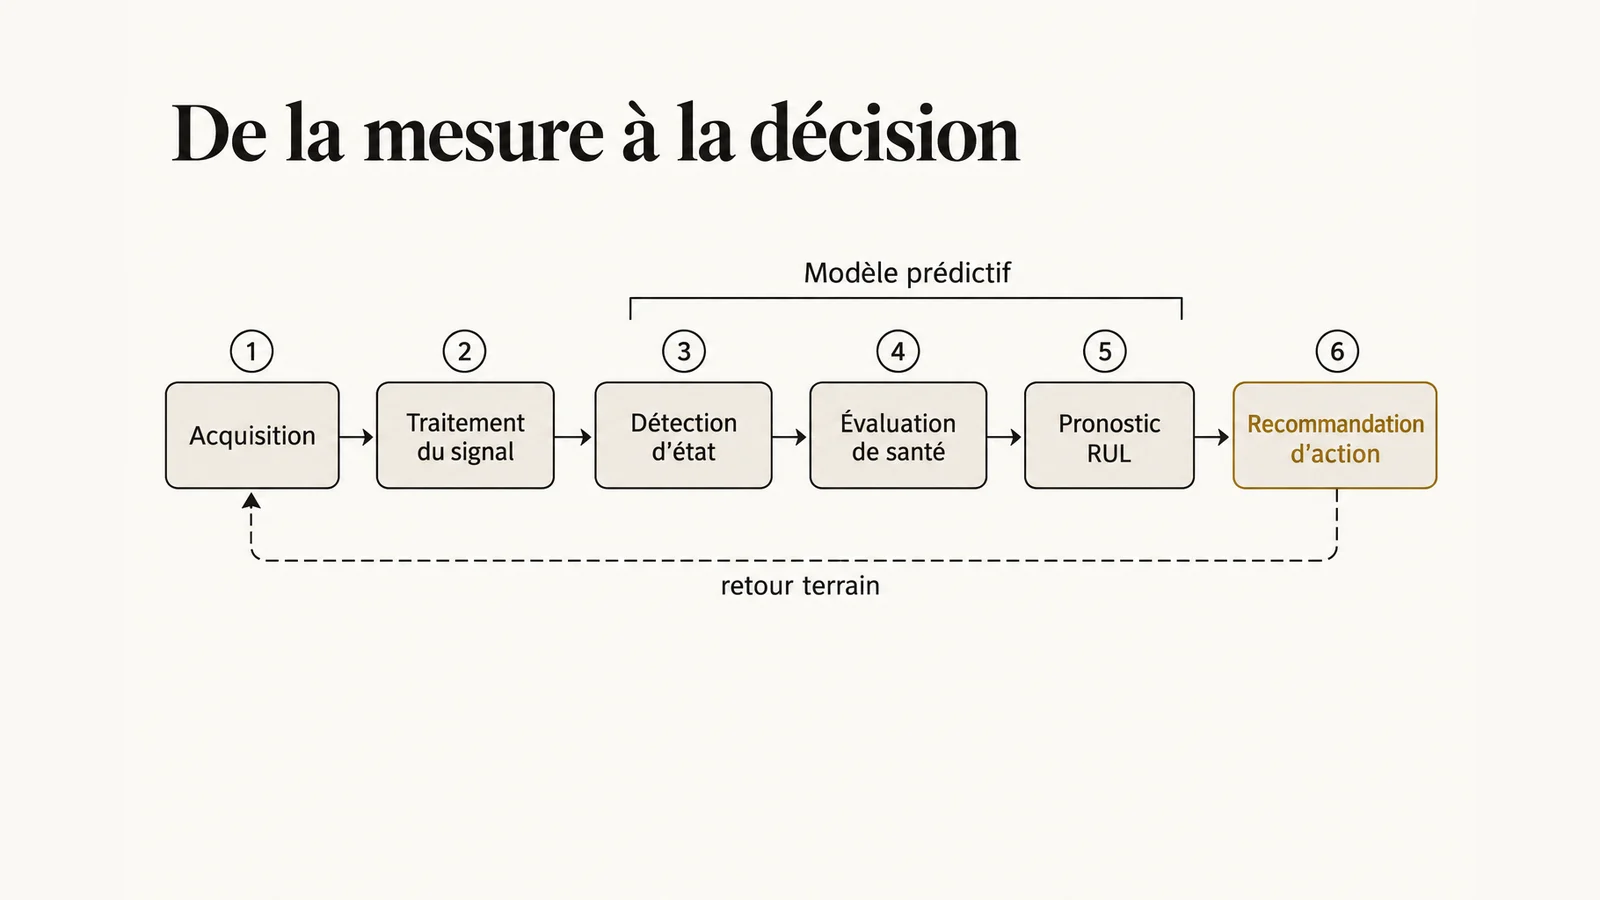
La sortie utile est double. D'un côté une détection : l'équipement s'écarte de son état normal. De l'autre un pronostic : la durée de vie résiduelle, souvent appelée RUL (remaining useful life), c'est-à-dire le temps ou le nombre de cycles restant avant que l'équipement ne puisse plus remplir sa fonction. Pour comprendre comment ce modèle de référence se construit et se recale sur la mesure, voir la modélisation et la calibration d'un jumeau numérique, et pour le cadre général, la définition du jumeau numérique et ses exemples.
Préventive, conditionnelle, prédictive : quelle différence ?
La maintenance préventive intervient selon un calendrier, la conditionnelle intervient quand un indicateur franchit un seuil, la prédictive intervient selon une prévision de l'évolution de la dégradation.
La norme NF EN 13306, qui fixe la terminologie de la maintenance, distingue ces niveaux. La maintenance prédictive, dite prévisionnelle dans la norme, est une forme de maintenance conditionnelle : elle ne se contente pas de constater un état, elle extrapole la tendance des paramètres de dégradation pour choisir le moment de l'intervention.
| Type | Déclencheur | Donnée nécessaire | Limite principale |
|---|---|---|---|
| Préventive systématique | Échéance de temps ou de cycles | Plan de maintenance | Remplace des pièces encore saines, rate les défaillances précoces |
| Conditionnelle | Indicateur au-delà d'un seuil | Mesure d'état en continu ou par ronde | Prévient tard, sans estimation du temps restant |
| Prédictive | Prévision de la date de défaillance | Historique de mesures et de pannes, modèle | Exige des données de dégradation et une incertitude maîtrisée |
En pratique, une installation combine les trois. La question n'est pas de basculer tout le parc en prédictif, mais d'identifier les équipements où une prévision change réellement la décision.
Faut-il partir de la physique, des données ou des deux ?
Les approches fondées sur la physique expliquent mais coûtent cher à construire, les approches fondées sur les données s'adaptent mais exigent des pannes observées, et l'approche hybride est celle qui tient le mieux en production.
Fondée sur la physique
On modélise le mécanisme de dégradation : usure, fatigue, encrassement, perte de rendement. Le modèle extrapole correctement hors des données observées tant que le mécanisme est le bon. Son coût est l'expertise et le calage des paramètres, et il ne couvre que les modes de défaillance qu'on a pensé à modéliser.
Fondée sur les données
On apprend la dégradation directement sur les séries de capteurs : détection d'anomalies non supervisée, régression de la RUL, classification des modes de défaillance. C'est rapide à prototyper, mais un modèle de données n'est valide que dans le domaine couvert par son apprentissage, ce que j'ai détaillé à propos de la validation des simulations physiques par IA.
Hybride
Le jumeau physique calcule le comportement attendu, et le modèle de données apprend sur les résidus, c'est-à-dire l'écart entre attendu et mesuré. Ce découpage retire du signal les variations dues au régime de fonctionnement, qui sont la première source de fausses alertes. Quand le modèle physique est trop lent pour tourner en continu, un modèle de substitution en donne une approximation exploitable en temps réel.
Pourquoi les données sont-elles le vrai problème ?
Un modèle prédictif apprend la défaillance à partir d'exemples de défaillance, et un équipement bien entretenu en fournit très peu.
C'est le paradoxe central. Les jeux de données publics comme NASA C-MAPSS (Saxena et al., 2008) contiennent des trajectoires complètes de turboréacteurs simulés jusqu'à la panne, avec plusieurs conditions de vol et un bruit de mesure ajouté. Ils sont précieux pour comparer des méthodes, mais leurs pannes sont abondantes parce qu'elles sont simulées. Sur un parc réel, on dispose de quelques défaillances par mode, souvent interrompues par une intervention préventive avant leur terme.
Viennent ensuite l'étiquetage et l'historique. La date de la panne est rarement celle saisie dans la GMAO : un ordre de travail est créé après coup, avec une cause générique ou absente. Avant toute modélisation, je commence par rapprocher les ordres de travail des séries de mesures, équipement par équipement, avec un responsable maintenance. Ce travail de corpus est le projet, comme pour tout système d'IA alimenté par des données métier.
Enfin, les capteurs dérivent, sont remplacés, recalibrés ou déplacés. Une dérive de capteur ressemble à une dégradation de l'équipement. Sans registre des interventions sur l'instrumentation, le modèle apprend la vie du capteur plutôt que celle de la machine.
Quelles métriques disent si le modèle sert à quelque chose ?
Un modèle de maintenance prédictive se juge sur le coût des erreurs qu'il commet et sur le délai d'anticipation qu'il laisse, pas sur sa précision moyenne.
Une fausse alerte et une panne manquée n'ont pas le même prix. Exemple purement illustratif : si une fausse alerte coûte une inspection d'une demi-journée et une panne manquée deux jours d'arrêt de ligne, on accepte plusieurs fausses alertes pour éviter une panne, mais pas cinquante. Le seuil de décision se fixe sur ce rapport de coûts, établi avec l'exploitation, et non sur le score par défaut de l'algorithme.
La précision (part des alertes qui correspondent à une vraie dégradation) et le rappel (part des dégradations réelles qui ont été signalées) se mesurent par mode de défaillance, pas globalement. Une précision trop faible use la confiance des équipes en quelques semaines ; un rappel trop faible rend l'outil inutile.
Le délai d'anticipation utile compte autant. Une alerte qui arrive deux heures avant la panne ne sert à rien si la pièce de rechange demande trois semaines. Le jeu de référence C-MAPSS l'inscrit dans sa métrique : le score défini par Saxena et ses coauteurs est asymétrique et pénalise davantage une estimation de RUL trop tardive qu'une estimation trop précoce. Ces mesures doivent ensuite être suivies dans le temps, ce qui relève de l'évaluation continue.
Pourquoi tant de pilotes de maintenance prédictive échouent-ils ?
Les pilotes échouent rarement sur la qualité du modèle ; ils échouent parce qu'aucune décision n'est reliée à l'alerte, que les seuils ne sont pas tenus et que personne n'entretient le modèle.
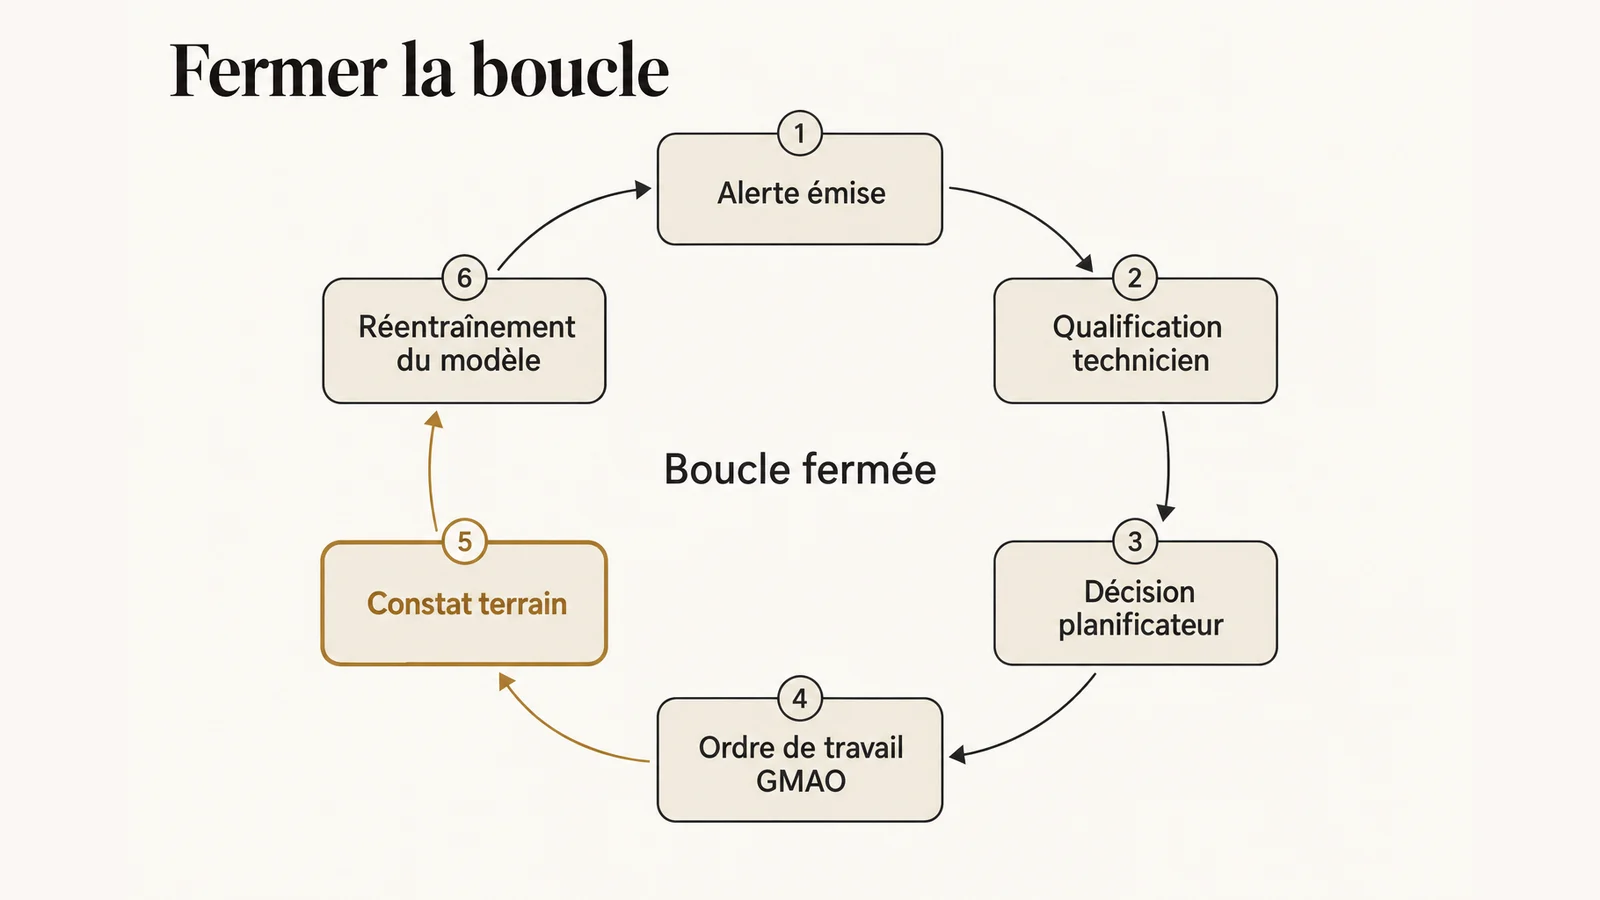
Premier motif : l'alerte n'a pas de destinataire. Elle s'affiche sur un tableau de bord consulté par l'équipe projet, pas dans l'outil où le planificateur prépare les interventions. Sans ordre de travail créé, il n'y a ni action ni retour sur la justesse de l'alerte.
Deuxième motif : les seuils ne sont pas tenus. Après quelques fausses alertes, quelqu'un relève le seuil pour avoir la paix, et le modèle cesse de détecter. Le seuil doit être un paramètre gouverné, modifié selon une règle écrite et tracée.
Troisième motif : le modèle vieillit sans surveillance. Une révision, un changement de produit fabriqué, un capteur remplacé modifient la distribution des données. Les causes d'enlisement sont les mêmes que pour un prototype qui ne passe jamais, et le travail de la deuxième année ressemble à celui décrit pour la maintenance d'un système d'IA.
Comment mettre un modèle de maintenance prédictive en production ?
La mise en production commence par le choix d'un équipement et d'une décision, pas par le choix d'un algorithme, et se termine par une boucle de retour terrain qui alimente le modèle.
Voici la méthode en étapes que je recommande :
- Choisir un équipement critique et un mode de défaillance précis, pour lequel une anticipation change une décision (commande de pièce, planification d'arrêt).
- Chiffrer avec l'exploitation le coût d'une panne, le coût d'une fausse alerte et le délai d'anticipation minimal utile.
- Rapprocher l'historique GMAO des séries de mesures et constituer un jeu étiqueté, même petit.
- Commencer par une détection d'anomalies sur résidus d'un modèle de référence, avant toute régression de RUL.
- Brancher l'alerte dans l'outil du planificateur, avec un champ de retour obligatoire : alerte confirmée, infirmée, indéterminée.
- Faire tourner le système en parallèle de la pratique actuelle pendant une période définie, puis comparer.
- Surveiller en continu la qualité des données d'entrée et les performances, et planifier le réentraînement.
L'étape 7 relève de l'observabilité des systèmes d'IA : la dérive d'un capteur doit être détectée comme une anomalie de donnée, et non comme une dégradation de la machine. La norme ISO 17359 décrit d'ailleurs les étapes générales d'un programme de surveillance d'état dans le même esprit.
Qui décide à partir de l'alerte ?
L'alerte est une aide à la décision : la décision d'intervenir appartient à la maintenance, et ce partage doit être écrit avant la mise en service.
Dans la chaîne de traitement de référence associée à la série ISO 13374, la dernière étape est la génération de recommandations, pas l'exécution. Le modèle signale et estime ; un technicien qualifie l'alerte ; le responsable de la planification arbitre entre la production et l'intervention. Chaque rôle doit savoir ce qu'il reçoit, dans quel délai il doit répondre et ce qu'il trace.
Cette répartition protège aussi le modèle. Si l'alerte déclenche automatiquement un arrêt, la moindre fausse alerte coûte une production et le projet est arrêté. Si elle passe par une qualification humaine, les erreurs deviennent des étiquettes qui améliorent le modèle. C'est le principe d'une supervision humaine conçue et non simplement promise.
Pour les industriels qui veulent cadrer un tel projet, la page jumeaux numériques détaille l'accompagnement proposé, et la page industrie les cas d'usage du secteur.
Questions fréquentes
Quelle est la différence entre maintenance prédictive et jumeau numérique ?
La maintenance prédictive est un objectif : estimer quand un équipement va défaillir à partir de ses données. Le jumeau numérique est un moyen : un modèle de l'équipement synchronisé avec ses mesures. Utilisé en maintenance, il fournit le comportement attendu, et l'écart à ce comportement sert de signal de dégradation.
Qu'est-ce que la durée de vie résiduelle (RUL) ?
La durée de vie résiduelle, ou RUL pour remaining useful life, est le temps ou le nombre de cycles qui restent avant qu'un équipement ne puisse plus remplir sa fonction. Elle s'exprime utilement avec un intervalle d'incertitude, pas comme une valeur unique. Une estimation trop tardive coûte en général plus cher qu'une estimation trop précoce.
Peut-on faire de la maintenance prédictive sans historique de pannes ?
On peut commencer par de la détection d'anomalies, qui apprend le fonctionnement normal et signale les écarts sans exemple de panne. L'estimation de la RUL, elle, exige des trajectoires de dégradation, observées ou simulées par un modèle physique. Un jumeau physique permet de compenser en partie la rareté des pannes réelles.
À quoi sert le jeu de données NASA C-MAPSS ?
C-MAPSS est un jeu de données de turboréacteurs simulés jusqu'à la panne, publié par le centre de pronostic de la NASA Ames et décrit par Saxena et ses coauteurs en 2008. Il sert de référence pour comparer les méthodes d'estimation de la RUL. Ses pannes sont simulées et abondantes, ce qui le rend peu représentatif de la rareté des pannes sur un parc réel.
Comment éviter les fausses alertes en détection d'anomalies capteurs ?
Il faut d'abord retirer du signal les variations dues au régime de fonctionnement, par exemple en travaillant sur les résidus d'un modèle de référence. Ensuite, le seuil se fixe sur le rapport entre coût d'une fausse alerte et coût d'une panne manquée. Enfin, les dérives et remplacements de capteurs doivent être tracés pour ne pas être confondus avec une dégradation.
Quelles normes encadrent la surveillance d'état et le jumeau numérique ?
La norme ISO 17359 donne les lignes directrices d'un programme de surveillance d'état des machines, et la série ISO 13374 décrit le traitement, la communication et la présentation des données de surveillance. La série ISO 23247 propose un cadre de jumeau numérique pour la fabrication. La norme NF EN 13306 fixe la terminologie de la maintenance.
Sources
- ISO 13374-1:2003, Surveillance et diagnostic d'état des machines : traitement, communication et présentation des données, partie 1.
- ISO 17359:2018, Surveillance et diagnostic d'état des machines : lignes directrices générales.
- ISO 23247-1:2021, Cadre du jumeau numérique pour la fabrication : vue d'ensemble et principes généraux.
- Saxena, Goebel, Simon et Eklund, Damage Propagation Modeling for Aircraft Engine Run-to-Failure Simulation, PHM 2008 (notice NASA NTRS).
- NASA Ames, Prognostics Center of Excellence : dépôt de données, dont Turbofan Engine Degradation Simulation (C-MAPSS).
- NF EN 13306 (janvier 2018), Maintenance : terminologie de la maintenance, AFNOR.
Analyse et méthode proposées par Anand Candassamy au 10 octobre 2026.