Qu’est-ce que réindexer un corpus, et pourquoi le volume surprend-il ?
Réindexer un corpus consiste à reconstruire sa représentation de recherche, mais le coût de cette opération doit être comparé en euros et en travail réel, pas seulement en jetons.
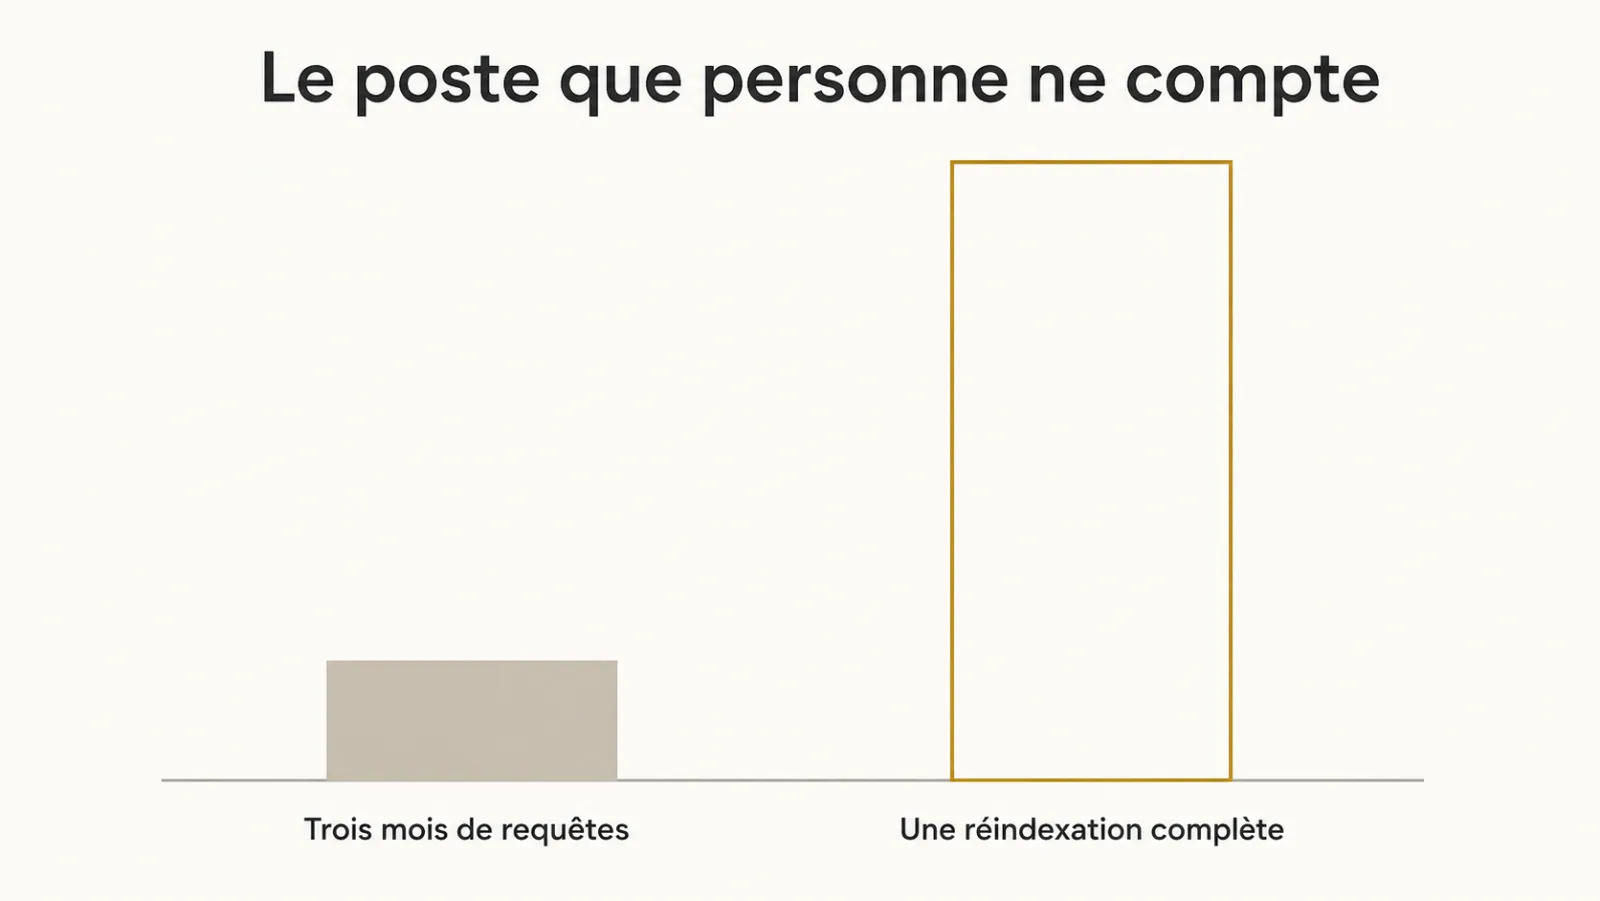
Sur mes chaînes documentaires, ce constat porte sur les volumes retraités, sans conversion automatique en euros ou en kilowattheures : Sur les chaînes documentaires que j’exploite, une réindexation complète consomme l’équivalent de plusieurs mois de requêtes utilisateurs. Le rapport surprend parce que les deux opérations ne se ressemblent pas. Ce relevé porte sur les volumes et opérations traités ; il ne fournit pas, à lui seul, une conversion en kilowattheures ou en prix de jetons.
Le titre désigne un risque à vérifier, pas une règle universelle. La légende du schéma illustre une hypothèse de charge : elle ne fournit pas une mesure financière de votre système.
Réindexer coûte-t-il vraiment plus cher que répondre, en euros ?
En euros, réindexer ne coûte plus cher que répondre que dans certaines configurations : la comparaison en volume de jetons ne se transpose pas directement en coût, car un jeton d’embarquement est bien moins cher qu’un jeton de génération. Il faut le préciser pour ne pas tirer de mauvaise conclusion.
Exemple de calcul, sans mesure de projet : cinquante mille fragments de cinq cents jetons représentent vingt-cinq millions de jetons. Au tarif de 0,02 dollar par million annoncé pour text-embedding-3-small en janvier 2024, leur seul calcul de vecteurs revient à 0,50 dollar. Ce tarif d’origine publié par OpenAI ne comprend ni extraction, ni stockage, ni enrichissement, ni travail humain.
La réindexation redevient le poste lourd dans trois situations, qu’il faut chiffrer séparément :
- le modèle d’embarquement est hébergé en interne, et chaque reprise mobilise des machines pendant des heures ;
- l’extraction passe par un modèle multimodal, pour lire des documents scannés, et elle est refaite à chaque reprise ;
- la chaîne comporte des enrichissements génératifs, résumés ou métadonnées produits par un modèle, recalculés sur tout le corpus.
Dans tous les cas, le volume de calcul ne suffit pas à établir une consommation électrique, mais il aide à définir le périmètre de mesure, comme expliqué dans ce qu’un système consomme avant la première réponse.
| Configuration | Coût d’une reprise intégrale | Priorité de l’incrémental |
|---|---|---|
| Embarquements par API, texte natif | Modeste | Utile, surtout pour la sobriété |
| Embarquements hébergés en interne | Temps machine important | Élevée |
| Extraction multimodale des scans | Élevé, refait à chaque reprise | Très élevée |
| Enrichissement génératif du corpus | Élevé, au tarif de la génération | Très élevée |
Sur mes chaînes documentaires, ce constat porte sur les volumes retraités, sans conversion automatique en euros ou en kilowattheures : Une requête traite quelques milliers de jetons. Une réindexation traite l’intégralité du corpus : chaque document lu, découpé, transformé en vecteurs. Sur cinquante mille fragments, l’opération représente des dizaines de millions de jetons. Ce relevé porte sur les volumes et opérations traités ; il ne fournit pas, à lui seul, une conversion en kilowattheures ou en prix de jetons.
Quand une réindexation complète est-elle nécessaire ?
Une réindexation complète peut être nécessaire notamment dans quatre cas : changement de modèle d’embarquement, changement de découpage, correction d’une erreur systématique d’extraction, et reprise d’un corpus dont on ne connaît pas l’état. Vérifiez également les changements de droits et les contraintes de l’index avant de décider.
Le changement de modèle d’embarquement, d’abord. Des vecteurs issus de modèles différents ne doivent pas être comparés sans validation de leur compatibilité : il faut tout recalculer. C’est ce qui fait de ce choix la décision la moins réversible de la chaîne, comme rappelé dans les embeddings expliqués à une direction.
Le changement de découpage, ensuite, pour la même raison : les fragments ne sont plus les mêmes objets.
La correction d’une erreur systématique d’extraction, troisième cas, quand on découvre que tout un format de document a été mal lu.
Et la reprise d’un corpus dont on ne connaît pas l’état, quatrième cas, qui arrive lors d’une reprise de système. Le diagnostic préalable figure dans reprendre un système d’IA construit par quelqu’un d’autre.
Quels documents traiter lors d’une réindexation incrémentale ?
Une réindexation incrémentale traite les documents ajoutés ou modifiés et propage les suppressions, tout en vérifiant les métadonnées et les droits qui peuvent évoluer sans changement de texte.
- Les documents ajoutés, qui ne demandent que leur propre traitement.
- Les documents modifiés, repérés par leur date de dernière écriture ou une empreinte de contenu.
- Les documents retirés, dont les fragments doivent disparaître de l’index sous peine de réponses fondées sur des pièces supprimées.
- Les droits et métadonnées modifiés, même lorsque le texte du document est resté identique.
Pourquoi les équipes réindexent-elles tout le corpus par défaut ?
Les équipes réindexent tout le corpus par défaut parce que la reprise intégrale est simple à écrire et réduit la gestion d’un état antérieur. C’est un choix de confort d’ingénierie, rarement assumé comme tel.
Une reprise incrémentale demande de savoir ce qui a changé, donc de conserver un état : empreintes, horodatages, journal des suppressions. Cette gestion demande des contrôles de cohérence et des tests de suppression.
Sur les missions que j’ai menées, mon constat est le suivant : La reprise intégrale, elle, part de zéro à chaque fois. Elle est correcte par construction, et elle coûte cinquante fois plus. Le facteur cinquante porte sur le poste de reprise de ces missions, distinct du prix des seuls embeddings dans l’exemple tarifaire historique.
Le bon arbitrage dépend de la volumétrie et de la configuration décrite plus haut. Comparez le coût d’une reprise complète à celui du suivi d’état. Ni un nombre de fragments ni une durée universelle de développement ne suffisent à trancher.
Dans le repère de cadence que j’utilise sur mes missions, le calcul porte sur le remplacement d’une reprise intégrale hebdomadaire par une reprise intégrale trimestrielle : La reprise trimestrielle rattrape cette dérive. Elle coûte cher, quatre fois par an au lieu de cinquante-deux, ce qui divise le poste par treize.
Comment passer d’une réindexation complète à une réindexation incrémentale ?
Passer à une réindexation incrémentale demande de conserver un état du corpus, de détecter ajouts, modifications et suppressions, puis de ne traiter que ces documents, avec une reprise intégrale périodique pour rattraper la dérive. La mise en place tient en cinq étapes.
- Calculer une empreinte par document. Une empreinte de contenu, plus fiable qu’une date de modification qui peut changer sans que le texte change.
- Stocker l’état. Pour chaque document : son empreinte, la liste de ses fragments, la date du dernier traitement.
- Comparer à chaque passage. Nouveaux documents, empreintes modifiées, documents disparus.
- Traiter les écarts uniquement. Indexer les nouveaux, recalculer les modifiés, supprimer de l’index les fragments des documents retirés.
- Vérifier l’index. Rejouer le jeu de tests après chaque passage important, pour s’assurer que la récupération n’a pas régressé.
Le coût de chaque fonctionnalité, reprises comprises, se suit ensuite comme décrit dans mesurer le coût par fonctionnalité.
Transmettez le suivi d’état et le traitement des suppressions à l’équipe d’exploitation. Une formation IA peut prendre ces opérations réelles comme exercices de reprise, avec vérification de l’index après incident.
Comment choisir la fréquence de réindexation d’un corpus d’IA ?
La fréquence de réindexation doit suivre la fraîcheur attendue, les suppressions et le coût des traitements, avec des contrôles de cohérence adaptés plutôt qu’une cadence uniforme. Une reprise trimestrielle reste un exemple de compromis.
L’incrémental quotidien traite les ajouts, modifications et suppressions du jour. Il est rapide, peu coûteux, et il peut dériver légèrement : un document oublié, une suppression mal propagée.
Une reprise complète peut corriger une dérive, mais ne doit pas retarder une suppression urgente. Pour une équipe qui faisait jusque-là une reprise intégrale chaque semaine, passer à quatre reprises par an au lieu de cinquante-deux divise par treize le nombre de reprises complètes, sous l’hypothèse explicite d’un coût identique par reprise ; le gain est moindre si la reprise était déjà moins fréquente.
Ce rythme s’inscrit naturellement dans le rendez-vous d’entretien décrit dans ce qui occupe l’équipe la deuxième année, où il rejoint le rejeu du jeu de tests et la relecture de la fiche du système.
Repère de travail que j’utilise sur mes missions : Une réindexation complète se justifie dans quatre cas, et dans quatre seulement. Hors de ces cas, elle est une habitude.
Comment comparer le coût de réindexation au coût des réponses ?
La comparaison doit valoriser séparément extraction, calcul de vecteurs, enrichissements, stockage et réponses sur la même période, puis ajouter les reprises et le temps humain.
Comptabilisez des jetons par type de traitement, des durées machine et des coûts réels. Multiplier des fragments par des reprises ne donne ni des jetons ni des euros : il faut connaître la taille des entrées et le tarif applicable.
Comment le choix de découpage influe-t-il sur le coût de réindexation ?
Le choix de découpage influe directement sur le coût de réindexation, car un découpage plus fin multiplie le nombre de fragments, donc le volume de chaque reprise, et cette conséquence n’apparaît jamais au moment du choix. Elle mérite d’être posée.
Passer d’un fragment par section à un fragment par paragraphe peut multiplier le volume par cinq. La qualité de récupération y gagne parfois ; le coût de maintenance y perd toujours, et de façon récurrente.
Le bon réflexe consiste à chiffrer les deux avant de trancher : le gain mesuré sur le jeu de tests d’un côté, le surcoût annuel de reprise de l’autre. Documentez le protocole et les incertitudes.
Dans la majorité des cas que j’ai instruits, le découpage plus fin n’apportait rien de mesurable, et il avait été adopté par défaut. Le sujet est traité sous son angle qualité dans découper un document, et l’alignement entre économie et sobriété dans le choix économique et le choix sobre coïncident. Un audit IA inclut ce chiffrage lorsqu’il porte sur une chaîne documentaire existante.
Quelles questions poser avant de réindexer un corpus d’IA ?
Quand une réindexation complète est-elle nécessaire ?
Une reprise complète peut être nécessaire après un changement de modèle de vecteurs, de découpage ou d’extraction, mais la décision dépend aussi des contraintes de compatibilité et de cohérence de l’index.
Réindexer coûte-t-il toujours plus cher que répondre ?
Le nombre de jetons ne suffit pas à comparer réindexation et réponses en euros, car embeddings, génération, extraction et stockage relèvent de coûts différents. Chiffrez chaque poste avec ses hypothèses.
Pourquoi les équipes réindexent-elles tout ?
Une reprise intégrale simplifie le suivi d’état, mais elle reste exposée aux erreurs d’extraction, aux documents oubliés et aux droits mal propagés. Sa cohérence doit être vérifiée comme celle d’un incrémental.
Quel rythme de réindexation adopter ?
Le rythme dépend de la fraîcheur attendue et des changements du corpus, tandis qu’une reprise complète périodique reste un choix de contrôle à justifier par son coût et son utilité.
Le découpage influe-t-il sur le coût de réindexation ?
Directement : un découpage plus fin multiplie le nombre de fragments et donc le volume de chaque reprise ; Cette conséquence doit être chiffrée avant de choisir la maille, face au gain mesuré sur le jeu de tests.
Comment détecter les documents modifiés pour une reprise incrémentale ?
Par une empreinte de contenu calculée pour chaque document et comparée à celle du passage précédent ; Elle est plus fiable qu’une date de modification, qui peut changer sans que le texte change.