Que change la famille Claude 3 pour une entreprise ?
La famille Claude 3 transforme le choix d’un modèle en répartition des tâches entre plusieurs paliers, avec des compromis distincts de coût, de rapidité et de qualité.
Anthropic annonce Claude 3 le 4 mars 2024 : Haiku, Sonnet et Opus. Sonnet et Opus sont disponibles ce jour-là ; Haiku est annoncé pour une disponibilité prochaine. Il faut donc distinguer le catalogue présenté de ce que l’on peut réellement tester immédiatement.
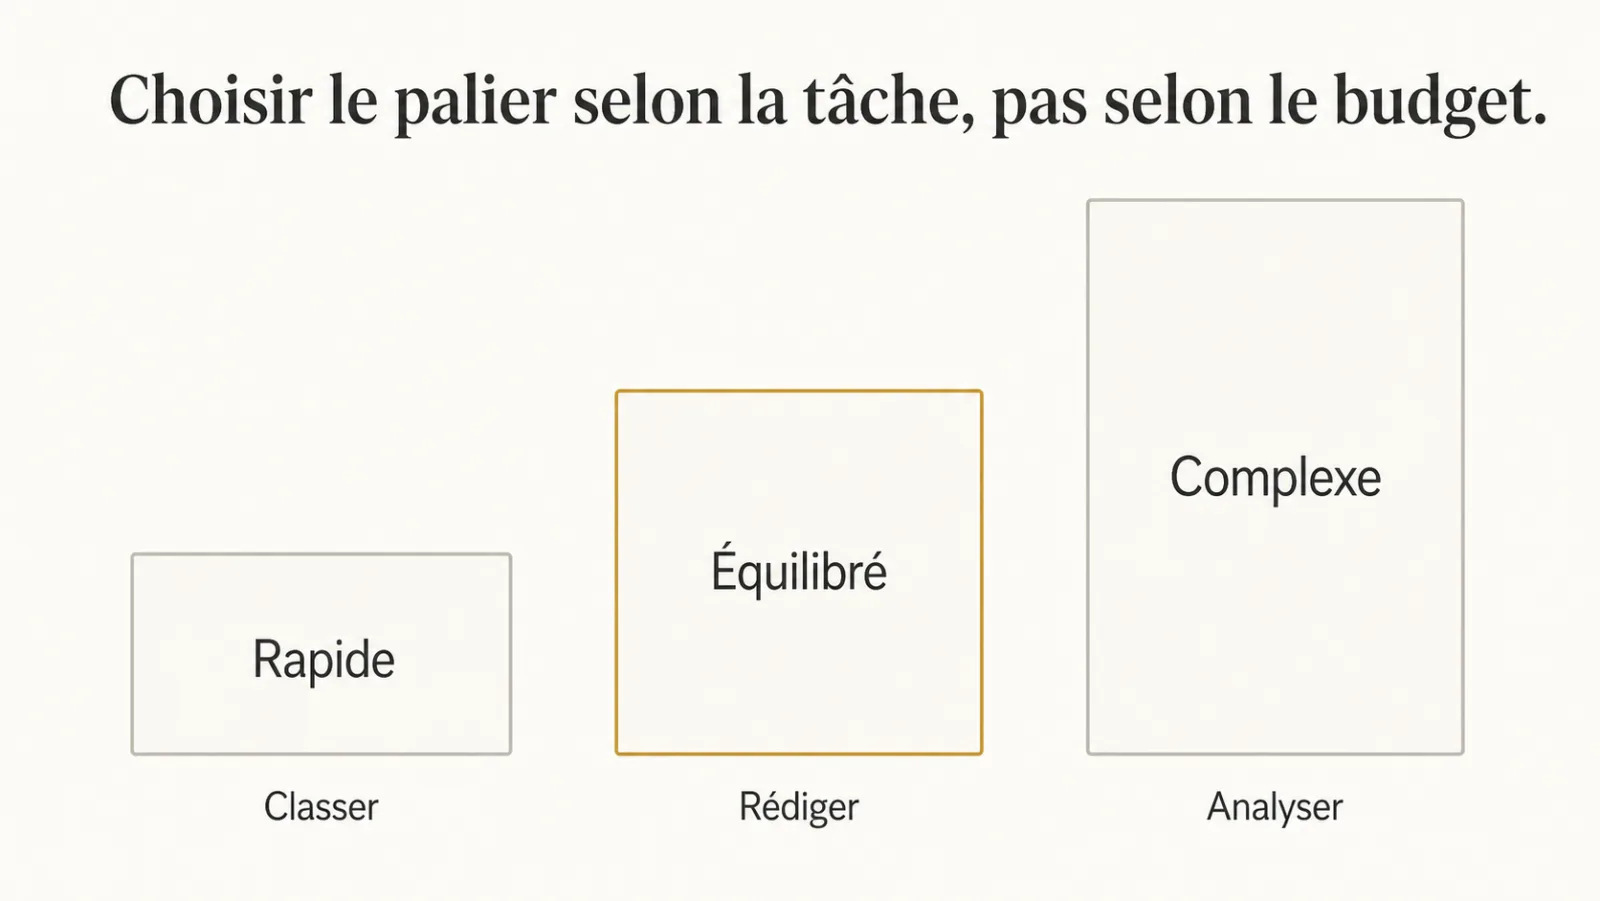
Je retiens surtout la possibilité de traiter différemment les appels d’un même système. Une extraction courte, une rédaction et une analyse de dossier ne justifient pas nécessairement le même budget. Une famille cohérente facilite cette répartition, sans rendre les comportements identiques.
La question utile n’est pas « quel est le meilleur modèle ? ». C’est « quel palier satisfait les exigences de cette tâche ? ». Le raisonnement était déjà pertinent avec Mistral 7B. Claude 3 le rend plus visible dans une même offre.
Quels tarifs sont annoncés pour Haiku, Sonnet et Opus ?
Les tarifs annoncés pour Claude 3 séparent les jetons d’entrée et de sortie, avec un rapport de soixante entre Haiku et Opus à volume comparable.
| Palier | Entrée, dollars par million de jetons | Sortie, dollars par million de jetons | Situation au 4 mars 2024 |
|---|---|---|---|
| Haiku | 0,25 | 1,25 | Annoncé, disponibilité prochaine |
| Sonnet | 3 | 15 | Disponible dans l’API |
| Opus | 15 | 75 | Disponible dans l’API |
Ce sont les prix présentés par Anthropic au lancement, et non un tarif garanti pour un projet ou un canal de distribution particulier. Ils doivent être reliés au volume effectivement envoyé et produit.
Le rapport de prix ne prédit pas le coût d’une réponse acceptée. Une réponse plus longue, un nouvel essai ou une correction humaine changent le résultat. Je compare donc les paliers à tâche et exigences constantes, avec les sorties conservées.
La facture liée aux grandes fenêtres rappelle pourquoi le seul prix unitaire ne suffit pas : le contexte envoyé pèse lui aussi.
Comment choisir le palier adapté à chaque tâche ?
Le palier adapté est celui qui respecte les critères métier sur un jeu de cas explicite, pour un coût complet acceptable et une latence compatible avec l’usage.
Je pars d’un palier disponible comme référence, puis je teste la possibilité de monter ou de descendre. L’intermédiaire peut constituer un point de départ pratique ; ce n’est pas une règle universelle.
Pour une extraction, les critères peuvent inclure la présence des champs attendus, l’absence de données inventées et le respect du format. Pour une synthèse, je regarde les omissions, les contradictions et la conservation des réserves. Un seul score global mélangerait des erreurs dont les conséquences diffèrent.
Un seuil doit être fixé avant de lire les résultats. Il traduit ce que l’organisation peut accepter et ce qui exige une validation. Une extraction destinée à une facture ne devient pas sûre parce qu’aucune erreur n’a été observée dans un petit échantillon.
Cette démarche prolonge le diagnostic des premiers essais GPT-4 : définir le travail attendu précède le jugement sur le modèle.
Comment construire une comparaison qui permette de décider ?
Une comparaison utile conserve les mêmes entrées, les mêmes exigences et les mêmes critères pour chaque palier, tout en séparant les erreurs bloquantes des défauts secondaires.
- Découper le processus en tâches identifiables, sans mélanger préparation et décision finale.
- Réunir des cas autorisés à être utilisés, avec une réponse ou des critères de référence.
- Inclure des cas courants, des ambiguïtés et des documents incomplets.
- Exécuter les paliers disponibles avec un protocole comparable et des versions identifiées.
- Mesurer qualité, durée, jetons et correction humaine pour chaque tâche.
- Décider d’une affectation, de ses limites et des conditions de réexamen.
Haiku peut être préparé comme candidat dans cette grille, mais sa validation attend sa disponibilité effective. Il serait anachronique d’affirmer que les trois modèles ont déjà été comparés en production à la date de l’annonce.
Je conserve les désaccords entre évaluateurs. Ils peuvent révéler un critère mal défini plutôt qu’un défaut du modèle. La comparaison doit produire une décision expliquée, pas un classement décoratif.
Quelles tâches peut-on confier à un palier moins coûteux ?
Un palier moins coûteux est un candidat pour les tâches délimitées et vérifiables, à condition que les cas difficiles et les conséquences d’erreur soient inclus dans l’évaluation.
La classification, la détection de langue et l’extraction de champs simples constituent des hypothèses de test. Elles ne sont pas des catégories automatiquement réservées au plus petit modèle. Une date ambiguë dans un contrat peut demander davantage de contrôle qu’une rédaction longue.
Je distingue aussi tâche facile et tâche sans enjeu. Une extraction simple qui déclenche une action sensible conserve son contrôle métier, quel que soit le palier. Le cadre de ce qu’on ne délègue pas au modèle aide à poser cette frontière.
Inversement, envoyer systématiquement toute demande au palier supérieur peut créer une dépense évitable. Il faut démontrer le gain sur les cas qui comptent. Je ne suppose ni que le petit palier égale le grand, ni que le grand améliore toujours le résultat.
Comment organiser le routage sans ajouter de fragilité ?
Le routage doit orienter les demandes avec des règles explicites, conserver une solution de repli et éviter qu’une économie locale ajoute des appels ou des erreurs inutiles.
Lorsque le type de tâche est connu dans l’application, une règle déterministe peut suffire. Faire appel à un modèle pour choisir un autre modèle ajoute un coût et une possibilité d’erreur ; cette étape doit justifier son intérêt.
Une politique de routage indique la tâche, le palier retenu, le critère de réussite et le traitement des cas non couverts. Le passage à un palier supérieur peut être prévu lorsque des éléments manquent, mais il ne remplace pas une demande de clarification utile.
Je limite les répétitions. Une boucle qui réessaie sans nouvelle information peut augmenter la facture sans améliorer la réponse. Les traces doivent expliquer quel palier a été appelé et pourquoi.
La couche d’intégration de Bedrock illustre la valeur d’une séparation entre application et modèle, avec des adaptations à vérifier pour chaque canal.
Quand faut-il reprendre la répartition entre les paliers ?
La répartition entre les paliers doit être reprise lorsqu’un modèle, une tâche, un corpus ou une exigence change, en rejouant les cas de référence avant toute généralisation.
Une décision correcte aujourd’hui peut devenir moins adaptée si le volume évolue ou si l’organisation ajoute un type de demande. Je conserve donc la date, la version et la raison de l’affectation.
Le jeu de cas sert de point de départ à la prochaine comparaison. Il doit intégrer les erreurs réellement observées et les nouveaux usages. Un résultat ancien ne suffit pas à valider une évolution du système.
Une bascule progressive permet de surveiller les corrections et de revenir à une configuration connue. Sa taille et sa durée dépendent du risque et du volume ; je n’impose pas un pourcentage universel.
Un audit IA peut vérifier que la comparaison reste exploitable : mêmes critères, dépenses visibles et responsabilité de décision. Il faut éviter de transformer une promesse de progression technique en économie automatiquement acquise.
Quelles erreurs faussent l’arbitrage économique entre modèles ?
L’arbitrage économique devient trompeur lorsqu’il compare seulement les prix affichés, ignore la correction humaine ou attribue une qualité constante à tous les appels d’un palier.
Je compte la réponse utilisable, avec les tentatives, les contrôles et les délais. Le temps économisé par l’utilisateur doit être examiné avec les nouvelles tâches de vérification.
Autre erreur : fixer une répartition dans le code sans documenter ses motifs. La personne suivante ne peut plus distinguer une exigence métier d’une habitude. Une règle configurable et une justification courte rendent la reprise possible.
La formation IA des personnes qui évaluent les sorties doit leur apprendre à reconnaître les erreurs de leur propre processus. Leur rôle consiste à juger une réponse par rapport à une tâche, et non à préférer une marque.
Lectures complémentaires : le coût réel d’un système IA et la dette technique.
Quelles questions fréquentes se poser sur Claude 3 ?
Les trois paliers sont-ils disponibles le 4 mars 2024 ?
Le 4 mars 2024, Anthropic annonce la famille Claude 3 avec Sonnet et Opus disponibles dans l’API, tandis que Haiku est annoncé pour plus tard. Il faut vérifier la disponibilité avant un essai.
Le palier supérieur est-il toujours le bon choix ?
Le palier supérieur n’est pas automatiquement le bon choix, car sa valeur dépend des erreurs évitées et des critères de la tâche au coût complet retenu. La comparaison doit démontrer son intérêt.
Comment interpréter le rapport de prix de soixante ?
Le rapport de soixante concerne les tarifs annoncés entre Haiku et Opus à volume comparable, pour les entrées comme pour les sorties, et non chaque résultat. Les tentatives changent le coût.
Un petit jeu de tests prouve-t-il l’absence d’erreur ?
Un petit jeu de tests permet une première comparaison, mais il ne prouve pas l’absence d’erreur sur toutes les demandes qui arriveront ensuite en exploitation. Il faut conserver les contrôles adaptés.
Faut-il utiliser un modèle pour router les demandes ?
Un modèle n’est pas nécessaire pour router les demandes lorsque leur type est déjà connu par l’application et peut être traité par une règle explicite. Tout appel supplémentaire doit apporter une valeur mesurée.
Que documenter pour la prochaine comparaison ?
Pour la prochaine comparaison, documentez les versions, les tâches, les critères, les mesures et les limites de la décision afin de rejouer un protocole cohérent. Ajoutez les nouveaux cas observés.