Qu’est-ce qui se joue avant le choix du modèle dans un projet d’IA ?
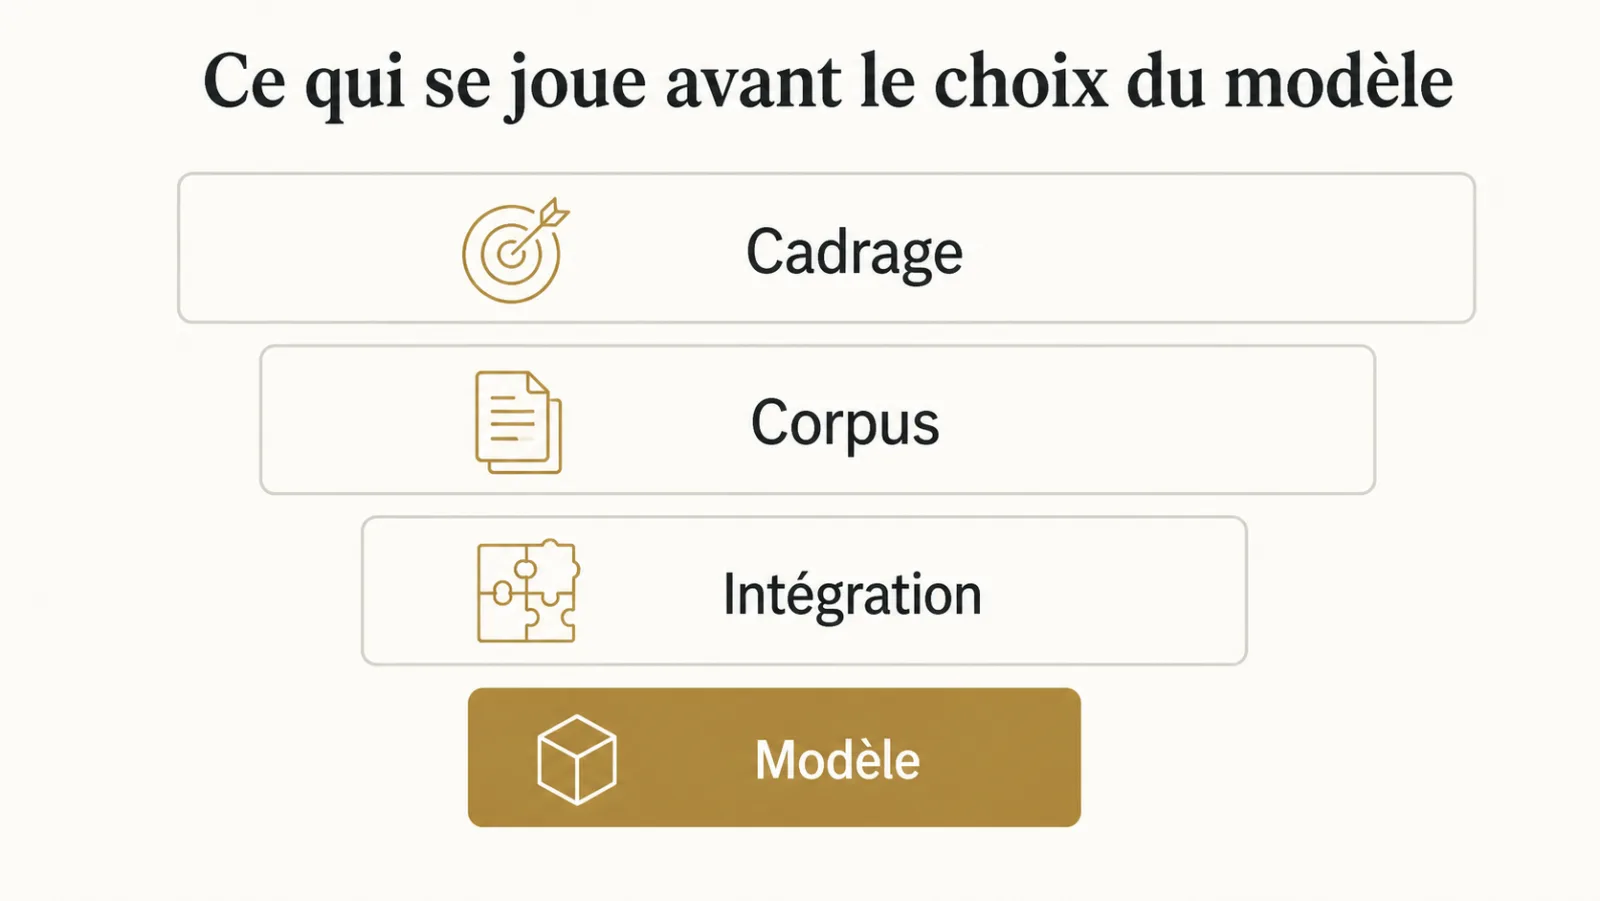
Avant le choix du modèle, un projet d’IA tranche trois décisions durables : le cadrage, l’état du corpus et le mode d’intégration aux applications existantes. Le modèle vient en dernier, et c’est la plus réversible des quatre.
Le cadrage fixe ce que le système fera et, surtout, ce qu’il ne fera pas. Le corpus désigne l’ensemble des documents et des données sur lesquels il s’appuiera, avec leur fraîcheur, leurs versions et leurs droits d’accès. L’intégration décrit la manière dont le système lit et écrit dans les logiciels que l’organisation utilise déjà.
Ces trois décisions ont un point commun : une fois prises, elles suivent le système toute sa vie. Les revoir après coup revient à reconstruire une partie du projet. Le modèle, lui, se remplace derrière une interface stable, et il sera remplacé.
Pourquoi le choix du modèle est-il la décision la moins durable ?
Le choix du modèle occupe l’essentiel des discussions de démarrage d’un projet d’IA, alors qu’il sera repris plusieurs fois dans l’année. Les trois décisions qui le précèdent, elles, suivront le système toute sa vie.
Ce déséquilibre a une explication simple : le modèle est la partie visible, celle qui a un nom, un prix affiché et des classements publics. Chaque annonce relance la discussion ; savoir lire une annonce de benchmark aide à ne pas s’y perdre.
Le cadrage, l’état du corpus et le mode d’intégration n’ont ni nom ni classement. Ils se discutent mal et ils décident du résultat.
Sur les systèmes que j’ai repris, les causes d’échec que j’ai pu identifier tenaient rarement au modèle : elles se trouvaient le plus souvent dans l’une des trois autres décisions. C’est une observation de terrain, pas une statistique. La démarche d’inspection correspondante est décrite dans reprendre un système d’IA construit par quelqu’un d’autre.
Sur les missions que j’ai menées, mon constat est le suivant : Le choix du modèle occupe l’essentiel des discussions de démarrage et il sera repris deux à trois fois dans l’année. Les trois décisions qui le précèdent, elles, suivront le système toute sa vie.
Que doit produire le cadrage d’un projet d’IA ?
Un cadrage utile de projet d’IA produit une liste de ce qui est écarté, pas seulement de ce qui est retenu, avec une raison et une condition de réouverture pour chaque cas. C’est la partie qui rapporte le plus et qui ne laisse aucun livrable visible.
Sur les missions que j’ai menées, mon constat est le suivant : Sur cinq cas d’usage présentés, deux au plus méritent d’être poursuivis. Les trois autres échouent pour des raisons identifiables dès le départ : corpus indisponible, absence de propriétaire, résultat invérifiable.
- corpus indisponible : les documents nécessaires n’existent pas, sont dispersés ou ne sont pas accessibles ;
- absence de propriétaire : personne côté métier ne portera le système une fois livré ;
- résultat invérifiable : personne ne sait dire ce qu’est une bonne réponse, donc personne ne pourra dire si le système fonctionne.
Sur les missions que j’ai menées, mon constat est le suivant : Écarter ces trois-là évite trois projets qui auraient consommé leur budget avant de s’arrêter. Le raisonnement complet figure dans combien de cas d’usage faut-il abandonner. Le raisonnement complet figure dans combien de cas d’usage faut-il abandonner, et les mécanismes d’enlisement dans l’anatomie d’un POC qui ne passe jamais.
La forme compte : un cas écarté doit être remplacé par une condition explicite de réouverture, sinon l’exercice est vécu comme un refus. Par exemple : « rouvert quand les contrats seront consolidés dans un seul référentiel ».
Le corpus : quatre questions, une demi-journée
- Combien de documents, et de quand datent-ils ? Un index constitué il y a dix-huit mois répond sur des procédures abrogées.
- Existe-t-il plusieurs versions, et laquelle fait foi ? Si personne ne sait, le système ne saura pas non plus.
- Quels droits d’accès s’appliquent, et à quel moment de la chaîne ? Filtrer après la recherche n’est pas une protection.
- Qui signale qu’un document a changé ? Sans réponse, le corpus vieillit en silence. Voir le corpus est le projet.
Pourquoi l’intégration aux applications existantes prend-elle autant de temps ?
Brancher un système d’IA sur les applications existantes prend souvent plus de temps que tout le reste, parce qu’une partie de ces applications n’expose aucune interface programmable. C’est le poste le plus sous-estimé au cadrage.
Le travail administratif d’une organisation se déroule dans des progiciels installés il y a dix ou quinze ans, dont l’éditeur facture cher toute évolution.
Trois ponts existent, et ils n’ont ni le même coût ni la même fragilité :
- L’export de fichiers : le progiciel produit un fichier à intervalle régulier, que le système lit. Simple et robuste, mais la donnée n’est jamais plus fraîche que le dernier export.
- La lecture en base : le système interroge directement la base de données du progiciel. Plus frais, mais dépendant d’un schéma souvent non documenté, que l’éditeur peut modifier lors d’une mise à jour.
- Le pilotage de l’écran : un automate reproduit les clics d’un utilisateur. C’est le plus spectaculaire en démonstration et presque toujours le plus fragile, car il casse au moindre changement d’interface.
Le choix se fait sur trois critères, détaillés dans brancher un modèle sur un progiciel sans API. Cette question doit être instruite au cadrage, parce qu’elle peut à elle seule disqualifier un cas d’usage par ailleurs excellent.
Sur les missions que j’ai menées, mon constat est le suivant : Brancher le système sur les applications existantes prend plus de temps que tout le reste, et la moitié d’entre elles n’expose aucune interface programmable. C’est le poste le plus sous-estimé au cadrage.
Comment comparer les quatre décisions d’un démarrage de projet d’IA ?
Les quatre décisions de démarrage d’un projet d’IA se comparent sur leur durée de vie, leur coût de révision et le livrable qui prouve qu’elles ont été prises. Le tableau ci-dessous les met côte à côte.
| Décision | Ce qu’elle tranche | Coût de révision après coup | Livrable qui la matérialise |
|---|---|---|---|
| Cadrage | Les cas retenus et les cas écartés | Élevé : on reconstruit le périmètre et les attentes | Liste des cas écartés avec condition de réouverture |
| Corpus | Les documents, leur version de référence, leurs droits | Élevé : il faut réindexer et revalider | Inventaire daté et propriétaire de la mise à jour |
| Intégration | Le pont vers chaque application existante | Élevé : le pont conditionne l’architecture | Choix du pont par application, avec ses limites |
| Modèle | Le fournisseur et le palier utilisés | Faible si une couche d’abstraction existe | Résultat du jeu de tests sur le palier retenu |
La dernière ligne suppose deux éléments posés dès le départ, une couche d’abstraction et un jeu de tests. Sans eux, le modèle devient lui aussi une décision durable.
Que reste-t-il à décider sur le modèle au démarrage ?
Au démarrage, la question du modèle se réduit à trois éléments : une couche d’abstraction, un jeu de tests et un palier par défaut, le reste se réglant à chaque revue. C’est tout ce qu’elle mérite à ce stade.
La couche d’abstraction isole l’appel et rend le changement trivial. Elle coûte une demi-journée et évite une réécriture au douzième mois, comme développé dans la couche qui rend le modèle remplaçable.
Le palier par défaut se choisit intermédiaire, puis se révise à la baisse là où les tests le permettent. Partir du palier supérieur par précaution coûte cher sans améliorer les tâches qui composent l’essentiel du volume. Le raisonnement par palier plutôt que par marque est développé dans choisir le palier, pas le modèle.
Repère de travail que j’utilise sur mes missions : Une couche d’abstraction, un jeu de tests, et un palier par défaut. Le reste se règle en deux heures à chaque revue. C’est tout ce que la question du modèle mérite au démarrage.
Ce que je dirais à une équipe qui démarre demain
Repère de travail que j’utilise sur mes missions : Passez les deux premières semaines sur le corpus et le périmètre, pas sur le comparatif de modèles. Ce comparatif sera refait trois fois cette année ; les deux autres décisions vous suivront pendant toute la vie du système.
Pourquoi le jeu de tests doit-il être le premier livrable d’un projet d’IA ?
Le jeu de tests devrait être le premier livrable d’un projet d’IA, avant même la première réponse correcte du système, parce qu’il fixe ce que « bon » veut dire. C’est contre-intuitif et c’est ce qui distingue les projets qui avancent : il oblige à répondre à la question du succès pendant que la réponse est encore négociable.
Sur les missions que j’ai menées, mon constat est le suivant : Sur les systèmes que j’ai repris, aucun n’échouait à cause du modèle. Tous échouaient sur l’un des trois autres.
Repère de travail que j’utilise sur mes missions : Sa constitution prend une journée, et il se rembourse à chaque changement de modèle, soit deux à trois fois par an, indéfiniment. La méthode figure dans construire un jeu de tests en une journée. La méthode figure dans construire un jeu de tests en une journée, et son prolongement en production dans l’évaluation continue.
Une objection revient à ce stade : comment définir le succès avant d’avoir vu ce que le système sait faire. Elle est légitime et elle se retourne. C’est précisément parce qu’on ne l’a pas vu qu’on peut encore définir le succès sur le besoin plutôt que sur la performance constatée. Trente cas réels, avec la réponse attendue par une personne du métier, se constituent sans qu’aucun système n’existe.
Comment organiser les premières semaines d’un projet d’IA ?
Les premières semaines d’un projet d’IA s’organisent dans un ordre précis : périmètre, corpus, intégration, jeu de tests, et seulement ensuite le modèle.
- Recenser les cas d’usage et en écarter. Pour chaque cas, nommer un propriétaire métier et décrire un résultat vérifiable ; sinon, l’écarter avec une condition de réouverture.
- Inventorier le corpus des cas retenus. Répondre aux quatre questions de fraîcheur, de version de référence, de droits et de mise à jour.
- Instruire l’intégration. Pour chaque application, identifier le pont possible et sa fragilité.
- Constituer le jeu de tests. Des cas réels, avec la réponse attendue rédigée par une personne du métier, y compris des questions auxquelles le système devra refuser de répondre.
- Poser la couche d’abstraction et choisir un palier par défaut. Le comparatif se fait alors contre le jeu de tests, pas en réunion.
- Fixer la date de la première revue. Le choix du modèle est daté et sera réexaminé .
Cet ordre est celui que suit un audit IA bien mené : il examine les décisions durables avant les décisions réversibles.
Quelles erreurs fréquentes faut-il éviter avant de choisir un modèle ?
Les erreurs fréquentes avant le choix d’un modèle d’IA consistent presque toutes à traiter une décision réversible comme durable, et une décision durable comme un détail. Elles se repèrent facilement une fois nommées.
- Commencer par le comparatif de modèles. Il absorbe les premières semaines et produit une conclusion qui sera périmée à la prochaine sortie.
- Retenir tous les cas d’usage. Le budget se disperse sur des projets sans chance d’aboutir.
- Supposer que le corpus est prêt. Plusieurs versions d’une même procédure, des documents sans date, des droits non définis : ces défauts se découvrent tard s’ils ne sont pas cherchés tôt.
- Choisir le pont d’intégration le plus spectaculaire. Une démonstration par pilotage d’écran convainc en réunion et se révèle fragile en exploitation.
- Choisir le palier supérieur par précaution. La facture augmente sans gain sur l’essentiel du volume, comme le montre l’analyse de la répartition réelle d’un budget d’IA.
Questions fréquentes
Le choix du modèle est-il si peu important ?
Il est important et réversible : il sera repris plusieurs fois dans l’année,. Le cadrage, l’état du corpus et le mode d’intégration suivent au contraire le système toute sa vie. C’est cette différence de durabilité qui justifie de les traiter en premier.
Que doit produire un cadrage ?
Une liste de ce qui est retenu et de ce qui est écarté, avec pour chaque cas écarté une raison et une condition explicite de réouverture. Seule une partie des cas présentés mérite généralement d’être poursuivie.
Quel est le premier livrable ?
Le jeu de tests, avant la première réponse correcte du système. Construit avant, il définit le succès sur le besoin. Construit après, il entérine l’existant et perd toute valeur d’arbitrage.
Comment savoir si un corpus est prêt pour un projet d’IA ?
En répondant à quatre questions : combien de documents et de quand datent-ils, quelle version fait foi, quels droits d’accès s’appliquent et qui signale qu’un document a changé. Si l’une de ces questions reste sans réponse, le corpus n’est pas prêt.
Faut-il partir du modèle le plus puissant pour être sûr du résultat ?
Non. Il vaut mieux partir d’un palier intermédiaire, puis descendre là où le jeu de tests le permet. Le palier supérieur coûte plus cher sans améliorer les tâches courantes qui composent l’essentiel du volume, et une couche d’abstraction permet de monter ponctuellement si un cas le justifie.